AIが既存決定を無視する本当の理由 — ADR文脈自動注入hookの手法
上原正吉(EarthLink Network Co., Ltd.)。Claude Codeを開発の主体に据え、20を超えるプロダクトを1人で同時に開発・運用しています。これは、その現場の実測記です。
AIが既存決定を無視する本当の理由 — ADR文脈自動注入hookの手法
TL;DR(読了時間 約15分)
2026年5月、複数の開発projectへ共通の進め方を届けるClaude Code pluginを改修していました。対象の一つが、過去の設計判断を次のsessionへ知らせる仕組みです。
発端は、文書編集ライブラリの選定でした。あるproductでは、Architecture Decision Record(ADR、設計判断と理由を残す文書)でBlockNoteを採用し、TipTapの直接利用を不採用にしていました。ところが約2週間後の作業で、AIはTipTapを新しく入れる案を出しました。設計記録は存在し、内容も明確でした。欠けていたのは、session開始時にその存在を知らせる経路です。
そこで、作業中projectのdocs/adr/を読み、AcceptedまたはAmendedの文書から番号、題名、状態だけを索引にし、Claude Code hookからcontextへ入れるscriptを作りました。初版はUserPromptSubmitで毎turn実行しました。本文を全件入れず、関連する文書を選んで読むための一覧だけを渡す設計です。
この仕組みを「AIが既存決定へ必ず従う仕組み」とは呼べません。決定論にできたのは、hookが起動し、索引の文字列をcontextへ届けるところまでです。モデルが関連文書を選ぶか、本文を読むか、判断へ従うかは別です。違反率が何%下がったかも測っていません。
運用後の改訂も必要でした。7月には毎turnの重複注入をやめ、SessionStartへ移しました。8月には121ファイルを個別commandで読む実装を1回のawkへまとめ、計測中央値を3,842msから94.7msへ縮めました。9月にはcompactとresumeで全索引を再注入せず、短い参照案内だけを入れるようにしました。
2026年9月28日の現行実装では、ADRファイル144件のうち、文書上でAcceptedまたはAmendedなのは135件です。しかしhookは- Status:形式しか読まず、別形式の29件を落として106件だけを認識します。そのうち起動時に出るのは上限30件、3,510 byteで、compact時は262 byteです。発端になったproductは29件中27件が対象で、全件表示されました。規模が増えると、解析形式と上限の両方で判断が索引から外れます。
作ったのは、設計判断を次のsessionへ渡すpluginです
このplugin群の目的は、仕様作成、review、test、deploy確認などの進め方を、複数の開発projectで共通利用できるようにすることです。人が毎回同じ説明を貼るのではなく、Claude Codeのskillやhookとして登録し、必要な場面で動かします。
ADRも同じ問題を持っていました。設計判断を文書に残すと、人は後から検索できます。しかし、新しいAI sessionは前の会話をそのまま引き継ぐとは限りません。repositoryに100本の文書があっても、読む対象としてcontextへ現れなければ、モデルにとっては未発見のままです。
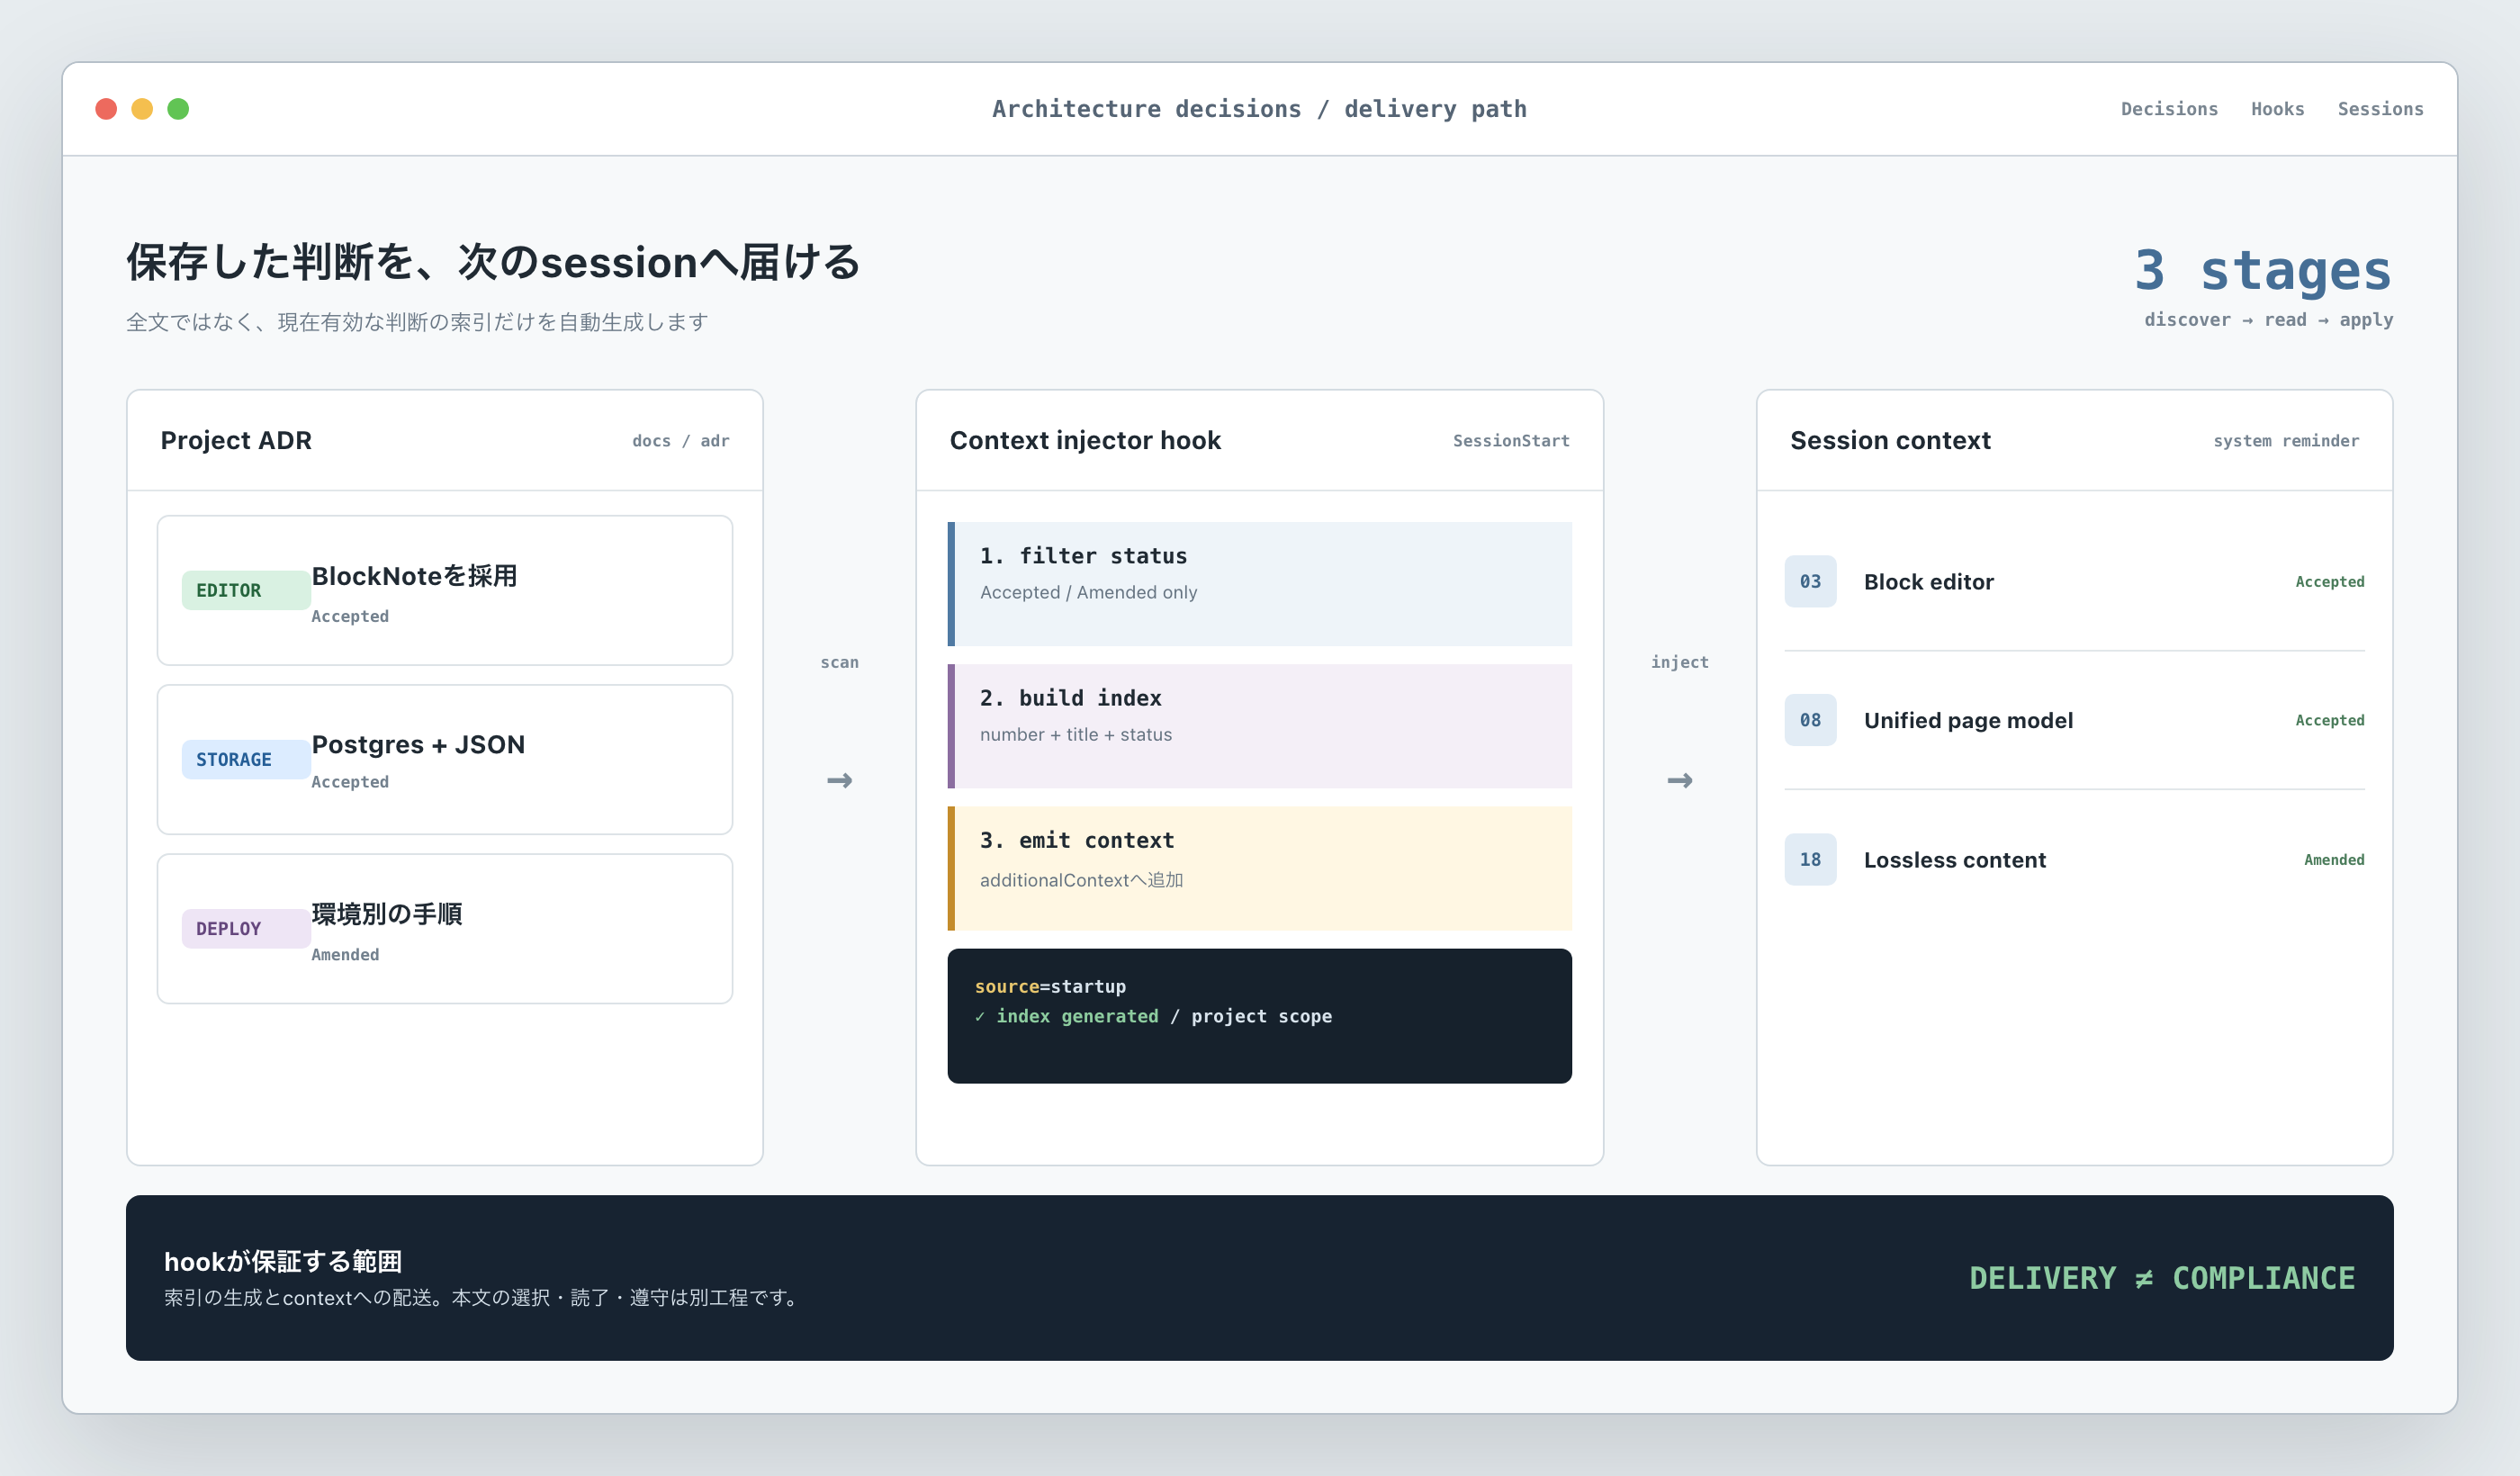
必要だったのは、全文検索の代替ではありません。次の3段階を分けることでした。
- 存在を届ける: 現在有効な設計判断の一覧をcontextへ入れます。
- 関連文書を読む: 作業内容に関係するADR本文を選びます。
- 実装へ反映する: Decisionと制約を差分やtestへ落とします。
今回のhookが担当するのは1だけです。2と3まで同じ仕組みで保証したと書くと、実装より広い成果を主張することになります。
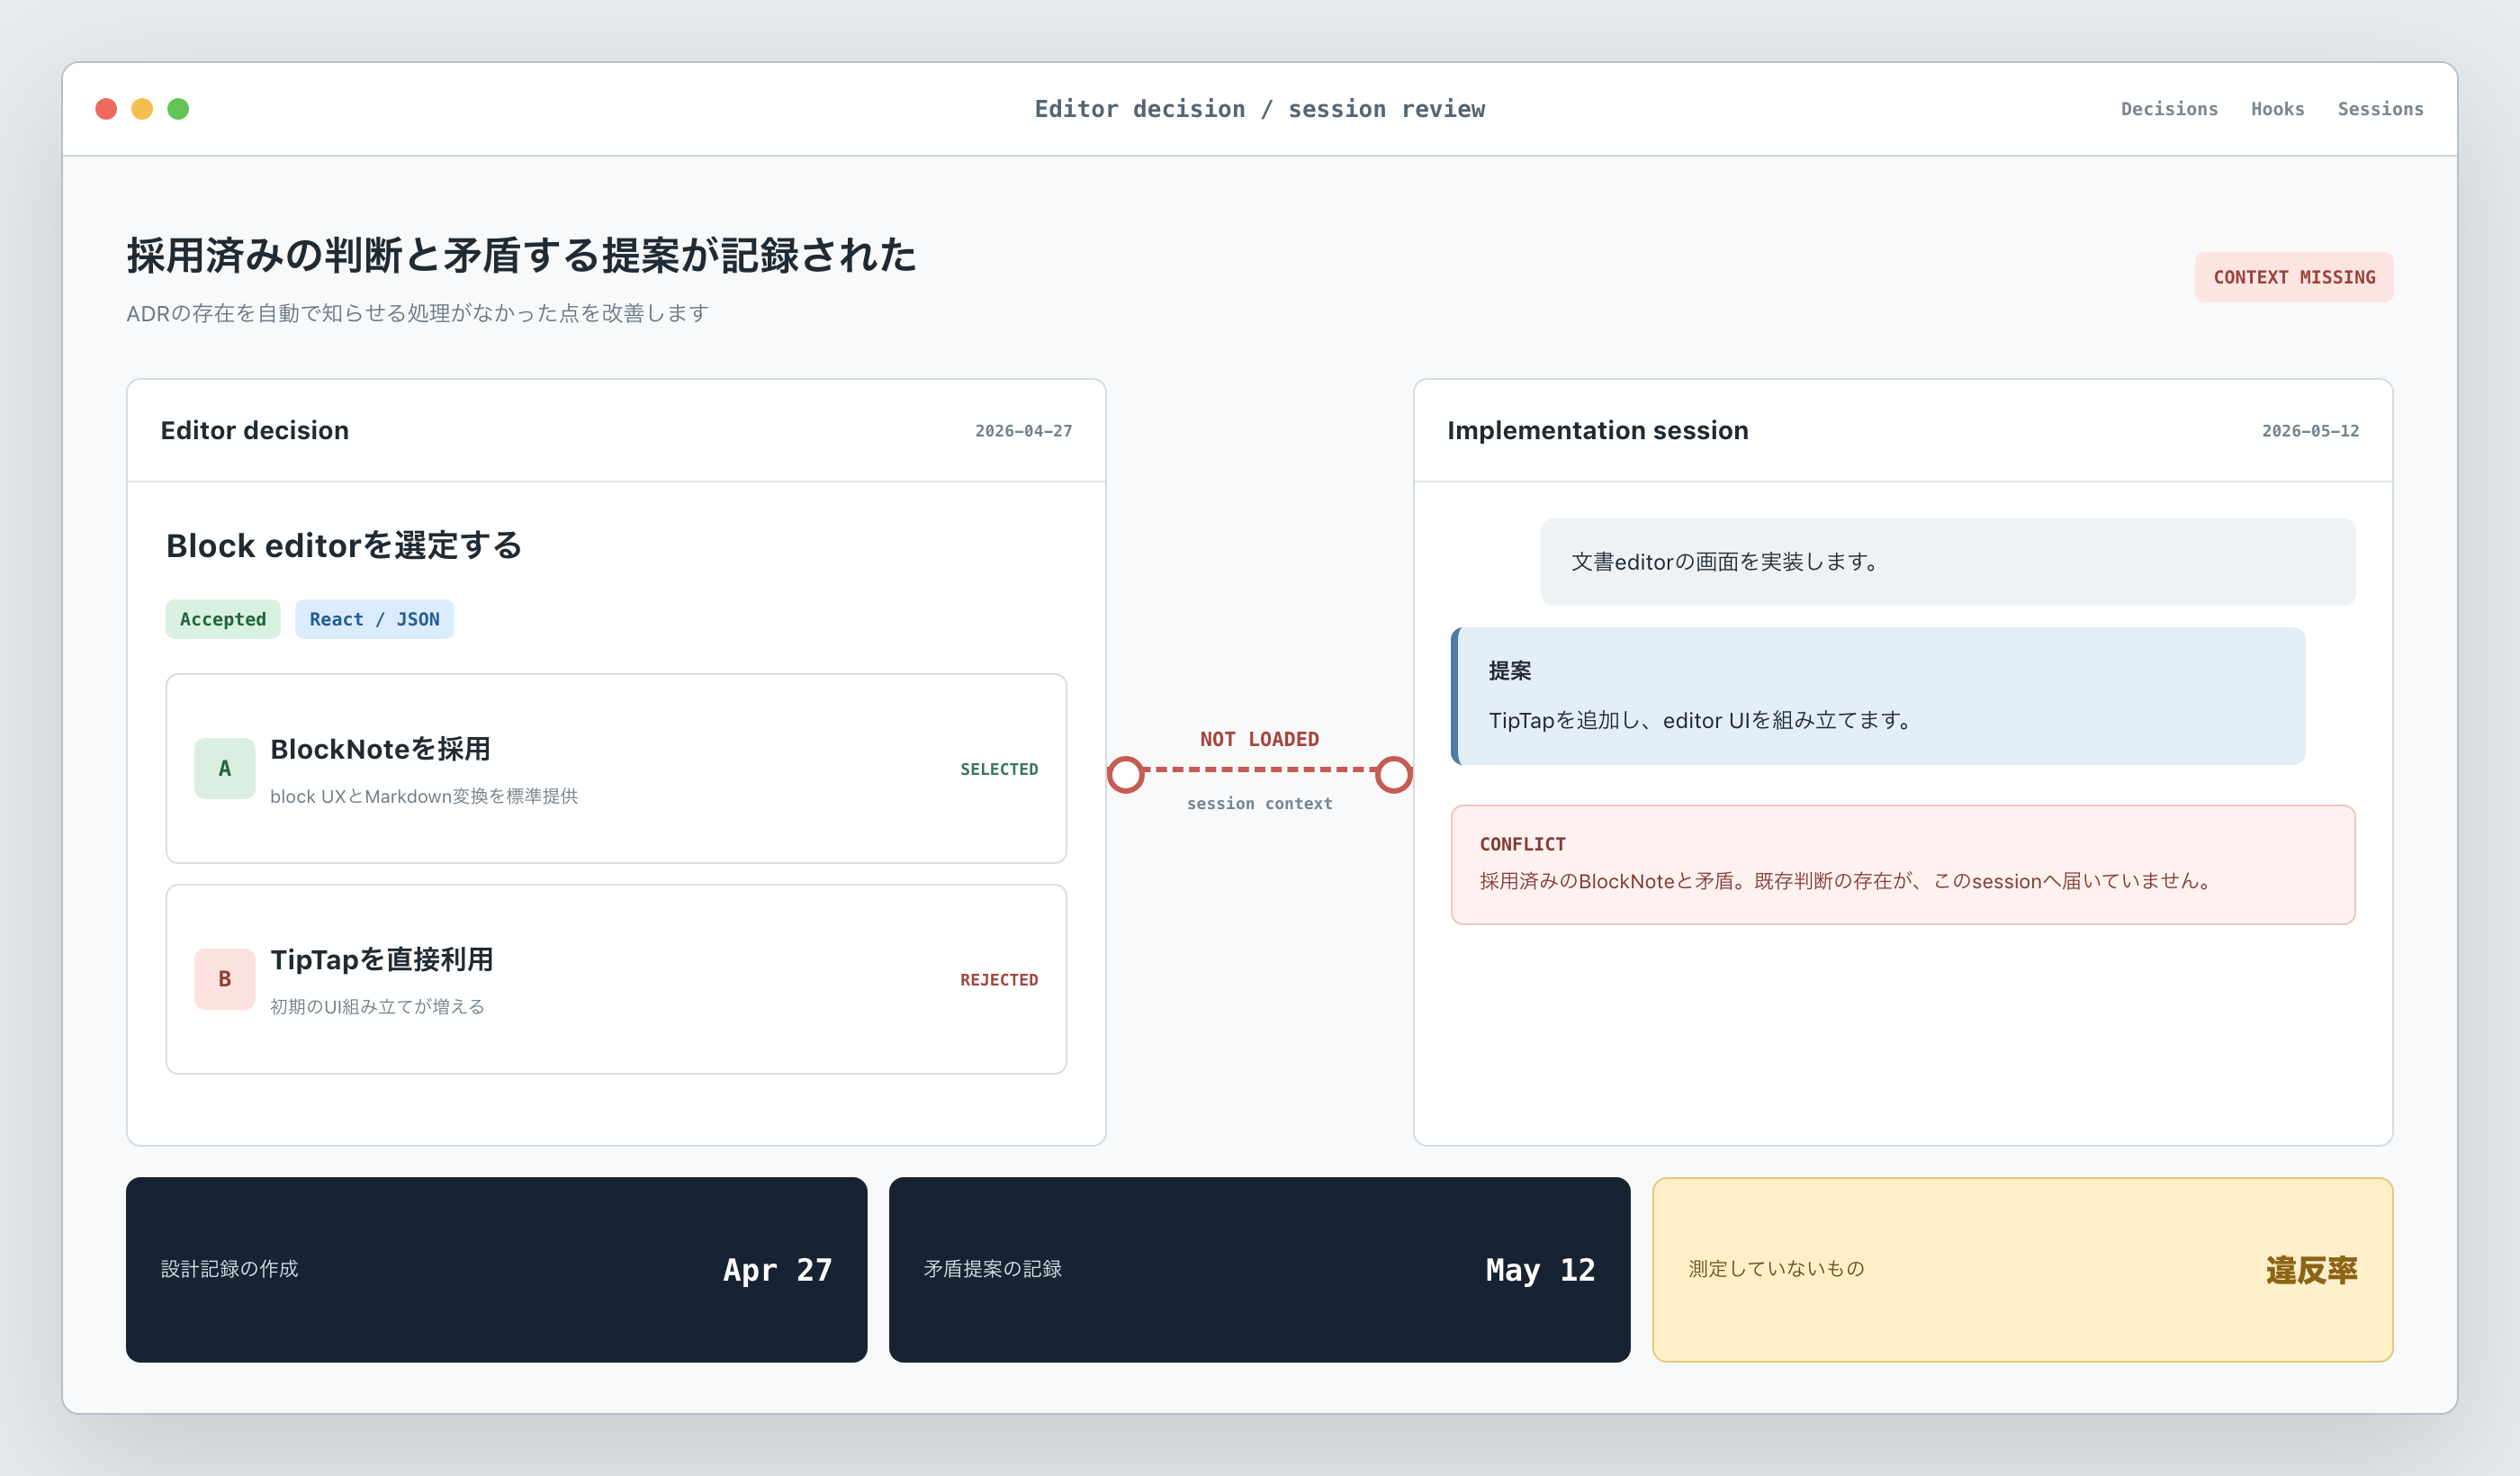
採用済みのBlockNoteに対し、TipTapが再提案されました
発端になったproductは、メモや文書を自分で書ける機能を作っていました。ここで必要になるのは、文字の装飾や見出し、箇条書きなどを画面上で扱えるrich text editor(文書を編集する画面部品)です。候補のBlockNoteとTipTapは、どちらもReactの製品へこの編集機能を組み込むためのライブラリで、BlockNoteは内部でTipTapを使っています。2026年4月27日付の設計記録では、BlockNoteをblock editorの基盤として採用しています。この設計記録をrepositoryへ追加したのは翌28日です。
要求は、Notionに近いblock操作、Markdownの貼り付けとコピー、JSONでの保存、Reactへの組み込みでした。TipTapの直接利用も比較しましたが、slash menu、drag handle、indent、Markdown変換を自分で組み立てる必要があります。BlockNoteはこれらの操作を最初から持っていたため、要求との差が小さいBlockNoteを選びました。
5月12日、別の画面を検討していたsessionで、AIがTipTapを入れる案を出しました。この事象は同日作成したcontext injectionの設計記録に残っています。元の会話transcriptそのものは今回の確認資料に含まれていないため、発言の細部までは再現しません。確認できるのは、既存のeditor選定と矛盾する提案が発端として記録され、その日にhook実装が始まったことです。
二日後の5月14日には、元の判断どおりBlockNote 0.34を使う最小editorが実装されています。最終的なcodeは既存判断へ戻りました。ただし、人が気付いて戻せたことと、AIが最初から判断を発見できたことは違います。
原因を「モデルが忘れた」で終わらせませんでした
当時の設計記録は、原因候補を4つに分けています。
- ADRはdirectoryに置かれているだけで、明示的に読む操作がなかった
- 長いproject指示の中に「ADRを確認する」と書いても、作業時に参照されない場合があった
- 具体的な実装依頼では、既存判断の確認より提案が先に進んだ
- 「実装時に確認する」のような条件付き指示は、該当しないと解釈される余地があった
ここで「recency bias(新しい情報ほど重視してしまう偏り)が原因だ」と科学的に確定したわけではありません。複数条件を変えた比較実験も、違反率の集計もありません。確認できた構造上の欠落は、ADRの存在を各sessionへ入力する処理がなかったことです。
タイトルの「本当の理由」は、この1事例で判明した範囲を指します。すべてのAIが文書を参照しない一般原因ではありません。文書の品質が悪かった可能性も、別のprojectで同じ対策が同じ効果を持つかも、この記録だけでは決められません。
それでも、改善箇所は具体化できます。「ADRを確認してください」という文章を増やすのではなく、確認対象の一覧を実行時に作り、Claude Codeがmodel requestへ追加できる形式で返します。
全文ではなく、現行判断の索引だけを入れました
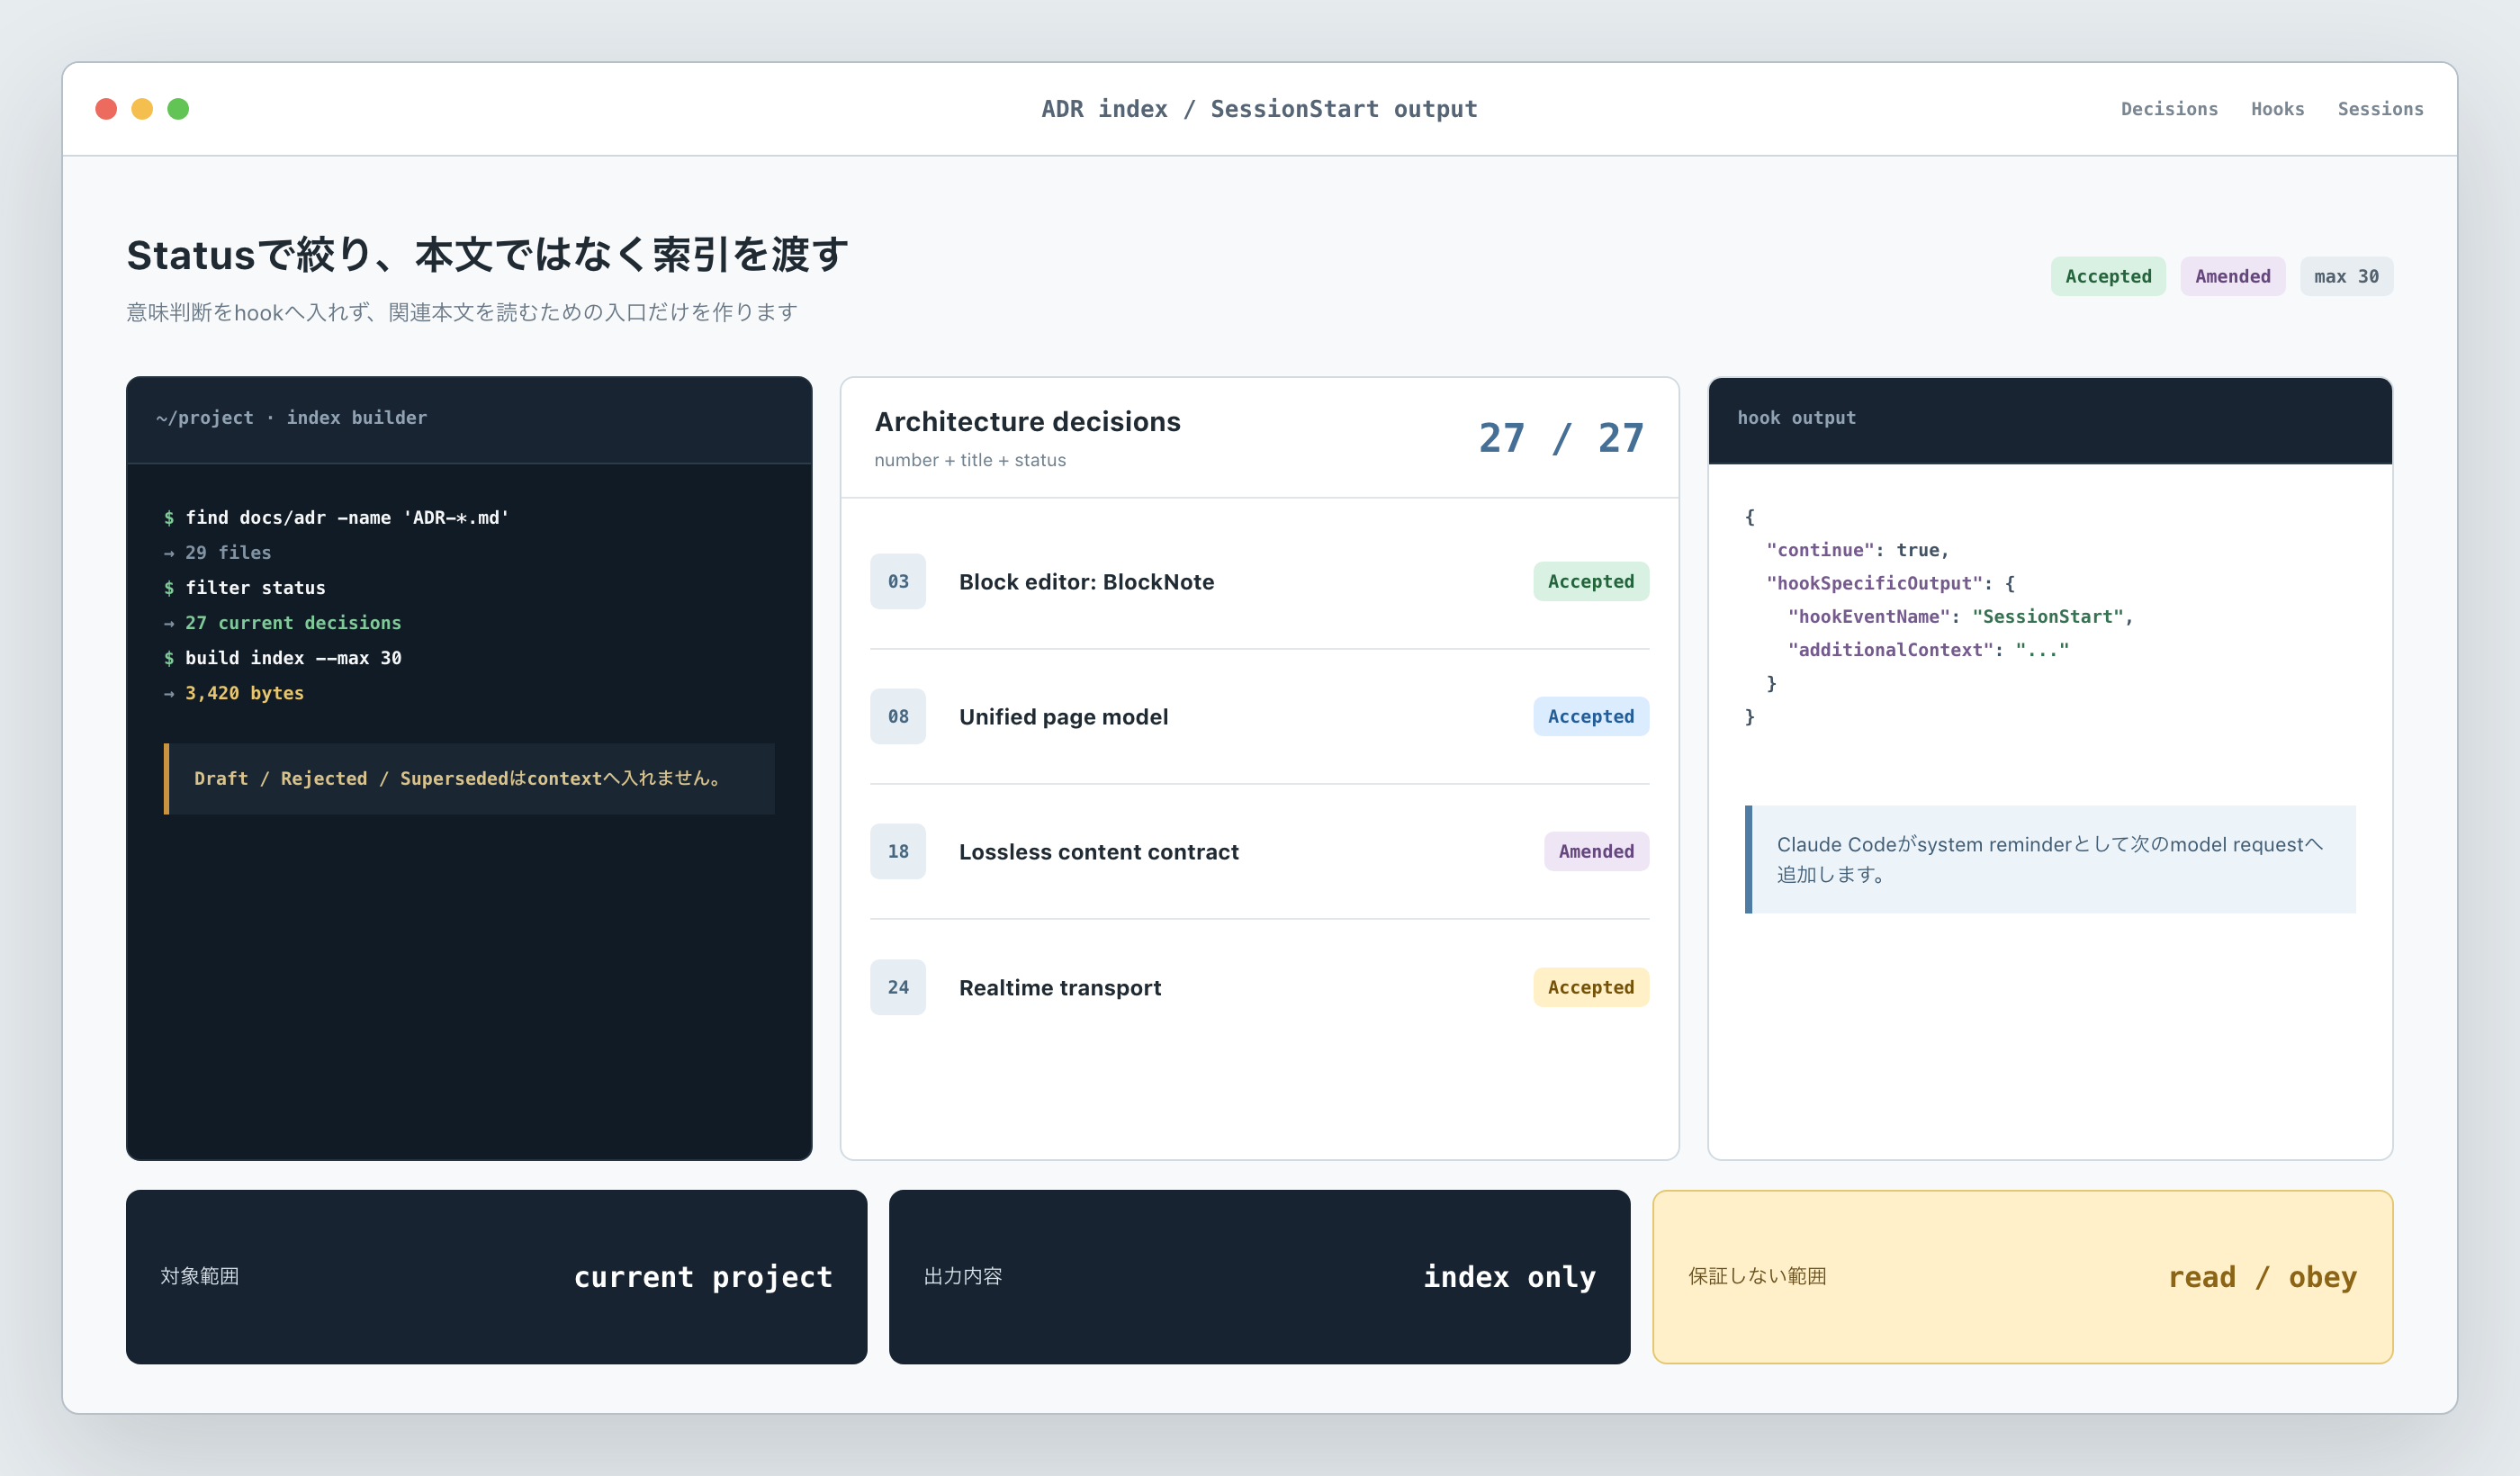
初版の処理は次の順でした。
- 作業projectのrootを決めます。
docs/adr/直下からADRファイルを集めます。- 各ファイルの見出しとStatusを読みます。
- AcceptedまたはAmendedだけを残します。
- 番号、題名、状態を最大30件まで出します。
- Claude Codeのcontextへ追加します。
Draftは未確定、Rejectedは不採用、Supersededは置き換え済みです。これらを同じ一覧へ混ぜると、モデルが現在の制約と古い案を区別できません。対象projectのdirectoryだけを見るのは、別productの判断を誤って持ち込まないためです。
本文を全件入れなかった理由は情報量です。初版の予算は20件で約500 token、30件上限で約750 tokenでした。索引には「何が決まっているか」だけを載せ、詳しい理由は必要なADRを読んで取得します。
現在のClaude Code hook公式文書でも、UserPromptSubmitはprompt送信ごと、SessionStartは開始や再開時に動くeventとして定義されています。hookが返すadditionalContextはsystem reminderとしてcontextへ入り、次のmodel requestで読まれます。初版は、この公式の拡張点を使いました。
初版のreviewで、3つの実装不良が見つかりました
発想が正しくても、最初のscriptはそのままでは安全ではありませんでした。初版のPull Requestは5ファイル、273行追加、1行削除です。自動reviewが2回入り、計3件の実装不良を指摘しました。
最初は、30件への切り詰めをStatusのfilterより前に行っていました。先頭30件にRejectedが混ざると、後ろにある有効なADRが表示されません。修正後は、全件を解析し、AcceptedとAmendedだけを残してから30件へ切ります。
二つ目はproject rootのfallbackです。環境変数がない場合にhook script自身のdirectoryを基準にしていました。pluginの設置場所を見ても、利用中projectのADRは見つかりません。環境変数、現在directoryのgit root、現在directoryの順へ直しました。
三つ目は内部delimiterです。番号、題名、状態を|で区切ると、題名自体に|がある場合に列が壊れます。tab区切りへ変え、題名内の記号と空白を維持しました。
3件ともmerge前に修正されています。この履歴から得られるのは「hookなら確実」という単純な結論ではありません。hookの起動はmodel判断を通りませんが、scriptの実装不良は通常のcodeと同じように起きます。fixture、review、実行結果の確認が必要です。
決定論にできた範囲は、文字列の配送までです
初版の設計記録は、hookを「決定論的」と表現しています。この言葉は範囲を付けないと誤解を招きます。
Claude Codeがeventを発火し、pluginが有効で、scriptが正常終了すれば、一覧生成はmodelの自発判断に依存しません。AcceptedとAmendedのfilter、上限、出力形式もshell scriptで決まります。ここまでは同じ入力に同じ処理を適用できます。
その後は違います。索引を見たmodelが関連ADRを選ばない場合があります。選んでも本文を読まない場合があります。本文を読んでも、今回の作業へどう適用するかを誤る場合があります。初版で予定されていた「keywordから関連Decisionを抜く第2段階」と「Write/Edit前にADR読了を要求する第3段階」は、現行のこのhookには実装されていません。
さらに、jqがない環境ではsilent skipします。docs/adr/がないprojectでも何も出しません。plugin自体が有効でなければhookは動きません。設計判断の配信経路は作れましたが、すべての環境で常に届く保証ではありません。
この境界を明記しておくと、成果測定も変わります。見るべき値は少なくとも次の三つです。
- hookが対象sessionで起動した割合
- 関連ADR本文を実際に読んだ割合
- 既存判断と矛盾する提案が修正前後で何件あったか
今回の履歴には、この三つを継続集計したdataがありません。導入後の違反率低下を成果として書かない理由です。
2か月後、毎turnの注入をやめました
初版はUserPromptSubmitへ登録され、userがpromptを送るたびに同じ索引を入れました。新しい指示の近くに一覧が来る利点はあります。しかし、30件なら約750 tokenを毎回使います。20 turnなら同じ一覧を20回送ることになります。
2026年7月15日付の改訂で、登録先をSessionStartへ変更しました。実装がmergeされたのは翌16日です。索引はsession開始時に1回入り、そのcontext内に残るため、毎turnの再送をやめました。plugin versionは初版の0.4.0から、この改訂で0.21.0になっています。
代わりに弱くなる点もあります。session途中で追加したADRは、次の開始まで自動反映されません。また、長いsessionでは、開始時に入れた一覧と現在のやり取りの間に多くのturnが挟まります。モデルが一覧を参照する頻度への影響は測っていません。この改訂は「最新性を保ったままcostだけ消した」ものではありません。再送costを減らすために、session途中で追加したADRの即時反映と、新しい指示のすぐ近くに一覧を置く利点の両方を手放した判断です。
現在のClaude Codeでは、SessionStartは起動時だけでなくresume、clear、compact、forkでも発火します。そのため「sessionにつき厳密に1回」という説明も十分ではありません。後のcompact対応は、このevent特性から必要になりました。
ファイル数が増え、開始処理そのものが遅くなりました
頻度を減らした後も、script内部のcostが残りました。初版はADRごとにgrepやsedを複数回起動していました。2026年8月の監査時には121ファイルがあり、開始1回で約1,100 processを作る構造になっていました。
同じ入力を10回測った記録では、旧実装の中央値は3,842ms、最小でも2,236msでした。全ファイルを1回のawkで読む実装へ変えると、中央値94.7ms、最小71.4msになりました。およそ40倍です。見出し、Status filter、30件上限、出力は維持しています。
索引の文字数だけを減らしても、生成に数秒かかればsession開始を遅らせます。context costとprocess costは別に測る必要がありました。
compact後は、全索引を入れ直さないようにしました
2026年9月には別の問題が見つかりました。Claude Codeはcontextをcompactした後にもSessionStartを発火します。縮めた直後に3KBを超える一覧を再注入すると、減らしたcontextをまた増やします。
現行hookは入力のsourceを見ます。startupとclearでは通常の一覧を返し、compactとresumeでは「必要ならADR directoryを確認する」という短いpointerだけを返します。2026年9月28日に現在のcodeを実行した結果は次の通りです。
| source | 出力 | 実測byte | ADR行 |
|---|---|---|---|
| startup | 最大30件の索引 | 3,510 | 30 |
| clear | 最大30件の索引 | 3,510 | 30 |
| compact | 再確認先だけのpointer | 262 | 0 |
| resume | 再確認先だけのpointer | 261 | 0 |
| fork | 最大30件の索引 | 3,510 | 30 |
現行hookはcompactとresumeだけをpointerへ変え、forkを含むそれ以外のsourceは通常一覧にします。この分岐を確認する回帰testは、ADR索引hookと作業記録hookの2つを対象に計13件あり、すべて通りました。このうちADR索引hookの検証は7件で、空projectではpointerも出さない、sourceがなければ安全側で通常一覧を出す、といった境界を含みます。残り6件は作業記録hook側の検証で、「短い本文よりpointerの方が大きい場合は縮めない」境界はそちらで確認したものです。fork固有のtest caseはまだありませんが、2026年9月28日に公式仕様と現行scriptを照合し、fork入力で30件・3,510 byteの通常一覧になることを実測しました。
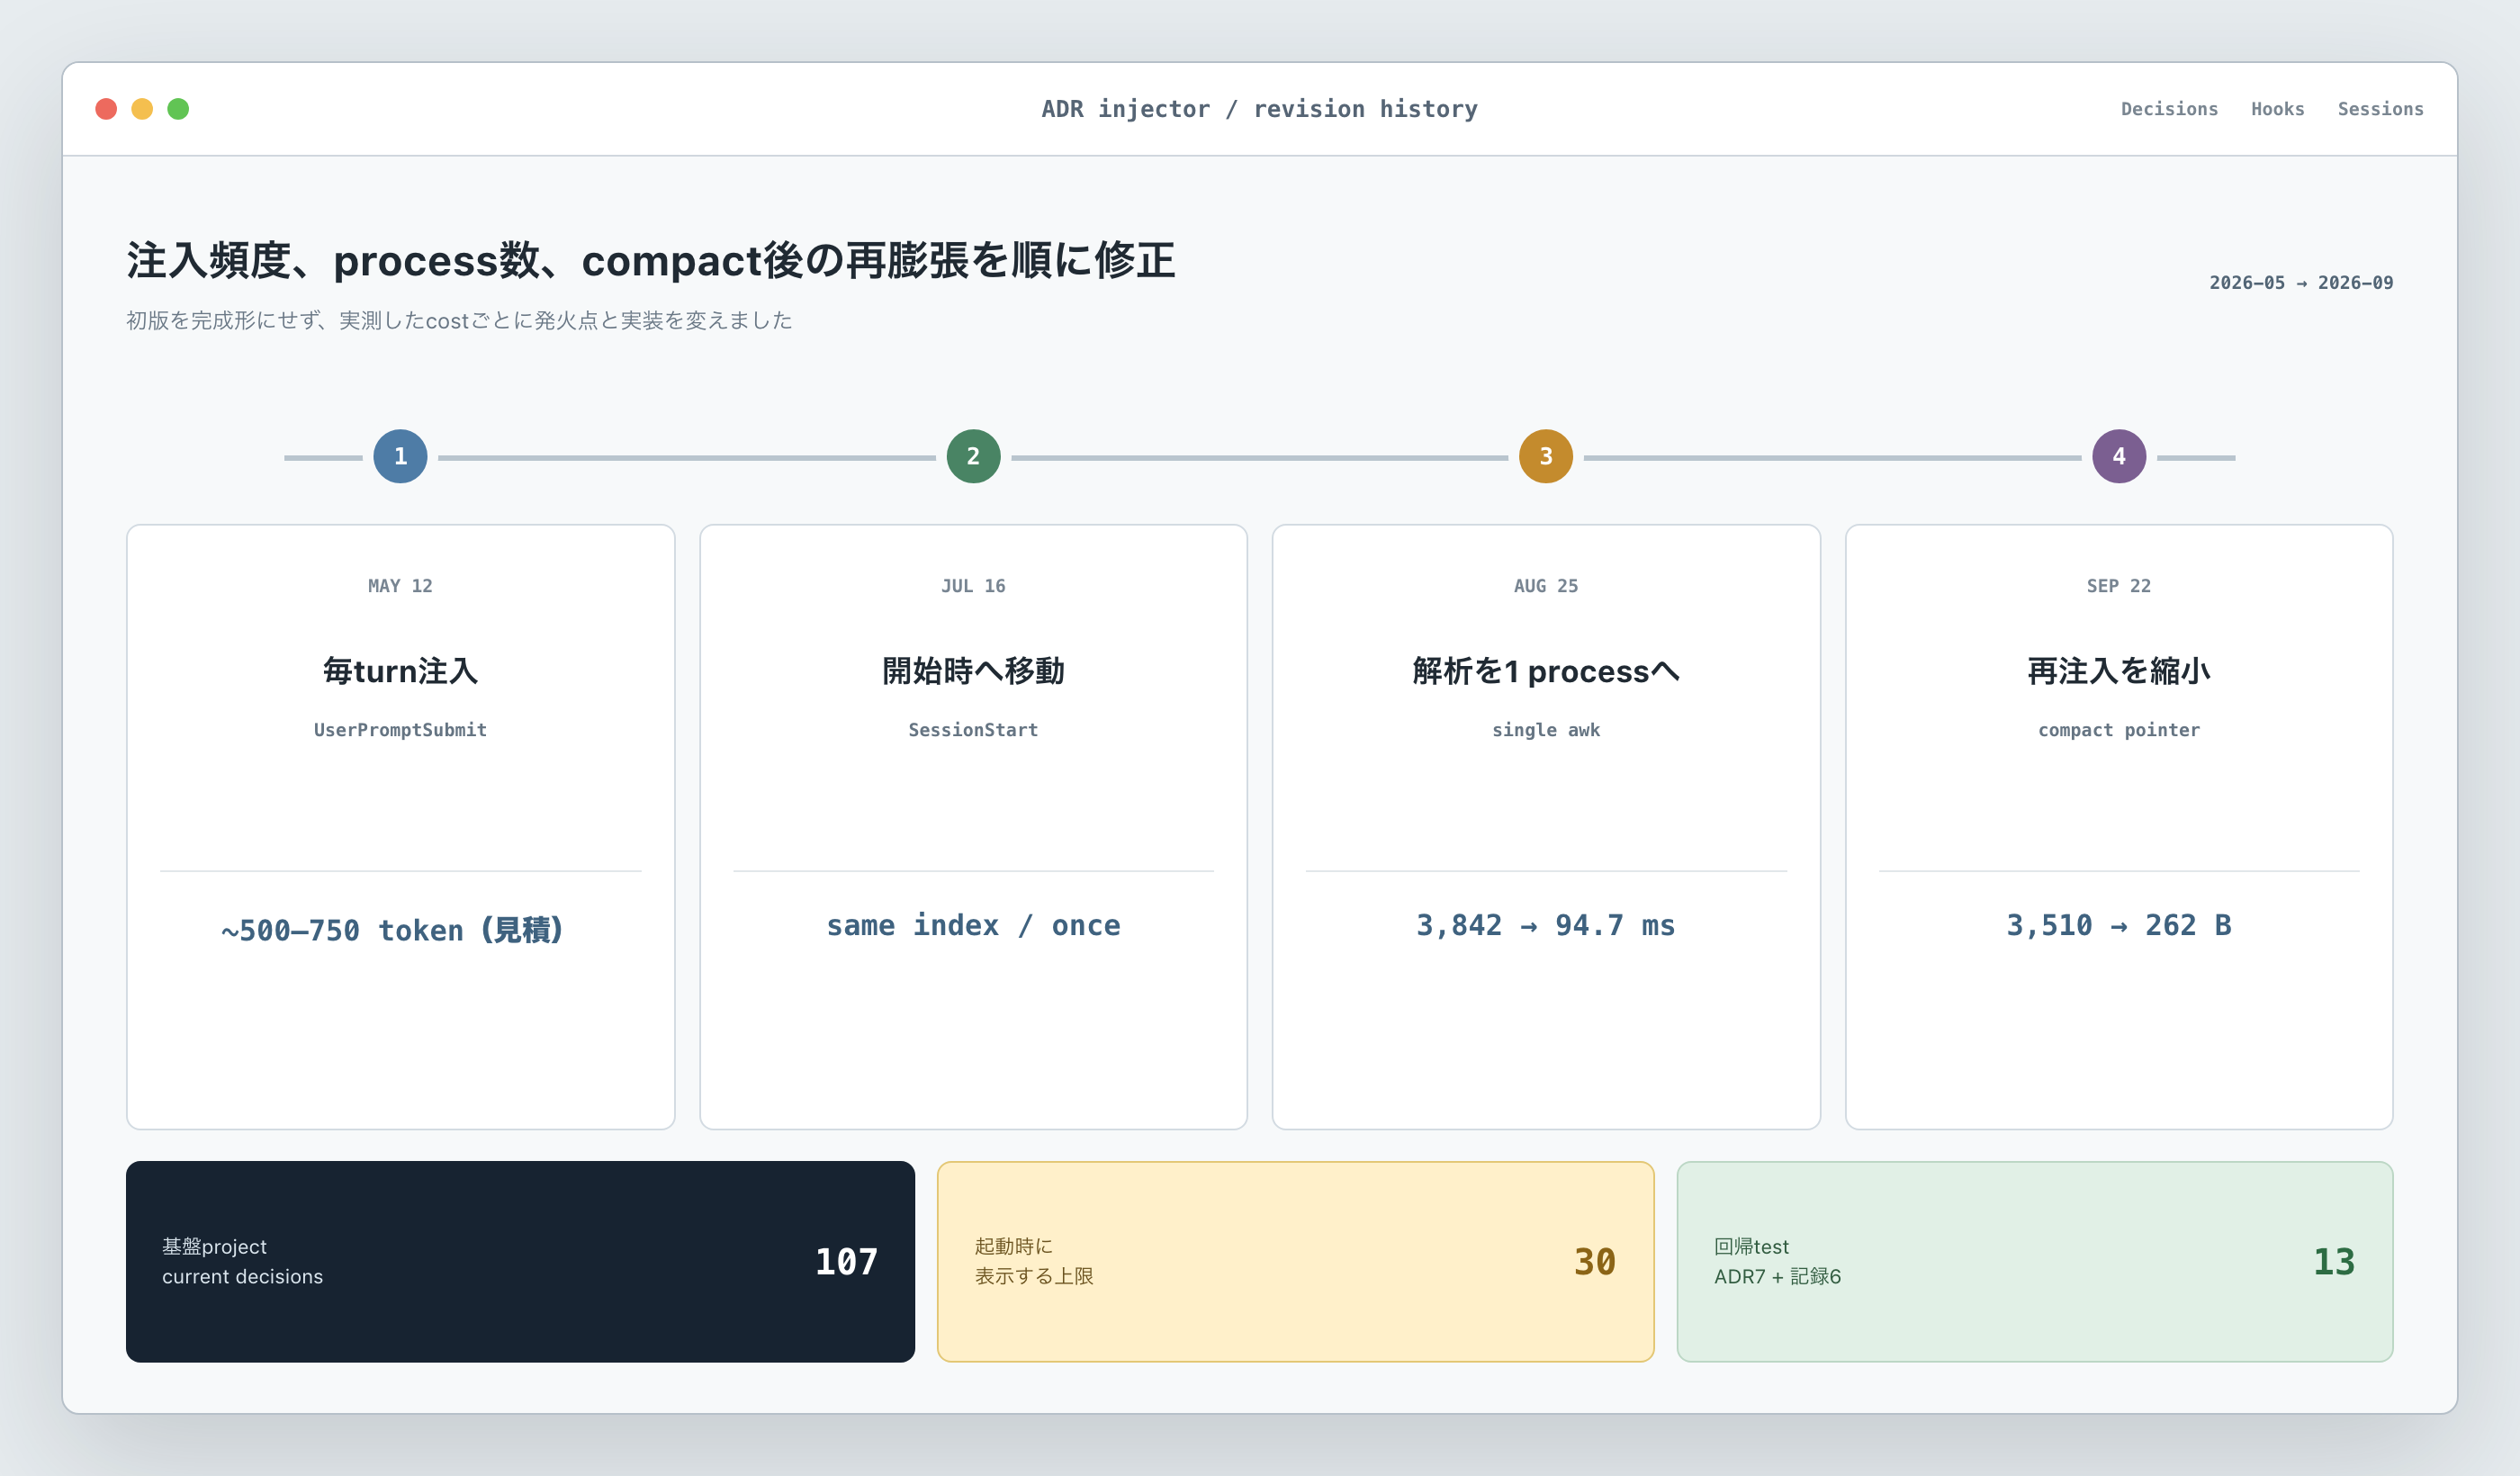
現在は30件上限が次の問題です
2026年9月28日時点で、このpluginを開発するprojectにはADRファイルが144件あります。文書上のAcceptedまたはAmendedは135件ですが、hookが認識するのは106件です。**Status**:などの29件はparserが取りこぼし、認識後も76件が上限で一覧から外れます。脱落は「解析漏れ」と「上限」の2種類です。
発端になったproductは29ファイル中27件が対象で、現状は全件表示できます。同じ実装でも、project規模によってcoverageが変わります。「上限がある」だけでなく、「どの判断が見えなくなるか」が番号順で決まる点が問題です。新しいADRほど後ろにあるため、最近の判断が外れやすくなります。
別の不整合も残っています。実装の登録先はSessionStartで、設計記録のStatusはAmendedです。一方、component READMEには今もUserPromptSubmitで毎turn動くと書かれ、上位の文書索引にはStatusがAcceptedと残っています。codeと説明の更新が同期していません。記事では実際のhooks.jsonとscriptを現在値として扱いました。
次に直すなら、30件を単純に増やすだけでは足りません。全件を入れればstartupのcontextが増え、compact対策と逆方向へ進みます。domain別索引、変更日の新しい判断を含める規則、作業keywordから候補を機械抽出する方法などを、誤って必要な判断を落とさないtestと一緒に設計する必要があります。
この実装から残す設計境界
この4か月で残った判断は、hookを増やすことではありません。
- 文書保存、存在の通知、本文読了、実装遵守を別の段階として扱います。
- hookは、一覧生成やevent発火のように意味判断を要しない処理へ使います。
- modelが選ぶ工程を「決定論」と呼びません。
- 注入量だけでなく、発火頻度、process数、compact後の再注入を測ります。
- 上限を設けた場合は、件数だけでなくcoverageを確認します。
- code、登録設定、設計記録、READMEの現在値を突き合わせます。
索引を入れる仕組みは、最初の事故に対する有効な修正でした。少なくとも、設計判断の存在をmodelの自発的なdirectory探索だけに任せる状態は変えられます。
同時に、初版の説明より狭く評価する必要があります。現在の実装は本文を読みません。30件より後ろを表示しません。違反率を測っていません。compact後はpointerだけです。この制約を含めて、初めて再利用できる設計になります。
結論
BlockNoteを採用した文書があるのにTipTapが提案されたとき、問題は文書の有無ではありませんでした。そのsessionへ判断の存在を知らせる処理がありませんでした。
対策として、現行ADRの番号、題名、状態をproject内で生成し、Claude Code hookからcontextへ入れました。AIが気付いてくれることを待つ経路から、毎回同じscriptで一覧を作る経路へ変えています。
ただし、保証できるのは配送までです。関連本文の選択と遵守は別に確認します。毎turnの再送はSessionStartへ変え、121ファイルの個別processは単一awkへまとめ、compact後は262 byteのpointerへ縮めました。そして今は、認識した106件のうち30件しか見えない上限と、Status表記の違いで29件を取りこぼす解析漏れが残っています。
設計記録は、書いた時点では終わっていません。次のsessionにどう発見されるか、何件まで見えるか、本文を読んだことをどこで確認するかまで設計して、運用に使える状態になります。
この ELN workflow(AI開発の品質を仕組みで守る自社プラグイン)についての記事は、考え方・スキルの中身・実際に防いだ事故を、順次シリーズとして公開していきます。 興味のある方は、ぜひ「いいね」と記事の購読をお願いいたします。
自社プロダクトの一覧は https://www.eln.ne.jp/products にまとめています。
筆者について
上原正吉。EarthLink Network Co., Ltd. でAI開発をしています。2025年からClaude Codeを開発の主体に据え、今は20を超えるプロダクトを1人で同時に開発・運用しています。この連載では、その現場で実際に起きたこと(うまくいったことも、失敗も)を、数字と一緒に書いていきます。
また、AIで業務や開発を組み替えたい会社・チーム向けに、AI活用のコンサルティングも受け付けています。ご相談は www.eln.ne.jp からどうぞ。
EarthLink Network は、会社の全業務を AI で回すために、必要になったものを自社で作っています。いま作っているプロダクトの一覧と概要は、こちらにまとめています。
→ EarthLink Network が自社でつくっている18のプロダクト
会社と各プロダクトの詳細は、公式サイト www.eln.ne.jp をご覧ください。