良かれと入れた監視が、正常なAIサーバーを落とした
上原正吉(EarthLink Network Co., Ltd.)。Claude Codeを開発の主体に据え、20を超えるプロダクトを1人で同時に開発・運用しています。これは、その現場の実測記です。
良かれと入れた監視が、正常なAIサーバーを落とした
結論(この記事の要点・読了 約8分)
自宅のLLM(Large Language Model、文章を生成するAIモデル)基盤で、監視のやり方を一度変えて、同じ日に元へ戻しました。
追加したのは、実際にモデルへ1文字だけ生成させて、その応答で「使えるかどうか」を見分ける能動的な監視です。ねらいは、プロセスは生きているのに推論だけ返さない状態を捕まえることでした。ところが、正常な推論に約31.8秒かかる環境へ、10秒で見切る設定を当ててしまいました。この条件では、正常な4台のうち3台を接続先から外します。
- 正常でも数十秒かかる推論に、正常応答時間より短い能動的な監視は使えません。「遅いが正常」と「止まって返らない」を見分けられず、正常な実行機を落とすからです。
- 最初の問題——ステータスは200を返すのに推論だけ止まる状態——は、結局「本物のユーザー依頼」で捕まえました。こちらから探りを入れる能動監視をやめ、実際に流れている依頼のうち、120秒を超えても返らない、または500番台のエラーを返すものが直近8件で続いたら、その台を接続先から外します。詰まった
/api/chatは、叩きに行かなくても本物の依頼がそのままタイムアウトして現れるからです。生存確認は軽い/api/version(0.25秒)に戻し、「生きているか」と「処理が詰まっていないか」を別々の監視に分けました。 - 能動という手段を捨てたわけではありません。現に生存確認は今も能動で叩いています(
/api/versionを定期的に叩く軽い監視)。捨てたのは「遅い推論を能動で試す」プローブだけです。応答が速い処理を実際に叩いて確かめる監視はこれまでどおり有効で、前提が崩れるのは推論という「正常でも遅い処理」を能動で測るときだけです。
以下、何を監視していて、どこで見誤り、どう戻したかを順に書きます。
何を監視していたか
LLMの推論を回すための小さな基盤があります。140億パラメータ(14B、モデルの規模を表す数)の分類用モデルを載せたMacを4台並べ、その前段にCaddy(Webサーバー兼リバースプロキシ。届いた通信を後ろの機械へ振り分ける役)の負荷分散機能を置いています。届いたリクエストを、生きているMacへ順番に流します。
分類用モデルというのは、来た依頼が「どの種類の作業か」を仕分ける小さな役です。重い文章生成は別のレーンに任せ、この4台は軽い仕分けだけを速くこなします。1台あたりの処理は軽いので、数をそろえて並列で捌く。なぜ自前で並べているのか、どう組んだのかは別の記事に書きました。ここでは監視の話に絞ります。
4台を束ねている以上、どれか1台が不調になったときに、そこへリクエストを送り続けてはいけません。不調な機械を接続先から自動で外し、直ったら戻す。この見分けをどうやるか、が今回の主題です。振り分ける側のCaddyが、後ろの4台それぞれの状態を定期的に確かめ、使える機械にだけ通信を流す。その「確かめ方」を、今回わたしは一度作り替えて、すぐ元へ戻しました。
症状 — 生きているのに答えない
実行機がハングして、推論だけ応答しなくなることがありました。タイトルのwedgeは、この「詰まって返らない」状態を指します。
厄介なのは、機械そのものは動いて見えることです。バージョンを返す/api/versionという軽い問い合わせは0.25秒で答えます。しかし推論を担う/api/chatは返りません。プロセスの生存だけを見る監視は、この実行機を「正常」とみなし、リクエストを送り続けます。利用者から見れば、依頼だけが吸い込まれて返ってこない状態です。
気づいたきっかけは、全体としては応答が返っているのに、一部の依頼だけがいつまでも返らない、というムラでした。負荷分散は生きている4台へ順番に流します。そのうち1台が詰まっていると、その台に当たった依頼だけが返らない。初回の計測でも、生存確認は0.25秒で返るのに、同じ実行機の推論は時間切れになる、という食い違いを観測しました。プロセスは生きている。でも仕事はしていない。生存だけを見る監視では、この差を捕まえられません。
詰まりは、複数の重い依頼が同じ台に重なったときや、しばらく使われていなかった台に急に依頼が来たとき(cold な状態)に起きやすいものでした。モデルはメモリに載せ直すところから始めるので、その間の依頼は待たされます。負荷分散は生きている台へ機械的に流すだけなので、詰まっている台にも次の依頼を送り続けます。詰まった台に依頼が積み上がり、その台に当たった利用者だけが待たされ続ける。これを止めるには、詰まりを見て接続先から外すしかありません。
Web通信で「200」という応答(Hypertext Transfer Protocol、HTTP=Web通信の約束事で「成功」を表す番号)が返ることと、中身が正しく動くことは別だ、という話は以前の記事でも書きました。今回はそれを、推論という「正常でも遅い処理」に当てはめたときに何が起きるか、という続きです。
最初の対策 — 推論そのものを測る
そこで、「準備完了かどうか」を、実際に推論させて測ろうと考えました。/api/chatへ最小のリクエストを送る、能動的なプローブ(探りを入れるための小さな要求)です。生存確認では捕まえられない wedge を、推論を1回させてみることで直接あぶり出す、という発想でした。プロセスが生きているかではなく、仕事ができるかを直接聞く。狙いとしては素直です。
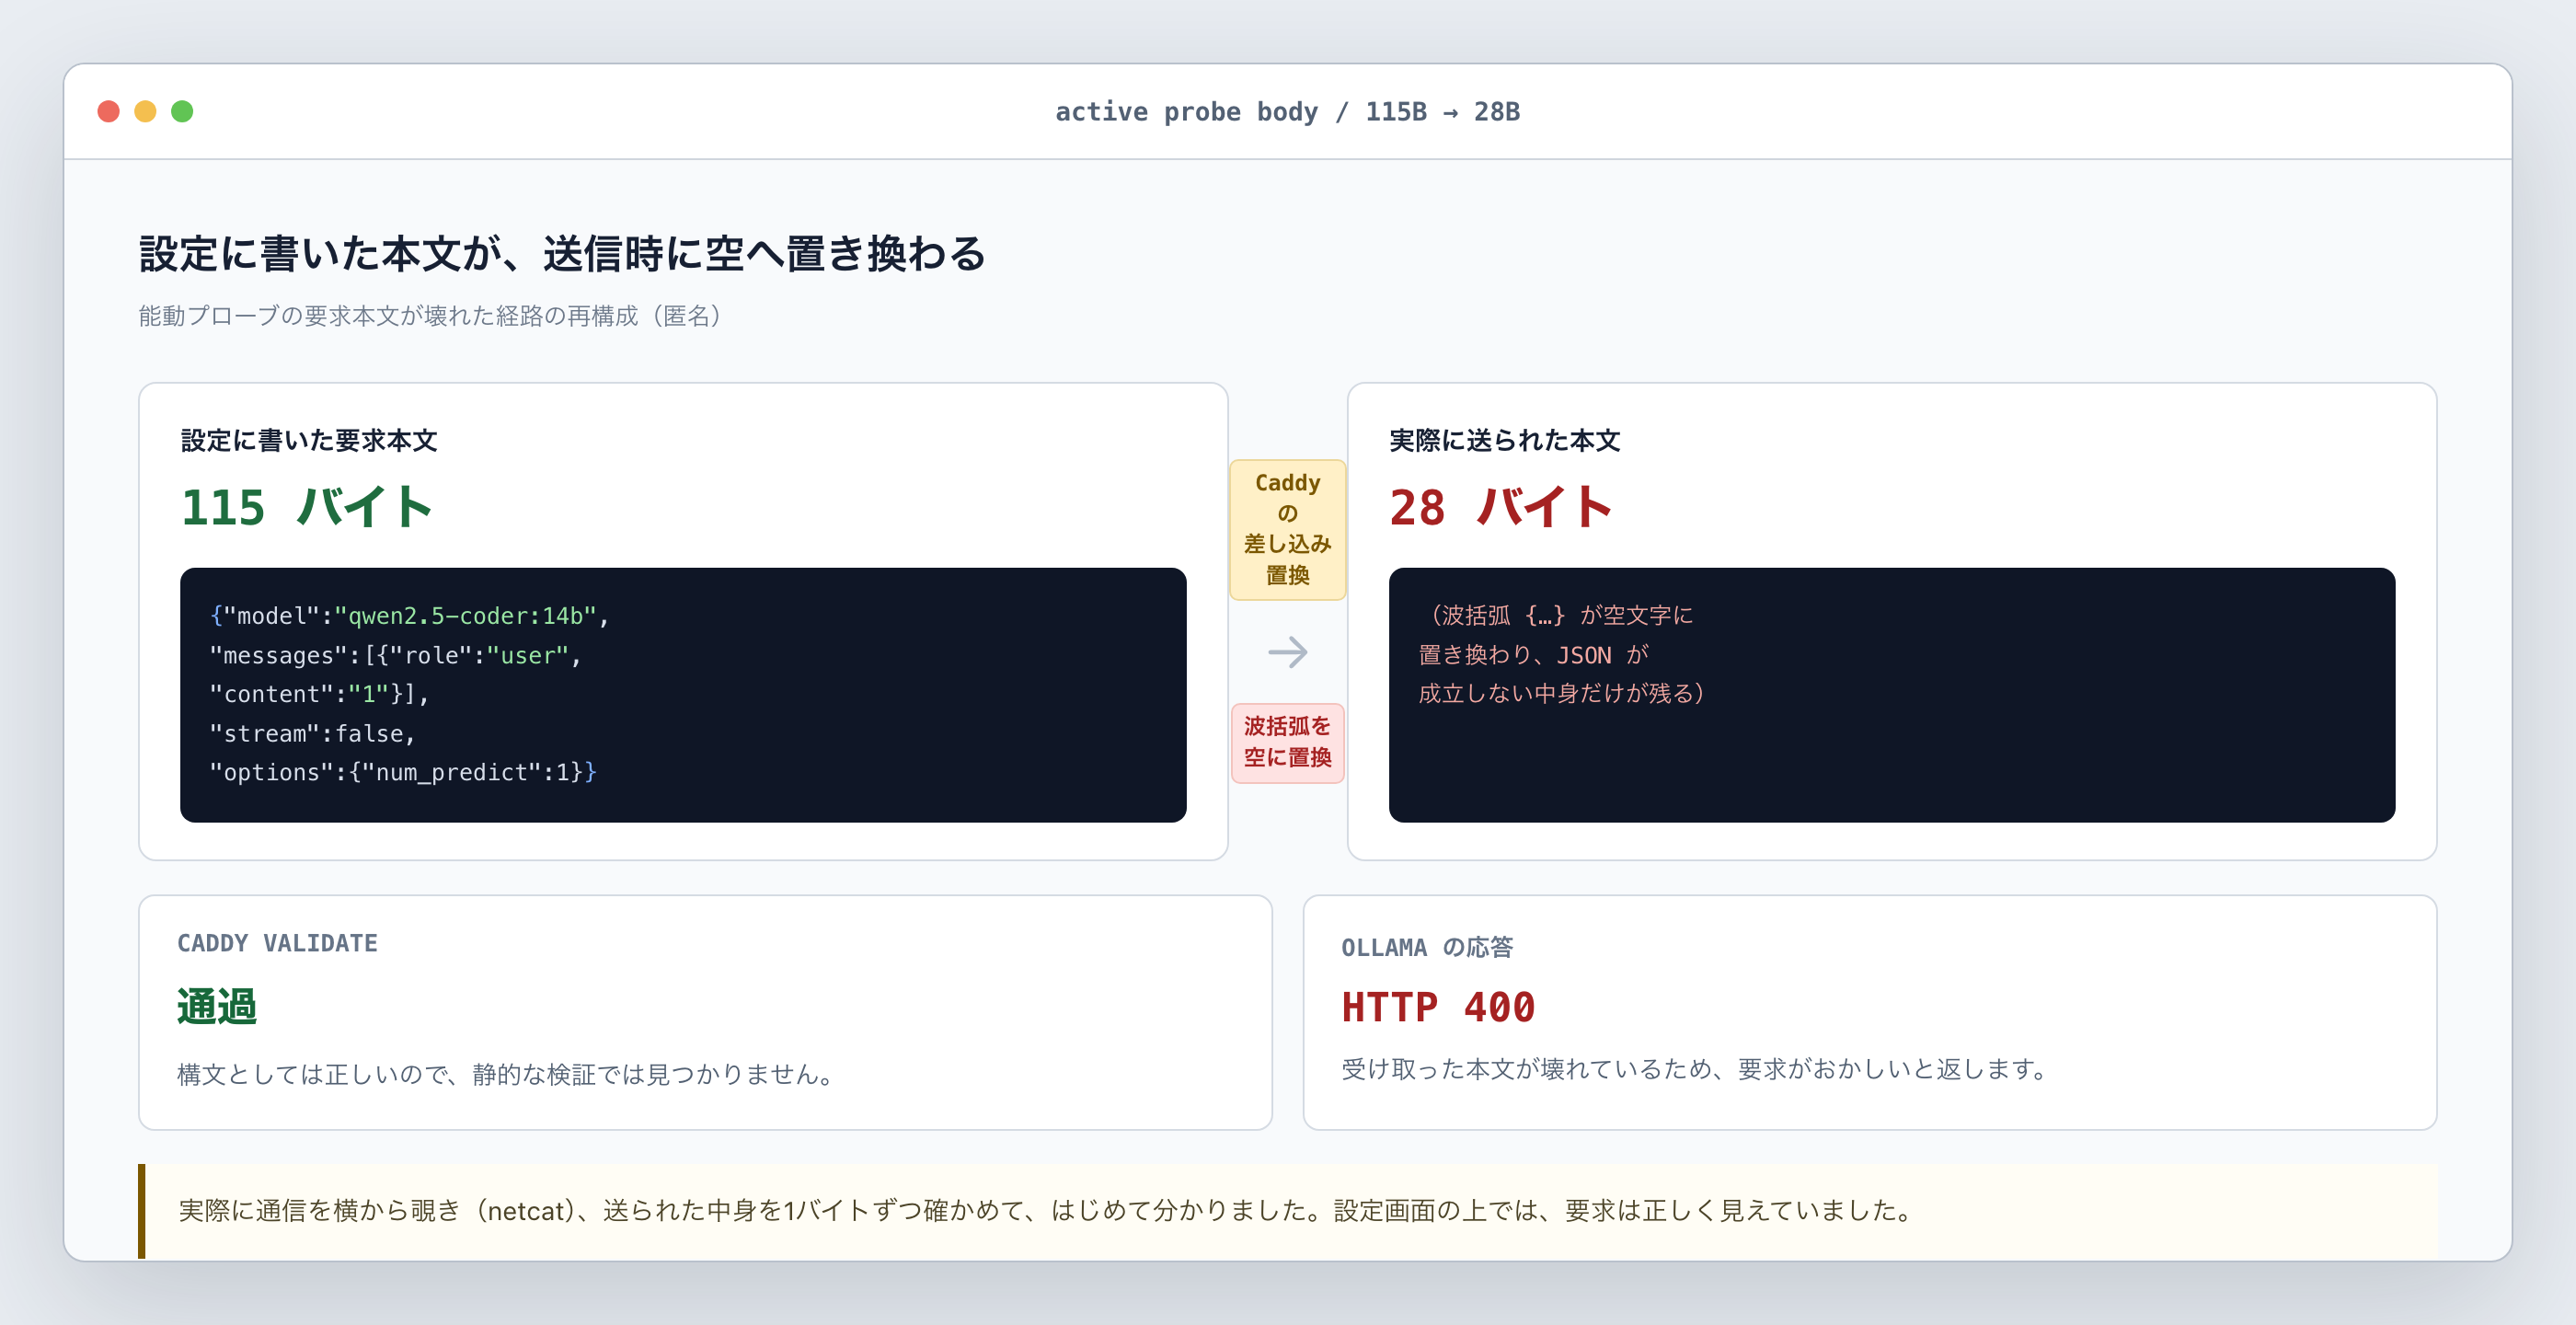
送る中身はこうです。分類モデルに1トークン(生成の最小単位。ここでは1文字ぶん)だけ作らせる、115バイトの短いリクエストにしました。
{"model":"qwen2.5-coder:14b","messages":[{"role":"user","content":"1"}],"stream":false,"options":{"num_predict":1}}
見分けはCaddyの機能で組みました。15秒ごとにこのリクエストを送り、10秒で時間切れとし、3回続けて失敗したらその実行機を接続先から外す。1回でも成功すれば戻す。応答にmessageという項目が返れば成功とみなす、という設定です。10秒という時間切れは、Webの接続口を見張るときの相場から置いた値でした。
反映の前には、Batsという設定用のテストを12件と、Caddyの構文検証(caddy validate)を通しました。前提もいくつか実環境で確かめています。生存確認が0.25秒で返ること、能動プローブの通信がCaddyからMacへ届くこと、応答のmessage項目で成否を見分けられること、テストと構文検証が通ること。この4つは確認しました。ただ、本番の推論にかかるレイテンシという最後の前提だけは、相場の10秒を置いたまま、実測で詰めきれていませんでした。準備は整ったつもりでした。
実環境で崩れた — 3つの誤算
反映して、すぐに崩れました。誤算は3つあります。
第1に、正常な推論が10秒を超えました。14Bのモデルは、混雑しているときや起動直後(cold、モデルがまだメモリに温まっていない状態)には、1トークンだけの生成でも約31.8秒かかります。これはハングではなく、正常な動作です。モデルをメモリに載せ、これまでのやり取りを計算し直すためで、num_predict=1、つまり1文字だけ求めても短くなりません。処理の重さは、出す文字数ではなく、モデルを動かす準備のほうに乗っているからです。とりわけ、しばらく休んでいた台に最初の依頼が来たときは、モデルをメモリへ読み込むところからやり直すので、いちばん時間がかかります。4台へ確認したところ、3台が10秒を超えました。この基準では、正常な接続先の大半を外してしまいます。
ここが今回のいちばんの肝です。能動的なプローブは「返ってくるのが遅い」を「止まっている」と同じに扱います。応答の速い接続口なら、遅い=異常でおおむね合っています。ところが推論では、遅い=正常なことが普通にあります。だから同じ物差しが使えません。正常な機械を、監視のほうが落としてしまう。守るための仕組みが、守る相手を減らしていました。
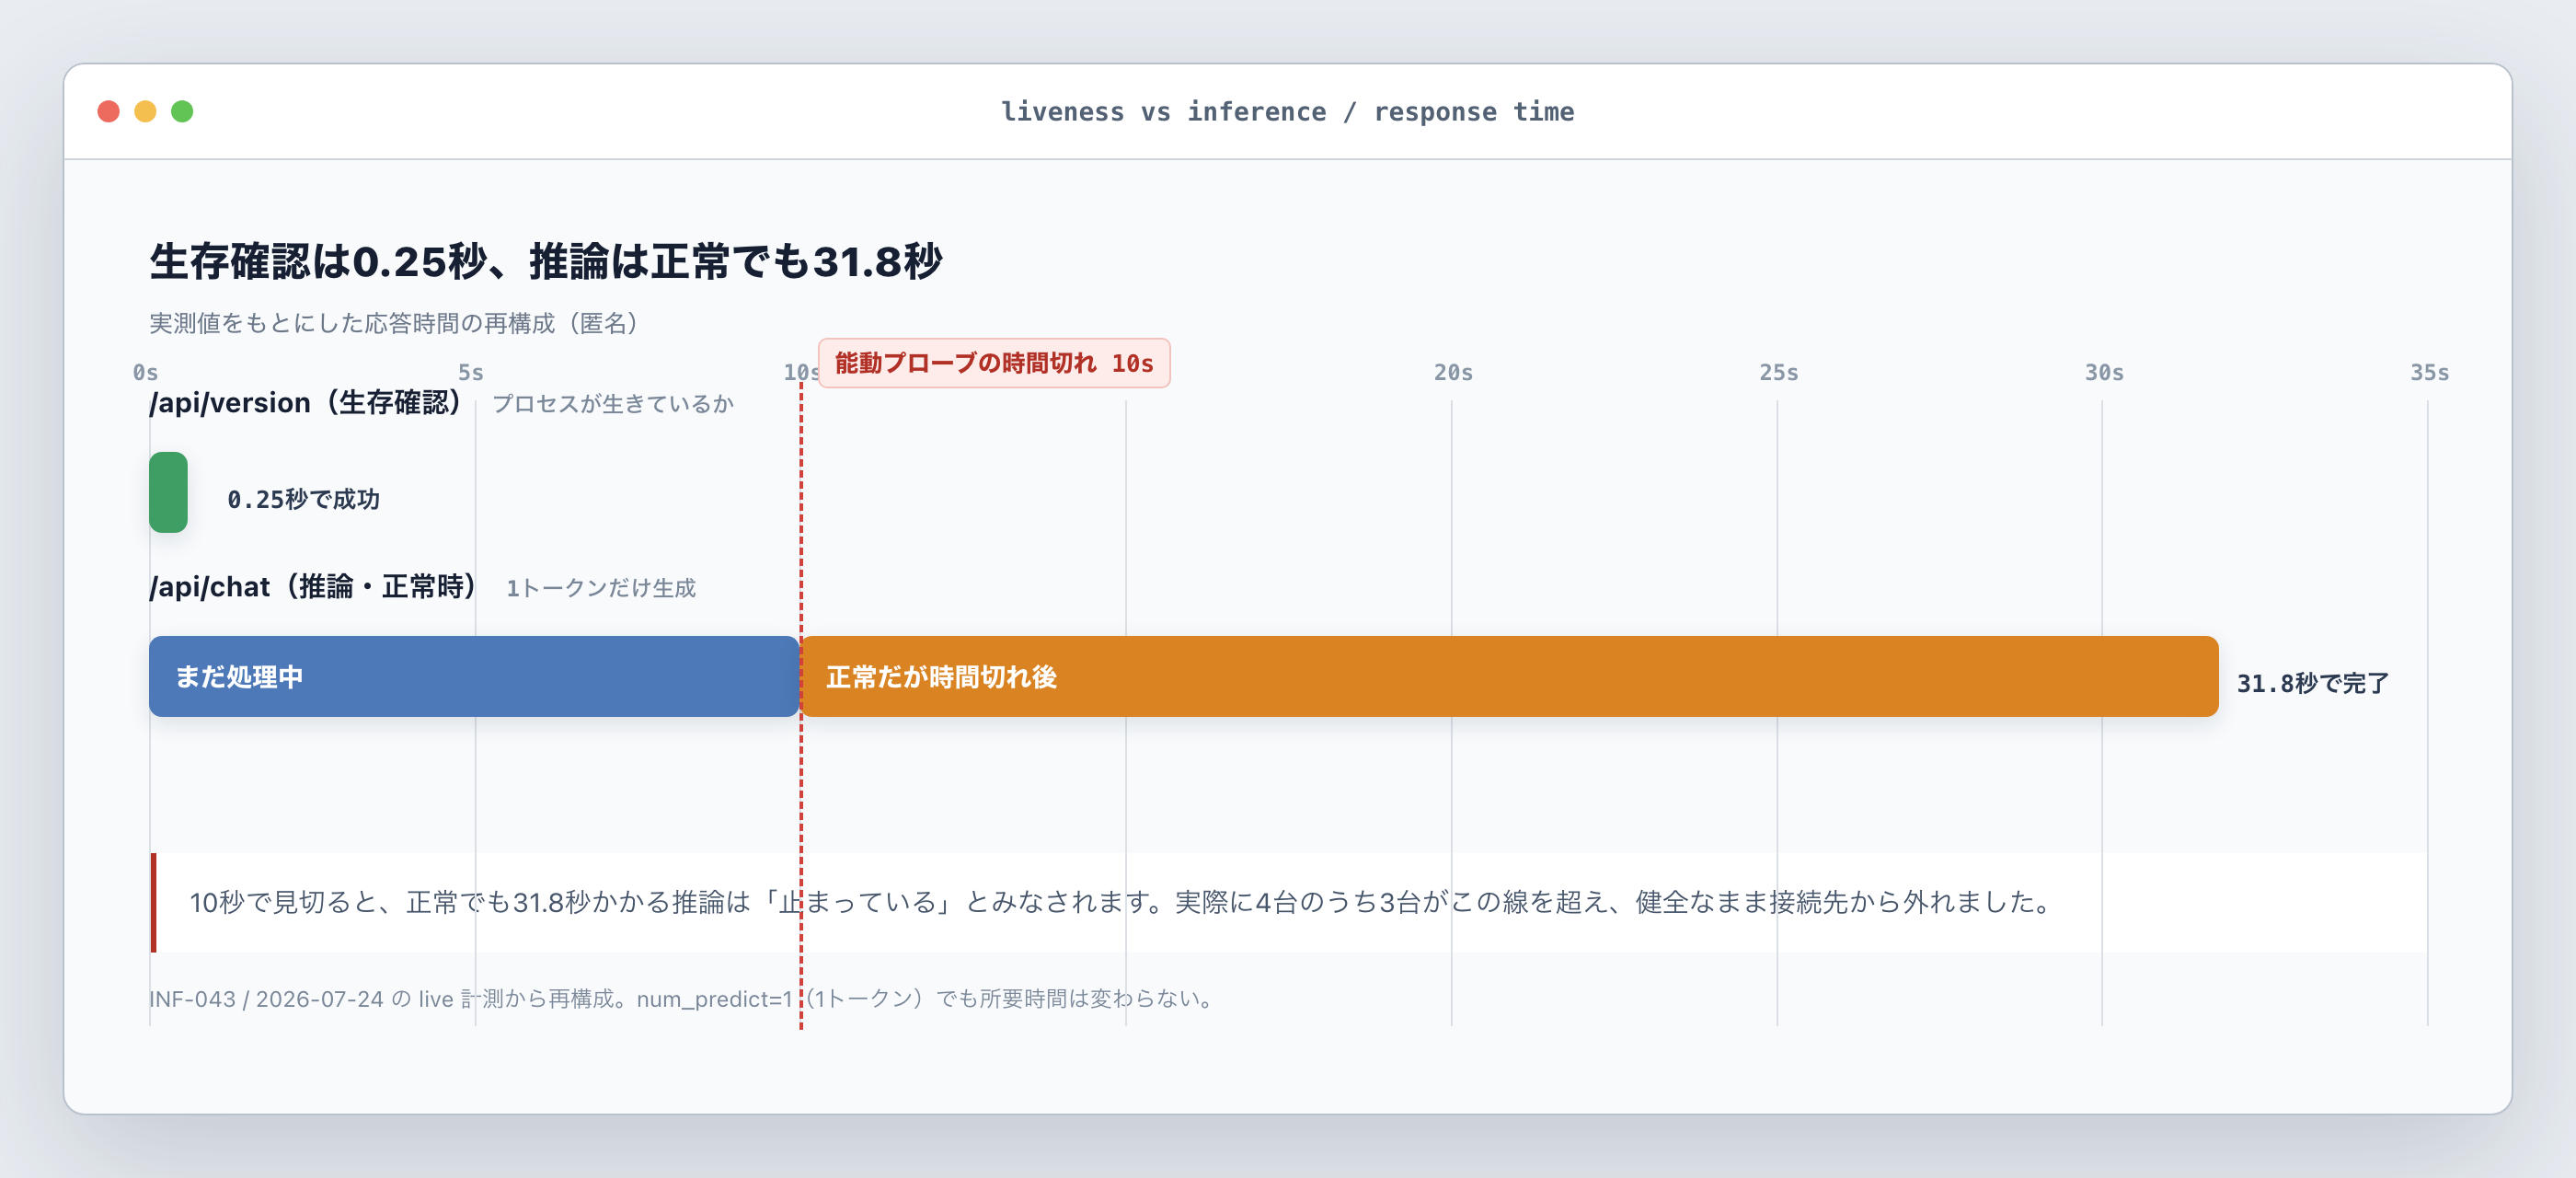
第2に、時間切れを延ばしても、この問題は消えません。10秒を60秒にすれば、正常な機械は外れなくなります。でも今度は、本当に詰まった実行機を60秒間も生きていると見なします。「遅いが正常」と「永遠に返らない」の境目を、時間の長さだけでは引けないのです。閾値をどこに置いても、片方の誤りが増えるだけでした。長くすれば正常な機械は守れるが検知が鈍る。短くすれば検知は速いが正常な機械を巻き込む。この綱引きから、時間の物差し1本では抜けられませんでした。
第3に、設定に埋め込んだリクエスト本文が、そのまま送られませんでした。Caddyは設定内の文字列に、実行時の値を差し込む置換の仕組みを持っています。このとき、先ほどのJSON(JavaScript Object Notation、データを書き表す形式)の波括弧{...}が「差し込むべき値の指定」と誤って解釈され、空の文字列に置き換わりました。115バイトのはずが28バイトになり、受け取ったOllama(LLMを手元で動かすためのソフト)は、要求が壊れているとしてHTTPの400(「要求がおかしい」を表す番号)を返しました。
この壊れ方がcaddy validateでは見つからないのが、さらに厄介でした。構文としては正しいので、静的な検証は通ってしまいます。実際に通信を横から覗いて、送られた中身を1バイトずつ確かめて、はじめて分かりました。設定を書いた画面の上では、リクエストは正しく見えていたのです。
テストが通っても、実機で崩れた
最初の変更では、Batsのテスト12件も構文検証も通っていました。それでも実機では不適切でした。
テストが保証したのは、設定の構文と、出力の形が期待どおりかまでです。「正常な推論を、誤って接続先から外さないこと」までは見ていません。設計や単体テストでは拾えず、実際に動かしてはじめて出る種類の失敗です。この「合格ラインは実機だ」という考え方は、別の記事でも繰り返し書いてきました。今回はそれが、監視の閾値という形で出た、というだけのことです。
言い換えると、テストは「書いたとおりに動くか」を確かめます。今回外したのは「書いた前提そのものが実環境に合っているか」でした。10秒という閾値は、書いたとおりに動いていました。前提が実態とずれていただけです。テストを増やしても、この種のずれは埋まりません。実環境の数値を測って前提に据える、という順序でしか防げませんでした。
同じ日に、受動監視へ戻す
選んだのは、能動的な推論監視の撤去です。
代わりに据えたのが、実際の通信を観測する受動的な監視です。こちらからプローブを送るのをやめ、利用者からの本物のリクエストがどう返っているかを見ます。応答が異常に遅い、あるいはエラーを返す実行機を、記録から拾って接続先から外す仕組みです。監視のための余分なリクエストを一切増やさないので、基盤への追加負荷はありません。すでに流れている通信を数えるだけだからです。
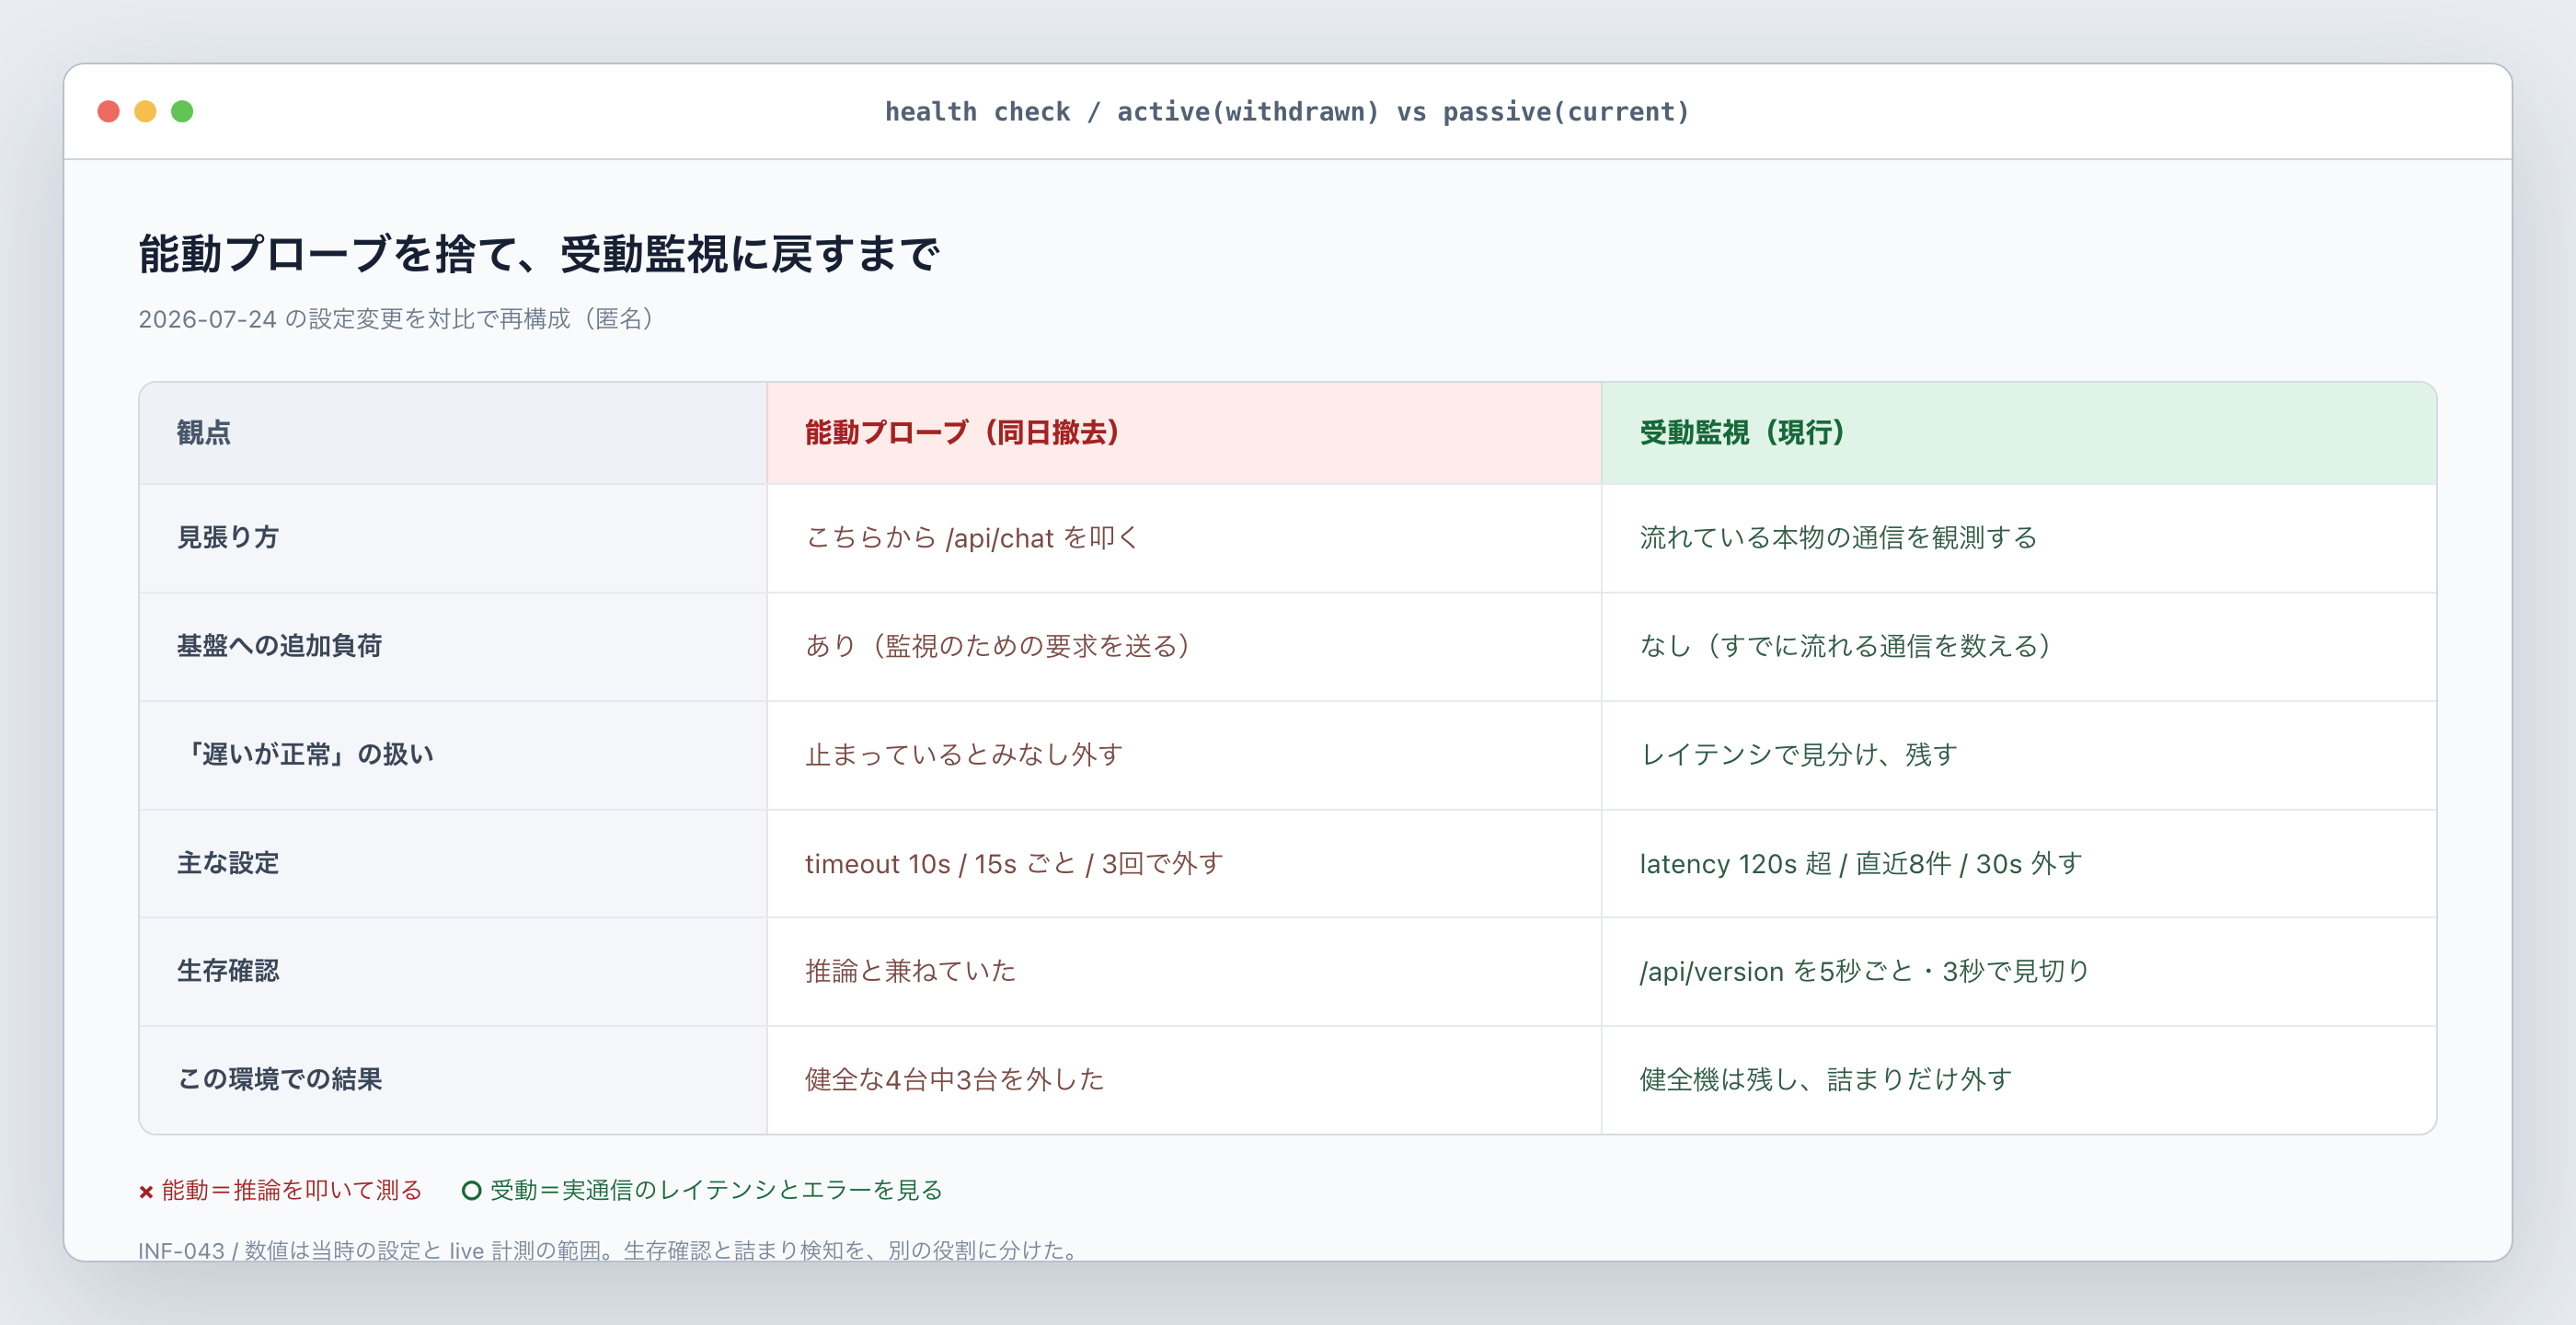
閾値はこう決めました。応答に120秒を超えたリクエストがあれば、その実行機を異常とみなします。正常でも長い推論が10〜60秒台まで実測で出るので、そこに引っかからない値まで引き上げました。相場の8〜10秒をそのまま使っていたら、また正常な機械を外していたはずです。エラー(500番台の応答)も異常として数え、直近の一定数(8件)のリクエストの中で異常が続いたら、その実行機を接続先から外します。外す時間は30秒です。30秒たてば、また本物のリクエストで様子を見ます。
ここで数値を2つに分けているのが要点です。何を異常と数えるかの物差し(120秒を超えた応答、または500番台のエラー)と、異常とみなしたあと何秒外すか(30秒)は、別々の設定にしています。速い処理を前提にした1つの数値で両方を兼ねると、また同じ穴に落ちるからです。
生存確認のほうは、軽い/api/versionへ戻しました。5秒ごとに送り、3秒で見切ります。プロセスが落ちたことは、これで十分速く分かります。推論が詰まったかどうかは、受動的な監視の担当です。1つの物差しで両方を測ろうとして失敗したので、役割を2つに分けました。生きているかを見る係と、仕事が詰まっていないかを見る係です。
なぜ能動的な推論監視を採らなかったのか。その理由は、設定ファイルのコメントと、変更のコミットメッセージに書き残しました。設計判断としてまとめた別の文書は、今のところ作っていません。それでも、次に同じ誘惑にかられたときへ向けて、過去の自分がすでに一度試して外した、と分かる場所には残しています。
能動を捨てて、詰まりはどう捕まえるのか
ここで、当然の疑問が残ります。こちらから叩くのをやめたら、詰まった実行機を見逃さないのか、という点です。
答えは、実際の依頼のレイテンシとエラーで捕まえる、です。ある実行機に流れた本物の依頼が、120秒を超えても返らない、あるいは500番台のエラーを返す。それが直近8件の中で続いたら、その台は詰まっていると見て、接続先から外します。詰まった/api/chatは、能動プローブを送らなくても、本物の依頼がそのまま時間切れになって現れます。だから、わざわざ探りを入れなくても、詰まりは通信のほうに出てきます。監視は、その出てきたものを数えるだけで足ります。
この方式には弱点もあります。能動プローブなら、利用者の依頼が来る前に「この台は準備できていない」と先回りできました。受動監視は、実際の依頼が何件か詰まってはじめて分かります。先回りはできません。
それでも受動を選んだのは、天秤にかけた結果です。能動プローブは、正常な機械を大量に外していました。受動監視は、詰まった台に当たった数件の依頼が遅れます。正常な3台を丸ごと落とすのと、詰まった1台に当たった数件が遅れるのと、どちらがましか。後者を選びました。実際、正常な機械を外すと、残った台に負荷が集まり、その台まで詰まりはじめます。監視が障害を広げるのが、いちばん避けたい形でした。
取り違えを防ぐ工夫も入れています。接続失敗の上限は2回まで、異常かどうかは直近8件の範囲で見る。こうすることで、「たまたま1件だけ遅かった」を「ずっと詰まっている」と早合点しないようにしています。1件のたまたまで台を外し、また戻し、を繰り返すと、その出し入れ自体が不安定さになるからです。
どこまで一般化できるか
一つ、線を引いておきます。
能動的なプローブが悪いわけではありません。応答が速い処理なら、実際に叩いて中身まで確かめる監視は、今でも有効です。HTTPの200が返るだけで正常とはみなさず、応答の中身まで見る。この考え方は、これまで役に立ってきました。
崩れたのは、それを「正常でも数十秒かかる推論」に当てはめたときだけです。基準になるのは、対象の処理が正常なときに何秒で返るか、その1点です。正常応答時間より短い物差しで叩けば、能動的なプローブは正常な機械を落とす側にまわります。だから、正常時間を先に測って、そのうえで閾値を決める。当たり前に見えて、これが今回いちばん効いた順序でした。
自作のAI基盤に限った話に聞こえるかもしれません。でも、正常でも遅い処理は、ほかにもあります。大きなファイルの変換、重い集計、外部への長い問い合わせ。そうした処理を監視するときは、同じ落とし穴が待っています。速い応答を前提にした物差しを、遅い処理へそのまま持ち込まない。今回学んだのは、その1点に尽きます。
逆に言えば、応答が1秒で返る接続口には、能動的な監視が今も向いています。現に私のシステムでも、生存確認は/api/versionを能動で叩いたままです——能動をやめたのではなく、遅い推論にだけ能動を当てるのをやめた、というのが正確なところです。速い処理は、遅ければ異常だと素直に言えるので、実際に叩いて中身まで確かめても利用者の邪魔になりません。分かれ目は処理の速さそのものではなく、「正常なのに遅いことがあるか」です。正常でも遅い処理には受動監視を、正常なら速い処理には能動監視を。同じ監視でも、相手の性質で選び分ける。それだけのことです。
この障害で決めたこと
- 異常とみなす時間は、対象の処理が正常なときの応答時間を測ってから決めます。閾値を先に置いて、実測をあとから合わせない。相場の値は、速い処理のために作られたものだと疑ってかかります。
- 推論が詰まったかどうかは、実際の通信を観測して見分けます。能動的な確認は、プロセスが生きているかを見る軽いものに限ります。1つの物差しに、生存と詰まりの両方を兼ねさせない。
- 採用しなかった案は、理由を設定ファイルと変更履歴の両方に残します。同じ選択を、二度やり直さないためです。半年後の自分は、たいてい今の理由を覚えていません。
この自宅サーバー・CI 基盤についての記事は、構築の経緯・設計・障害対応を、順次シリーズとして公開していきます。 興味のある方は、ぜひ「いいね」と記事の購読をお願いいたします。
そのほかの自社プロダクトは https://www.eln.ne.jp/products にまとめています。
筆者について
上原正吉。EarthLink Network Co., Ltd. でAI開発をしています。2025年からClaude Codeを開発の主体に据え、今は20を超えるプロダクトを1人で同時に開発・運用しています。この連載では、その現場で実際に起きたこと(うまくいったことも、失敗も)を、数字と一緒に書いていきます。
また、AIで業務や開発を組み替えたい会社・チーム向けに、AI活用のコンサルティングも受け付けています。ご相談は www.eln.ne.jp からどうぞ。
EarthLink Network は、会社の全業務を AI で回すために、必要になったものを自社で作っています。いま作っているプロダクトの一覧と概要は、こちらにまとめています。
→ EarthLink Network が自社でつくっている18のプロダクト
会社と各プロダクトの詳細は、公式サイト www.eln.ne.jp をご覧ください。