散らばった情報源を1つの検索にまとめる — knowledge統合ワークスペース UseSources
上原正吉(EarthLink Network Co., Ltd.)。Claude Codeを開発の主体に据え、20を超えるプロダクトを1人で同時に開発・運用しています。これは、その現場の実測記です。
散らばった情報源を1つの検索にまとめる — knowledge統合ワークスペース UseSources
結論
- 何を作ったか: knowledge統合ワークスペース
UseSources(usesources.com)です。柱は2つ。外部の情報源(Notion・Slack・Confluence・Jira・Google Driveなど)と、内部のwiki・タスク・チャットを1つのRAG(検索して答えを作る仕組み)に統合し、AI agentが「正しい答えがどこにあるか」を返すこと。そしてworkspace自体をprojectという1つの軸で統合することです。 - なぜ作ったか: 仕事の答えの断片は、自分たちのworkspaceの中だけでなく、外部のSaaSにも散らばっています。道具を1つずつ開いて別々に検索する構造そのものが、時間を食い、答えを見落とさせるからです。
- 何が要点か: UseSourcesは「knowledgeの統合」と「workspaceの統合」の2階建てです。検索・権限・文脈が1か所で成立する構造にしたことが、この製品の価値のすべてです。
本文(読了 約13分)
答えの断片は、社内にも社外にも散らばっている
「あの話、どこにあったっけ」。この問いに費やす時間が、仕事の中でどれだけあるでしょうか。
情報が散らばる場所は、実は2種類あります。1つ目は自分たちのworkspaceです。文書はwikiに、タスクはボードに、経緯はチャットに。2つ目が見落とされがちで、外部の情報源です。過去のNotionに仕様の原案が残っている。Slackのスレッドに決定の理由が埋まっている。ConfluenceやJiraに顧客とのやり取りがある。Google Driveに古い資料が眠っている。
探すとき、私たちは道具を1つずつ開いて、それぞれの検索窓に同じ言葉を打ちます。NotionはNotionの中しか探しません。SlackはSlackの中しか探しません。答えがどこに入っているかは、全部を探し終わるまで分からない。この構造が問題の根です。
しかもこの探し物は、1日に何度も起きます。1回が5分でも、日に6回なら30分。チームの人数分だけ掛け算になります。もっと悪いのは、探すのが面倒で「聞いた方が早い」となることです。答えを知っていそうな人への口頭質問が増え、その人の時間が削られ、答えはまたチャットの流れに埋もれて、次に探す人がまた見つけられない。散らばりは、放置すると自己増殖します。
AIの時代になって、この問題は別の形でも現れました。AIに仕事を頼むには文脈を渡す必要がありますが、文脈が5つの道具に散らばっていると、AIに渡せる形になっていないのです。人が探せない情報は、AIにも使えません。情報の統合は、人の効率化であると同時に、AIを本当に働かせるための前提整備でもあります。
1つ目の柱 — 内外の情報源を1つのRAGに統合する
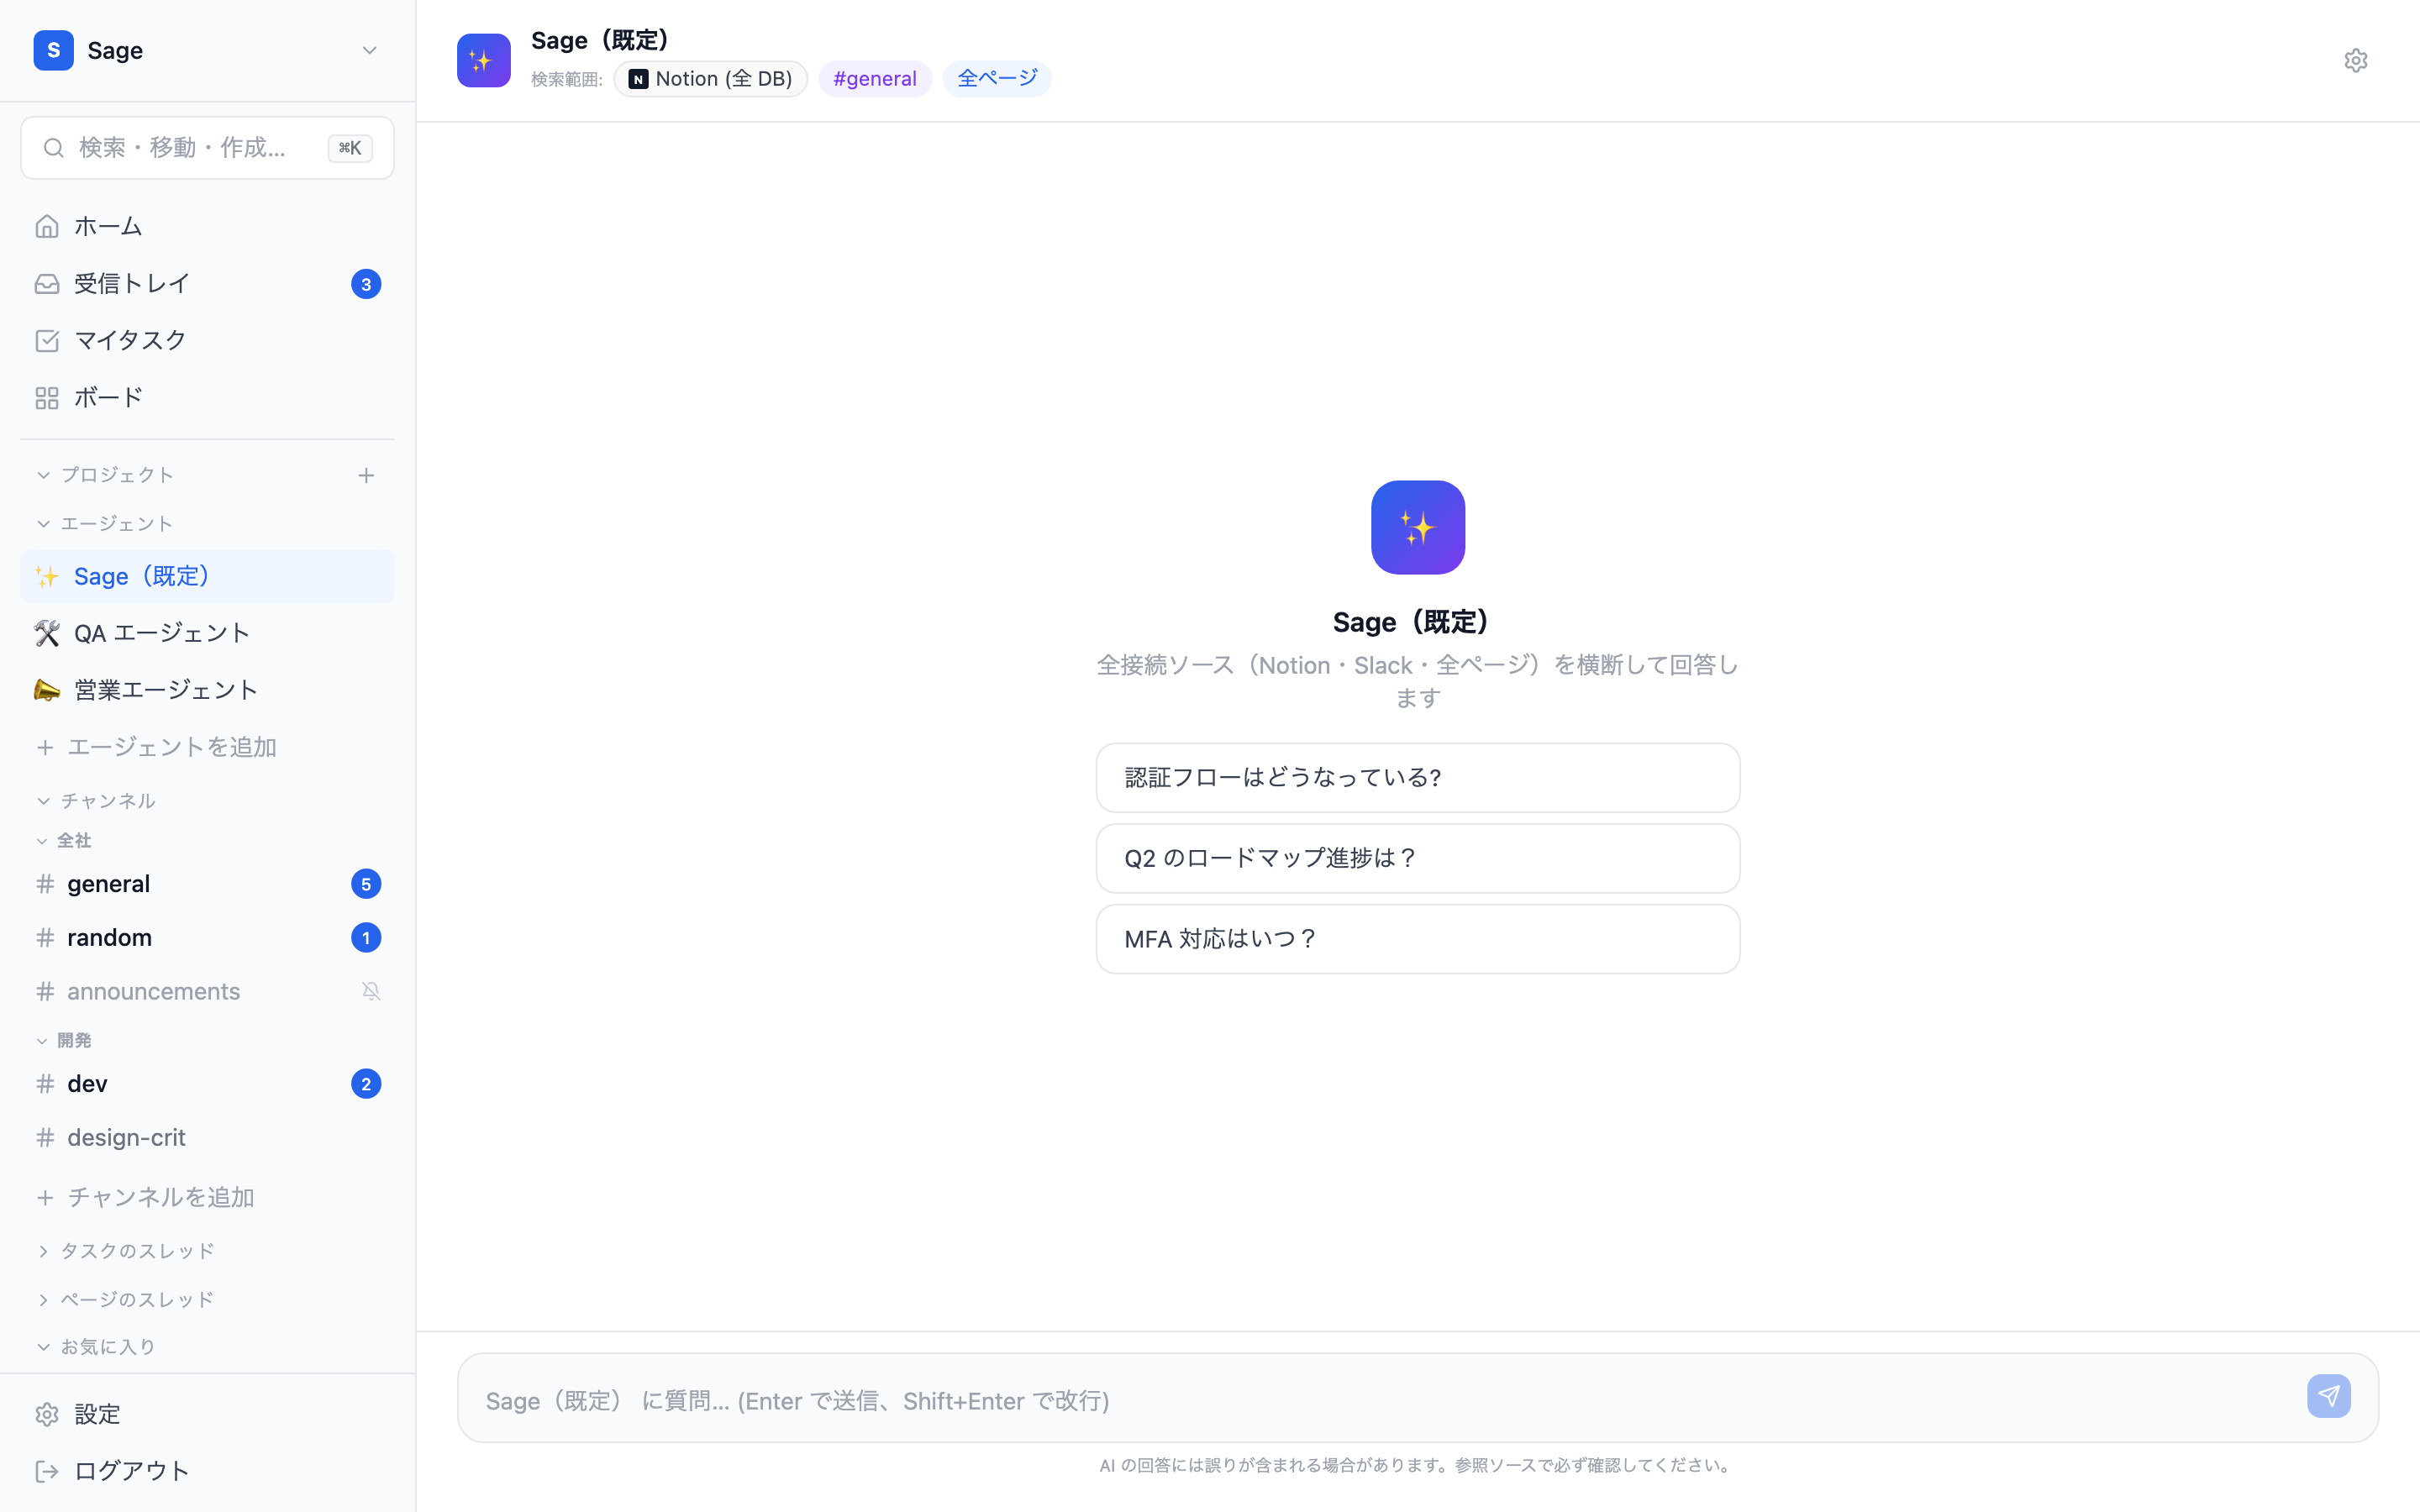
UseSourcesの1つ目の柱は、この構造の逆転です。内外の情報源を1つのRAGに統合し、1回の検索で「正しい答えがどこにあるか」をAI agentが返すようにしました。
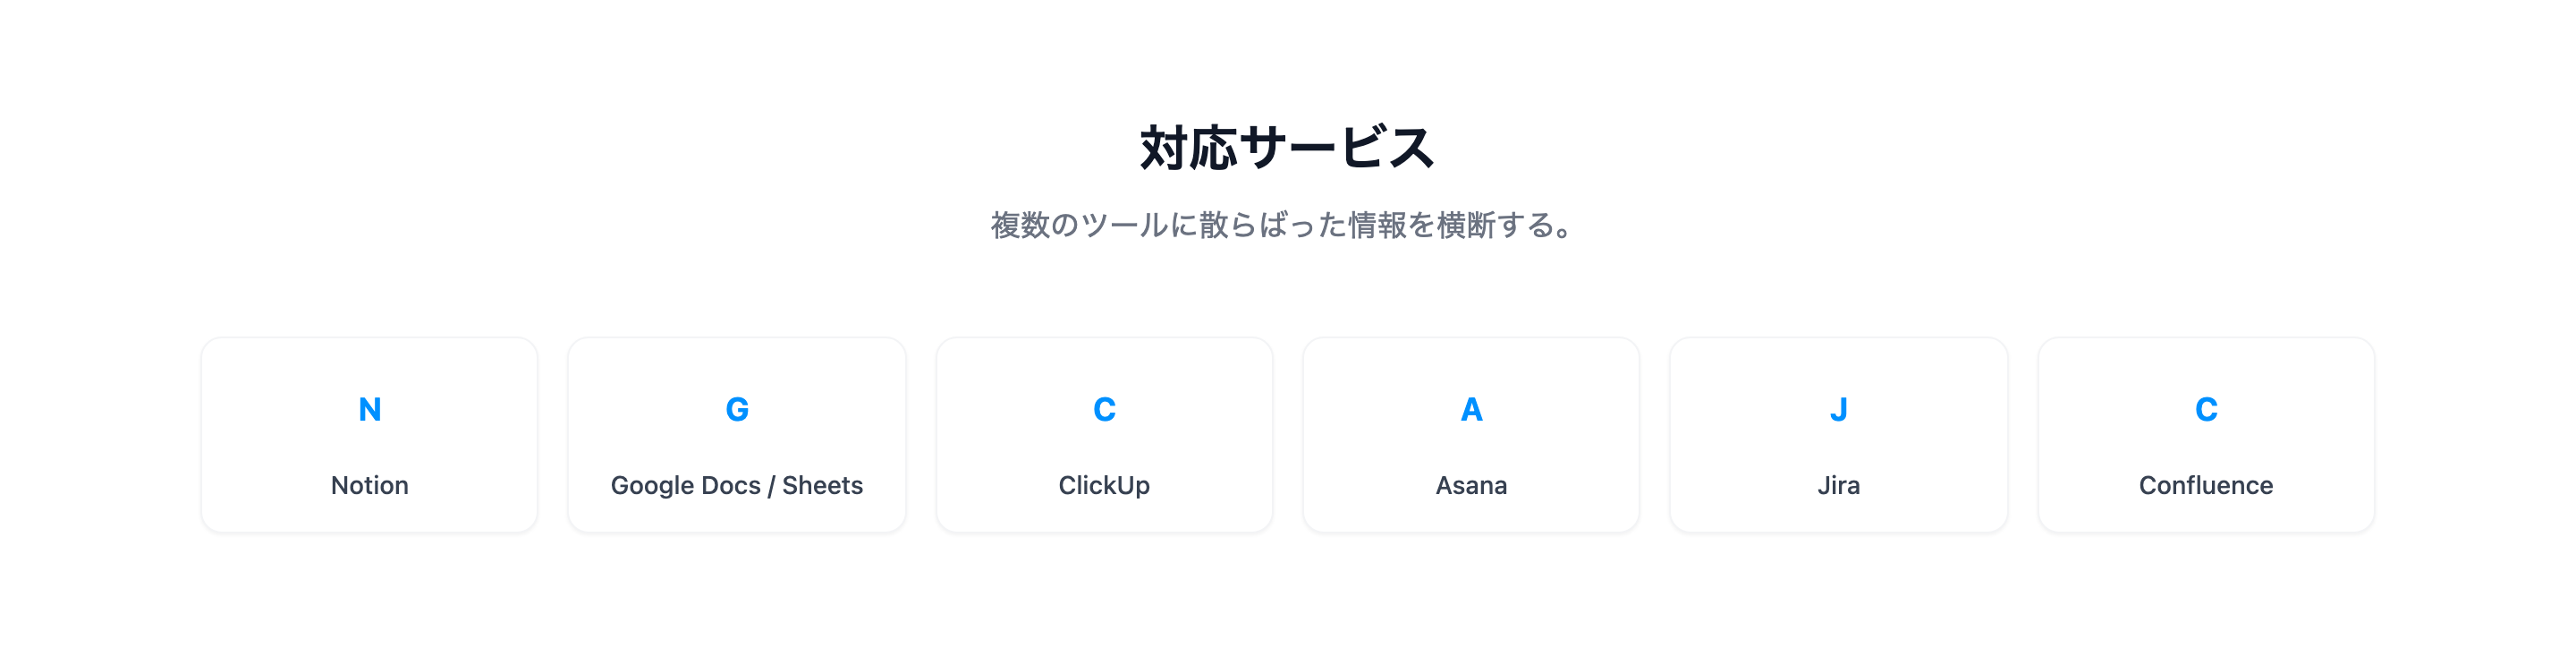
- 外部コネクタ: 外部SaaSの文書を取り込み、検索対象に加えます。コネクタは実際にNotionで約3,000件の文書を同期してE2E検証済みです。Slack・Confluence・Jira・Google Documents/Driveといった情報源へ、対応を広げています。
- 1つの索引: 取り込んだ文書と、内部のページ・タスク・チャットの発言が、同じ索引に載ります。検索は意味で探すベクトル検索と、言葉で探す全文検索を組み合わせたハイブリッド方式です。
- AI agent: 検索結果をそのまま並べるだけでなく、agentが質問に対して「答えはこの文書のここにある」という形で返します。人が10個の検索結果を開いて読む代わりに、agentが在り処まで案内します。
この「全部の情報源を1つのRAGにする」が、UseSourcesという名前の由来でもあります。sourceを、使える状態にする。
検索の作りと、費用の判断
検索基盤には、判断が2つありました。
1つ目は、専用の検索エンジンを持たない判断です。当初の構成案にはElasticsearch(大規模検索の定番ソフト)がありましたが、撤去しました。Postgresデータベースのpgvectorというベクトル検索機能と全文検索を組み合わせれば、この規模では十分に速く、運用するサーバーが1種類減ります。個人開発の規模で検索エンジンを別建てすると、費用と運用負荷が本体を圧迫します。
2つ目は、取り込みを非同期にする判断です。外部コネクタの全量同期は、当初は同期処理で、大きなworkspaceだと86〜120秒応答が返らずタイムアウトしていました。キュー(順番待ちの仕組み)を挟んで裏で処理する方式に変え、応答は1.73秒に。追加費用は月に1〜2ドル程度と見積もった上での変更です。この長期戦の顛末は別の記事に書いています。
2つ目の柱 — workspaceをprojectという軸で統合する
検索が1つになっても、日々の仕事の置き場所がバラバラなら、散らばりは再生産されます。だから2つ目の柱が要ります。workspace自体の統合です。
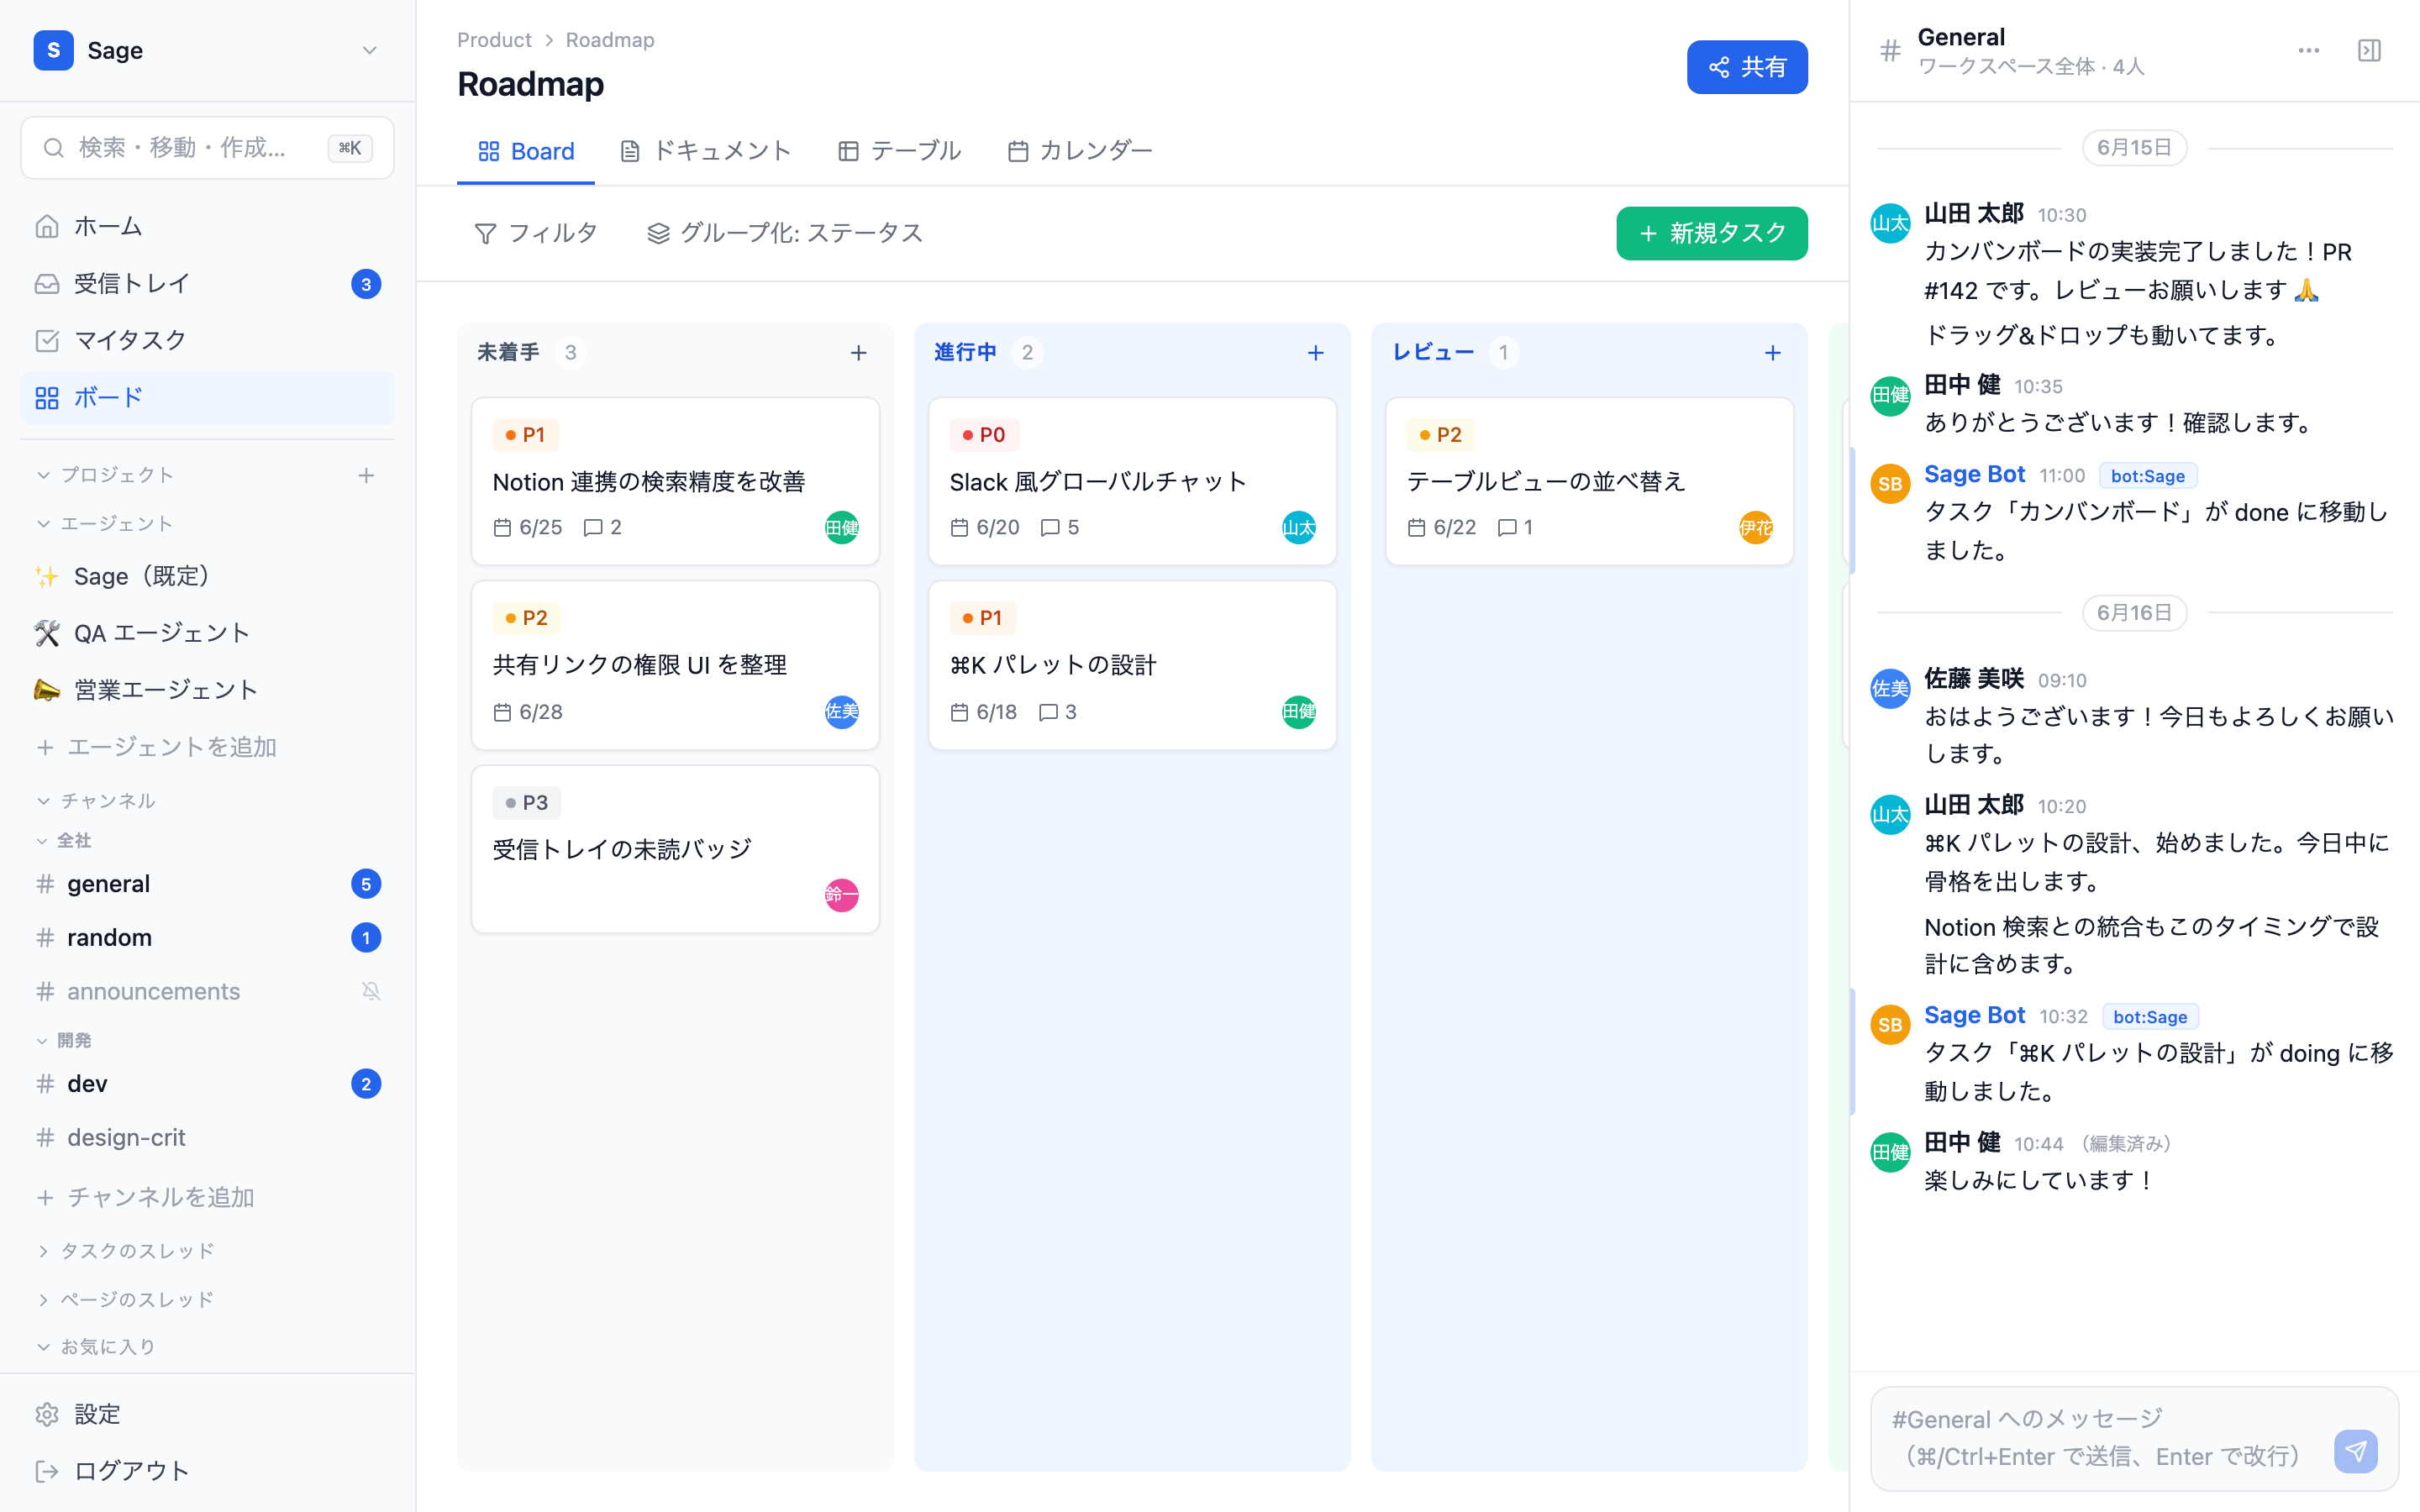
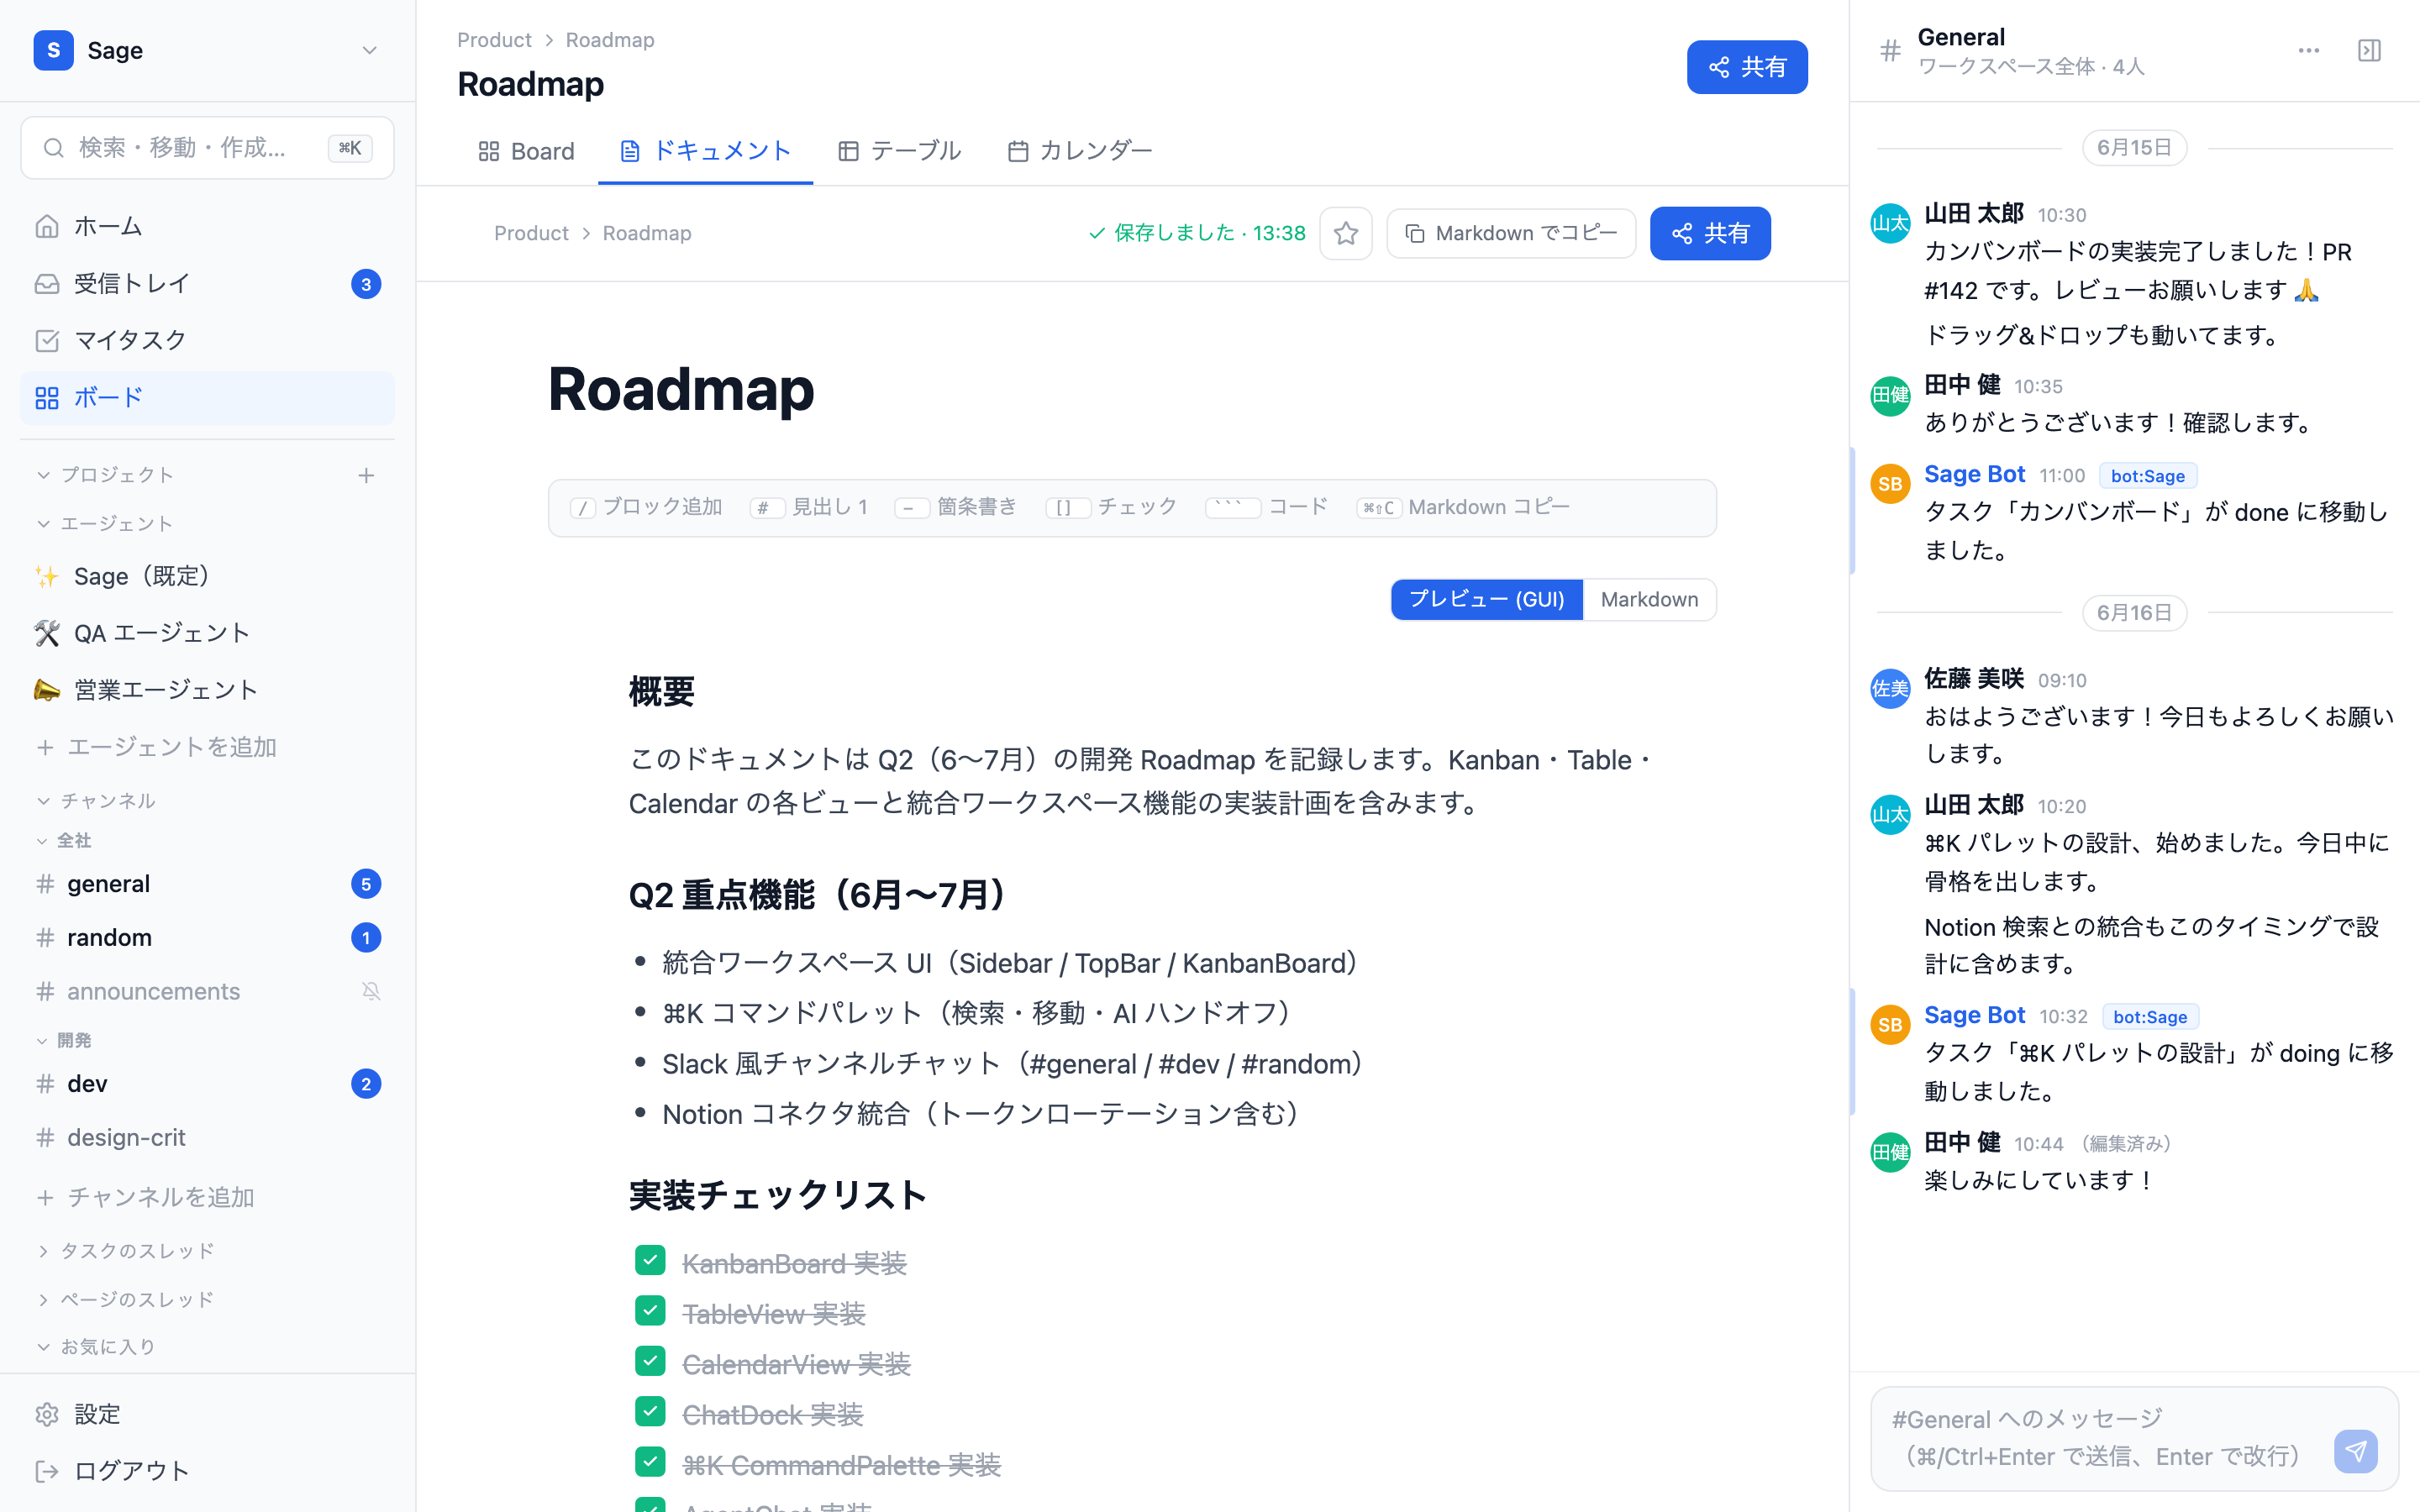
- projectを作ると、3点セットが同時にできます。 Notion的に書けるwikiページ、タスクボード、専用チャットチャンネルが、projectの作成と同時に用意されます。
- 権限はprojectに対して1回だけ。 メンバーを入れるのも外すのも、projectへの操作1つです。外せば配下のページ・ボード・チャットの権限が一括で失効します。「Slackだけ外し忘れて、抜けた人が文書を見られたまま」が構造的に起きません。
- タスクはページの一種です。 JiraとConfluenceのようにタスクと文書を別システムに分けず、1つのエンティティに統一しました。タスクにも文書と同じ本文が書け、同じ検索に載ります。
- チームで同時に書けます。 ページは複数人のリアルタイム同時編集に対応し、メンション・通知・在席表示・コメント・共有まで揃えています。
knowledgeの統合(1つ目の柱)とworkspaceの統合(2つ目の柱)は、同じ思想の2階建てです。**外部の過去はRAGでつながり、内部の現在は1つの軸で回る。**検索も権限も文脈も、1か所で成立します。
実際の使い方 — 社内でどう回しているか
抽象論だけでは伝わらないので、社内での使い方を3つ書きます。
例1: 「あの決定、どこでしたっけ」。 数か月前の設計判断を確かめたいとき、以前はwikiを探し、無ければチャットを遡り、外部のNotionまで開いていました。いまはUseSourcesの検索に「なぜ〇〇を採用したか」と打ちます。agentが、当時のチャットの該当スレッドと、関連するwikiページを在り処つきで返します。探す時間が、読む時間に変わるのが一番の違いです。
例2: 新しく入った人の立ち上がり。 新メンバーをprojectに入れると、その瞬間から配下のwiki・ボード・チャットが全部読めます。「過去の経緯はこの5つのツールを見てください」という案内が不要になり、質問される側の負担も減りました。過去の外部文書もRAG経由で同じ検索から辿れるので、「歴史はNotionの旧workspaceにあります」のような分岐案内も消えます。
例3: 週次の棚卸し。 projectのタスクボードとページが同じ軸にあるので、「今週動いたページ」と「動いたタスク」を並べて見られます。タスクはページの一種なので、タスクの本文に検討メモがそのまま書けて、後から検索で引けます。会議メモとタスクが別システムで乖離していく、という定番の劣化が起きません。
権限と同時編集の裏側
構造の話を2つ補足します。
権限はprojectから引き継がれます。 人への権限付与はprojectに対してだけ行い、配下のページ・ボード・チャンネルには、projectに付けた権限がそのまま引き継がれます。だから「外す」も1回で済む。例外的に個別ページへ直接権限を付ける抜け道を作らなかったことが、後から効いています。例外を1つ許すと、棚卸しのたびに全ページを確認する羽目になるからです。
同時編集は、編集の衝突を自動で解決する仕組み(CRDT)で作っています。 2人が同じ段落を同時に直しても、どちらかの変更が消えたりしません。リアルタイム通信の経路は、費用を抑えるため軽量なサーバー構成に寄せ、本番の通し検証まで済ませています。ここは「Notion級の編集体験」と「個人開発の費用」を両立させるための、地味ですが大事な選択でした。
最初からこの形だったわけではない
UseSourcesは2回、大きく方向を変えています。
始まりは、複数のSaaSを横断するRAG検索の道具でした。検索だけを作って気づいたのは、検索だけでは仕事の置き場所が変わらないことです。散らばりの根本原因——日々の仕事が別々の道具で行われること——が残ったままだからです。
そこでタスク管理とチャットの統合へ方向転換し、作り込む中で「タスクとページを別物にすると置き場所がまた2つになる」と気づいてタスクをページの一種に統一。最後にprojectを第一級の軸にする現在の形に着きました。設計判断は4か月で30本、すべて記録に残しての方向転換です。
一度は挫折した前身もあります。1年前に「統合ナレッジ検索」として作りかけて止まったプロトタイプを、仕様書を先に書く開発プロセス(ADR/SDD/TDDをAIと整備する方式)で再起動したのが今のUseSourcesです。4日間で開発基盤を立ち上げ、3か月で本番稼働まで持っていきました。
RAGは魔法ではない — 実務で効かせるための作り
RAG(Retrieval-Augmented Generation、検索で根拠を集めてから答えを作る方式)という言葉は流行していますが、実務で効かせるには地味な作りが要ります。UseSourcesで実際に効いた要素を書きます。
第一に、索引の鮮度です。外部文書を一度取り込んで終わりでは、すぐに古くなります。UseSourcesは取り込みをキュー経由の非同期ジョブにしたことで、大きなworkspaceの再同期を日常的に回せるようになりました。同期が重いと再同期の頻度を下げたくなり、索引が古びる——この悪循環を、非同期化が断ちます。
第二に、意味検索と言葉検索の併用です。ベクトル検索(意味の近さで探す)は言い換えに強い一方、固有名詞や型番の完全一致に弱い。全文検索はその逆です。両方を組み合わせるハイブリッドにしたことで、「昨日の障害の件」のような曖昧な聞き方と、「P2002」のような固有の識別子の両方が引けます。
第三に、在り処を返す設計です。agentが要約だけを返すと、人はその要約を疑えません。UseSourcesのagentは「この文書のこの部分」という出典つきで返します。読者の皆さんも社内RAGを作るなら、まず出典表示から作ることをおすすめします。信頼は要約の流暢さではなく、出典の確かさから生まれます。
NotionやSlackの置き換えなのか
よく聞かれるので、位置づけをはっきり書きます。UseSourcesは「Notion・Slack・Jiraを明日から全部やめましょう」という道具ではありません。
現実の組織には、既存ツールの履歴と習慣が積み上がっています。だからUseSourcesは2段構えです。**過去はコネクタでRAGに取り込み、検索できる資産に変える。現在の仕事は、projectという軸の上で回し始める。**移行は一夜の引っ越しではなく、検索の入口が1つになるところから始まって、日々の置き場所が徐々に寄っていく、という順序です。
自社でも、全部が一気に移ったわけではありません。まず検索の入口として使い始め、新しいprojectから順にUseSourcesの上で回すようになりました。移行を強制しない構造にしたことが、結果的に定着を速くしました。
事故からの学び
順風満帆ではありませんでした。印象的な事故を1つ書きます。画面の見た目を仮データ(mock)で先に作り、後から実データへつなぎ替える方式を採っていたのですが、切り替えのときに「仮データの状態も残す」という約束を守らないまま一斉に切り替えて、デモ用のデータが全部消え、検索窓に内部の文字列が露出する不具合まで出しました。切り替え前の状態を保全しないまま進めた失敗です。以後、仕様を先に固めてから実装する規律を強化しました。失敗の後に規律を仕組みへ変える——このやり方は、当社の開発全体で徹底していることです。
開発の裏側 — 挫折したプロトタイプを、仕様先行で再起動する
UseSourcesの開発には、この連載で書いてきた「AIと開発する型」がそのまま出ています。
前身は1年前の「統合ナレッジ検索」プロトタイプで、一度止まっています。再起動にあたって最初にやったのはコードを書くことではなく、文書の整備でした。設計判断の記録(ADR)・基本設計(SDD)・詳細設計(TDD)の形式を整え、タスク管理と接続する。この立ち上げに使ったのは4日間です。以後、設計判断はすべて記録しながら進め、4か月でADRは30本になりました。
活動量も記録が残っています。再起動月のコミットは12件。翌月76件、その翌月が245件のピーク、その次が112件。数字が示すとおり、最初の2か月は方向探しで、軸が決まった瞬間に実装が爆発しています。方向転換を2回してもこの速度が出るのは、判断が全部文書に残っていて、覆すときに「何を覆すのか」が明確だからです。
もう1つ、この製品で確立したのが、画面の見た目を先に固めてから実装する進め方です。ワイヤーフレームと仮データで12画面以上を先に作り、見た目の合意を取ってから中身をつなぎました。前述のデモデータ消失事故はこの切り替えで起きた失敗ですが、方式自体は正しく、事故後は切り替え前の状態保全を必須にして続けています。
いまの状態
UseSourcesは本番(app.usesources.com)で稼働し、社内で毎日使っています。管理画面は別ホストへ分離し、リアルタイム編集の通信は費用を抑えた構成で運用しています。外部コネクタの対応源とagentの精度を広げていく段階です。
始め方
usesources.com からアプリを開けます。まずprojectを1つ作り、いつものメモとタスクをそこに置くところから始めるのがおすすめです。外部コネクタは、いちばん散らばりがひどい情報源(多くの場合は過去のNotionか共有ドライブ)を最初につなぐと、効果が一番分かりやすく出ます。
「道具を増やすと散らかるのでは」という心配には、こう答えています。UseSourcesは道具を1つ増やすのではなく、探す場所を1つに減らす道具です。既存の道具を捨てなくても、検索の入口が1つになるだけで、日々の「どこだっけ」は目に見えて減ります。
転用できる教訓
- 情報の散らばりには2種類あります。workspace内の散らばりと、外部SaaSへの散らばり。前者は軸の統一で、後者はRAGへの統合で解くのが筋です。検索だけでは前者は直りません。
- 「答えを返す」より「答えの在り処を返す」agentの方が、業務では信頼されます。人は出典を見て初めて安心します。
- 検索エンジンの別建ては規模に見合うかを先に問います。Postgresのベクトル検索+全文検索で足りる規模なら、運用対象を増やさない方が総費用は下がります。
- 外部からの大量取り込みは最初から非同期にします。同期処理のタイムアウトは、workspaceが育ってから顕在化します。
- タスクと文書を別システムに分けると、置き場所の分裂が再発します。「タスクはページの一種」という統一は、検索にも権限にも効きます。
この UseSources についての記事は、開発の経緯・どんな機能があるか・どう実装したかを、順次シリーズとして公開していきます。 興味のある方は、ぜひ「いいね」と記事の購読をお願いいたします。
UseSources は、Notion・Slack・Jira などに散らばった情報を1つのRAGに統合し、project を軸に page・タスクボード・chat をまとめる統合ワークスペースです。詳しくは https://usesources.com をご覧ください。 そのほかの自社プロダクトは https://www.eln.ne.jp/products にまとめています。
筆者について
上原正吉。EarthLink Network Co., Ltd. でAI開発をしています。2025年からClaude Codeを開発の主体に据え、今は20を超えるプロダクトを1人で同時に開発・運用しています。この連載では、その現場で実際に起きたこと(うまくいったことも、失敗も)を、数字と一緒に書いていきます。
また、AIで業務や開発を組み替えたい会社・チーム向けに、AI活用のコンサルティングも受け付けています。ご相談は www.eln.ne.jp からどうぞ。
EarthLink Network は、会社の全業務を AI で回すために、必要になったものを自社で作っています。いま作っているプロダクトの一覧と概要は、こちらにまとめています。
→ EarthLink Network が自社でつくっている18のプロダクト
会社と各プロダクトの詳細は、公式サイト www.eln.ne.jp をご覧ください。