設計記録(ADR)が増えて AI が古い仕様で判断する問題を解く ── 記録は消さず、現行を索引で示す
上原正吉(EarthLink Network Co., Ltd.)。AI会社・AI社員による業務自動化と、人の逐次介入なしに24時間自動開発を回す仕組みを自社で実践しています。開発ノウハウと具体的な設定方法、運用して分かった改善点を公開しています。
設計記録(ADR)が増えて AI が古い仕様で判断する問題を解く ── 記録は消さず、現行を索引で示す
自社の Claude Code 用プラグイン ELN workflow での話です。以前、連載の別の回(AIが既存決定を無視する本当の理由 ── ADR文脈自動注入hookの手法)で、設計の判断を残した文書(設計記録、英語では ADR)の一覧を、Claude Code の起動時に自動で AI へ渡す仕組みを書きました。今回はその続きです。
設計記録は消すわけにはいきません。かといって溜まっていくと、AI が過去の判断を読んで、今とは違う判断を下します。170 件近くになった時点で、起動時の一覧は番号の古い 30 件しか AI に見せず、状態の欄を別の書き方で書いた 29 件も読めていませんでした(どちらも前の回で残した問題です)。AI は残りをファイル名で選び、本文を 1 件ずつ開いて「どれが今も有効か」を推し量っていました。Claude Code でも Codex でも同じ困りごとです。この記事は、その解決策として、「どれが現行か」を索引に答えさせる仕組みを書きます。
結論
- 設計記録は消さずに残し、「どれが現行か」は索引に答えさせます。 索引は保存しておくのではなく、1 つの決まった規則で毎回作ります。167 件の読み取りにかかるのは 0.04〜0.11 秒です。
- 番号を拾うだけの読み方では、読み取りの処理そのものが間違えます。 読み違え方は 4 通りでした。「置き換えた記録: なし(○○を改訂する)」から番号を拾うと、有効な記録が「置き換え済み」になります。番号の重複では関係が別のファイルに付き、小文字の欄名では採択済みの記録が「読めない」になり、他のリポジトリの番号では無関係な記録が置き換え先として示されました。「置き換え済み」と言い切るのは、厳密な書き方の時だけにしています。
- 索引を AI に見せる場面は 4 つです。 起動時の新しい順の要約と置き換え済みの表、読もうとした時の警告(Read でも cat でも出て、止めずに知らせる)、変更の取り込みを頼む単位(PR)ごとに変えた行だけを自動で検査する仕組み(CI)、旧・新・索引を同時に書く 1 つのコマンドです。
- 結果。 起動時の要約は 3,511 → 1,140 バイト、索引に見える有効な記録は 126 → 155 件、置き換え済みの表は 0 → 5 行になりました。179 件に増えた時点でも、要約は 1,186 バイト(上限 1,200 バイト)です。
本文(読了 約12分)
1. 作ったもの
作ったのは、設計記録の「どれが現行か」に答える次の 5 つです。どれも同じ 1 つの読み取りの処理を使います。
- 設計記録を調べるコマンド
eln-adr。list(現行の一覧)、show(1 件の要点だけ)、find(言葉で探す)、tree(置き換えの関係)で、本文を読む前に必要なことを引けます。Python で書いた 1 本のスクリプトなので、Claude Code 以外の AI からも呼べます。 - セッション開始時の要約。 Claude Code を起動した時に、件数、置き換え済みの表、新しい順の 10 件、
eln-adrの使い方を、1,200 バイト以内で AI に渡します。 - 読もうとした時の警告。 AI が置き換え済みの記録や大きな記録を読もうとすると、置き換え先が現行であることや、要点は
showで引けることを知らせます。止めはしません。 - CI のチェック。 PR で追加・変更した設計記録の、変わった行だけを厳密な書き方で検査します。
- 採択・改訂・置き換えを 1 つのコマンドで。
accept・amend・supersede・reject・newが、旧い記録・新しい記録・索引の表を同時に書き換えます。
2. 167 件の時点で測ったこと
README(リポジトリの説明書きのファイル)に読み方の決まりを書けば防げる、という案もありました。でも、文章で頼んでも AI がそれを読むかどうかは分かりません。私は AI に「README に書くだけで AI が ADR を勝手に全部読むのを防げるのか。機械的なガードが無くて大丈夫なのか、全く信用できない」と聞き、まず今どうなっているかを測りました。
測ったのは、設計記録が 167 件(合計 2,171,690 バイト、一番大きいもので 68,777 バイト)あった時点です。
- 置き換えを機械で読める形で書いていたのは 3 件でした。 見出しの欄に「置き換えた先」を書いていたのは 3 件だけで、76 件は本文の文章の中で置き換えに触れているだけでした。文章を読まない限り、どれが置き換え済みかは分かりません。
- AI は本文を cat でも読んでいました。 測る前のおよそ 4 週間、38 セッションの記録では、設計記録の本文を Read で読んだのが 37 回(うち 33 回は行の範囲を指定した部分読み)、cat・sed・head・tail で読んだのが 80 回でした。大きなファイルを読むと鳴る既存の警告は Read だけを見ていて、しかも 1,000 行を超えた時だけです。一番長い設計記録でも 648 行なので、一度も鳴っていませんでした。
- 手で書いていた一覧表は 122 件目で止まっていました。 45 件が載っていませんでした。
- 前の回で書いた 2 つの問題も残っていました。 起動時の一覧は、有効な記録を番号順に並べた先頭の 30 件だけを渡し、「残りはフォルダの一覧で確認してください」と添えていました(3,511 バイト)。太字で書いた状態の欄(
- **Status**: Accepted)も読めず、有効な 29 件が漏れたままで、一覧から見えていた有効な記録は 126 件、実際は 155 件でした。その仕組みを作った時の設計記録には「30 件を超えたら見直す」と書いてあり、167 件はその 5.6 倍です。
心配していた「AI が全部をまとめて読む」は、38 セッションで 0 回でした。実際にしていたのは、フォルダの一覧を出し(36 回)、名前で選んで 1 件ずつ読むことです。これは、起動時の一覧に書いてあった「残りはフォルダの一覧で確認」という案内の通りの動きでした。AI は言われた通りに動いていて、言っていたことのほうが古い決定へ導いていたわけです。
3. ファイルは残し、索引を毎回作る
設計記録は、決めたことと理由を後から辿れるように残す文書です。古い判断を消すと、なぜ今こうなっているのかが分からなくなります。だから最初に決めたのは、設計記録のファイルを 1 つも消さない、動かさない、分けないことです。プラグインのスキルや hook、スクリプトは、設計記録を番号とファイルの場所で参照しています。167 件の時点で調べると、どこからも参照されていない設計記録は 1 件だけでした。消したり分けたりすると、その参照がずれます。
そのうえで、「どれが現行か」は本文ではなく索引に答えさせます。索引は、1 つの読み取りの処理がファイルの先頭の欄(状態・日付・置き換えた記録・置き換えた先)から毎回作ります。結果をファイルに保存して使い回すことはしません。保存した索引は、手で書いていた一覧表と同じように、元のファイルとずれていくからです。167 件の読み取りは 0.04〜0.11 秒で終わるので、毎回作っても待ち時間はほとんどありません。
人が見るための索引の表(docs/adr/README.md)は残しています。ただし、これも eln-adr が毎回作り直すもので、手では直しません。表の中身が作り直した結果と食い違えば、後で書く CI の検査が止めます。起動時の要約や読む時の警告は、この表ではなく、毎回の読み取りの結果を使います。
状態は次のように分けて数えます。
| 状態 | 意味 | 現行に数えるか |
|---|---|---|
| そのまま有効 | 採択または改訂されて、置き換えられていない | 数える |
| 一部が置き換え済み | 一部だけが新しい記録に置き換えられた | 数える(置き換え先も表示) |
| 置き換え済み | 新しい記録に置き換えられた | 数えない |
| 提案中 | まだ採択されていない | 数えない |
| 却下 | 採らなかった案 | 数えない |
| 読めない | 状態の欄が決まった言葉でない | 数えずに、件数として表示する |
読めないものを黙って落とさず「読めない」として件数に出すのは、太字の 29 件のように、気づかないまま漏れるのを防ぐためです。
4. 番号を拾うだけでは、読み取りの処理が間違える
一番の発見はここでした。置き換えの関係を読むなら、「置き換えた記録」の欄にある番号を全部拾えばよさそうに見えます。最初の版はそう作りました。ところが、設計記録の実物と突き合わせ、社内の別の 2 つのリポジトリ(当時 270 件と 93 件の設計記録がありました)でも動かすと、読み違えを作る型が 4 つ出てきました。
- 注記つきの「なし」。
Supersedes: (none — ADR-xxxx を改訂する)のように、「置き換えたものはない、この記録は ADR-xxxx を改訂する」という意味の書き方があります。番号を拾うと、改訂しただけの記録が「置き換え済み」になります。このリポジトリでは有効な 2 件がそうなるところでした。別のリポジトリにも、「なし(ADR-xxxx の方針は覆さない)」という形が 7 件ありました。 - 番号の重複。 別々の記録が同じ番号を使っていることがあります(9 組と 4 組)。番号だけで辿ると、関係が別のファイルに付きます。
- 小文字の欄名。
- status: Acceptedのように小文字で書いた欄を読めず、採択済みの記録が「読めない」になりました。 - 他のリポジトリの番号。 「置き換えた先: 別のリポジトリ名 ADR-xxxx」と書いてあると、同じ番号を持つ自分のリポジトリの無関係な記録が、置き換え先として示されました。
270 件のリポジトリでは、最初の版が「置き換え済み」と出した 5 件は全部、誤って拾った関係によるものでした。規則を直した後は 0 件です。
そこで、読むのは幅広く、ただし推し量らないことを先に決めました。
- 「置き換え済み」と言い切るのは、欄の値が
ADR-NNNNの並びだけの時です。 文章が混じっていれば「一部が置き換え済み」として表示だけにします。 - 値が「none」「なし」で始まれば、関係を作りません。 後ろに番号が書いてあっても拾いません。
- 置き換えを宣言した側がまだ提案中なら、旧い記録は現行のままにします。 「採択されたら置き換わる」と表示します。採択していない新しい記録が、旧い記録をその日のうちに消すことはありません。
- 前にハイフンかアンダースコアを含むリポジトリ名が付いた番号は、外部の記録として表示だけにします。
- 番号が重複している記録への関係は適用しません。 どちらのファイルか決められないからです。
書き方の揺れを広く読むほど、読み取りの処理が推し量る場面も増えます。だから、推し量らない場面を規則として先に書き出しました。
5. 索引を AI に見せる場面: 起動時の要約・読む時の警告・CI・1 つのコマンド
索引を作っても、AI がそれを見なければ同じことです。AI に見せる場面を 4 つ用意しました。
起動時の要約
Claude Code を起動すると、hook(Claude Code が決まったタイミングで自動で実行するスクリプト)が次の文字を AI に渡します。
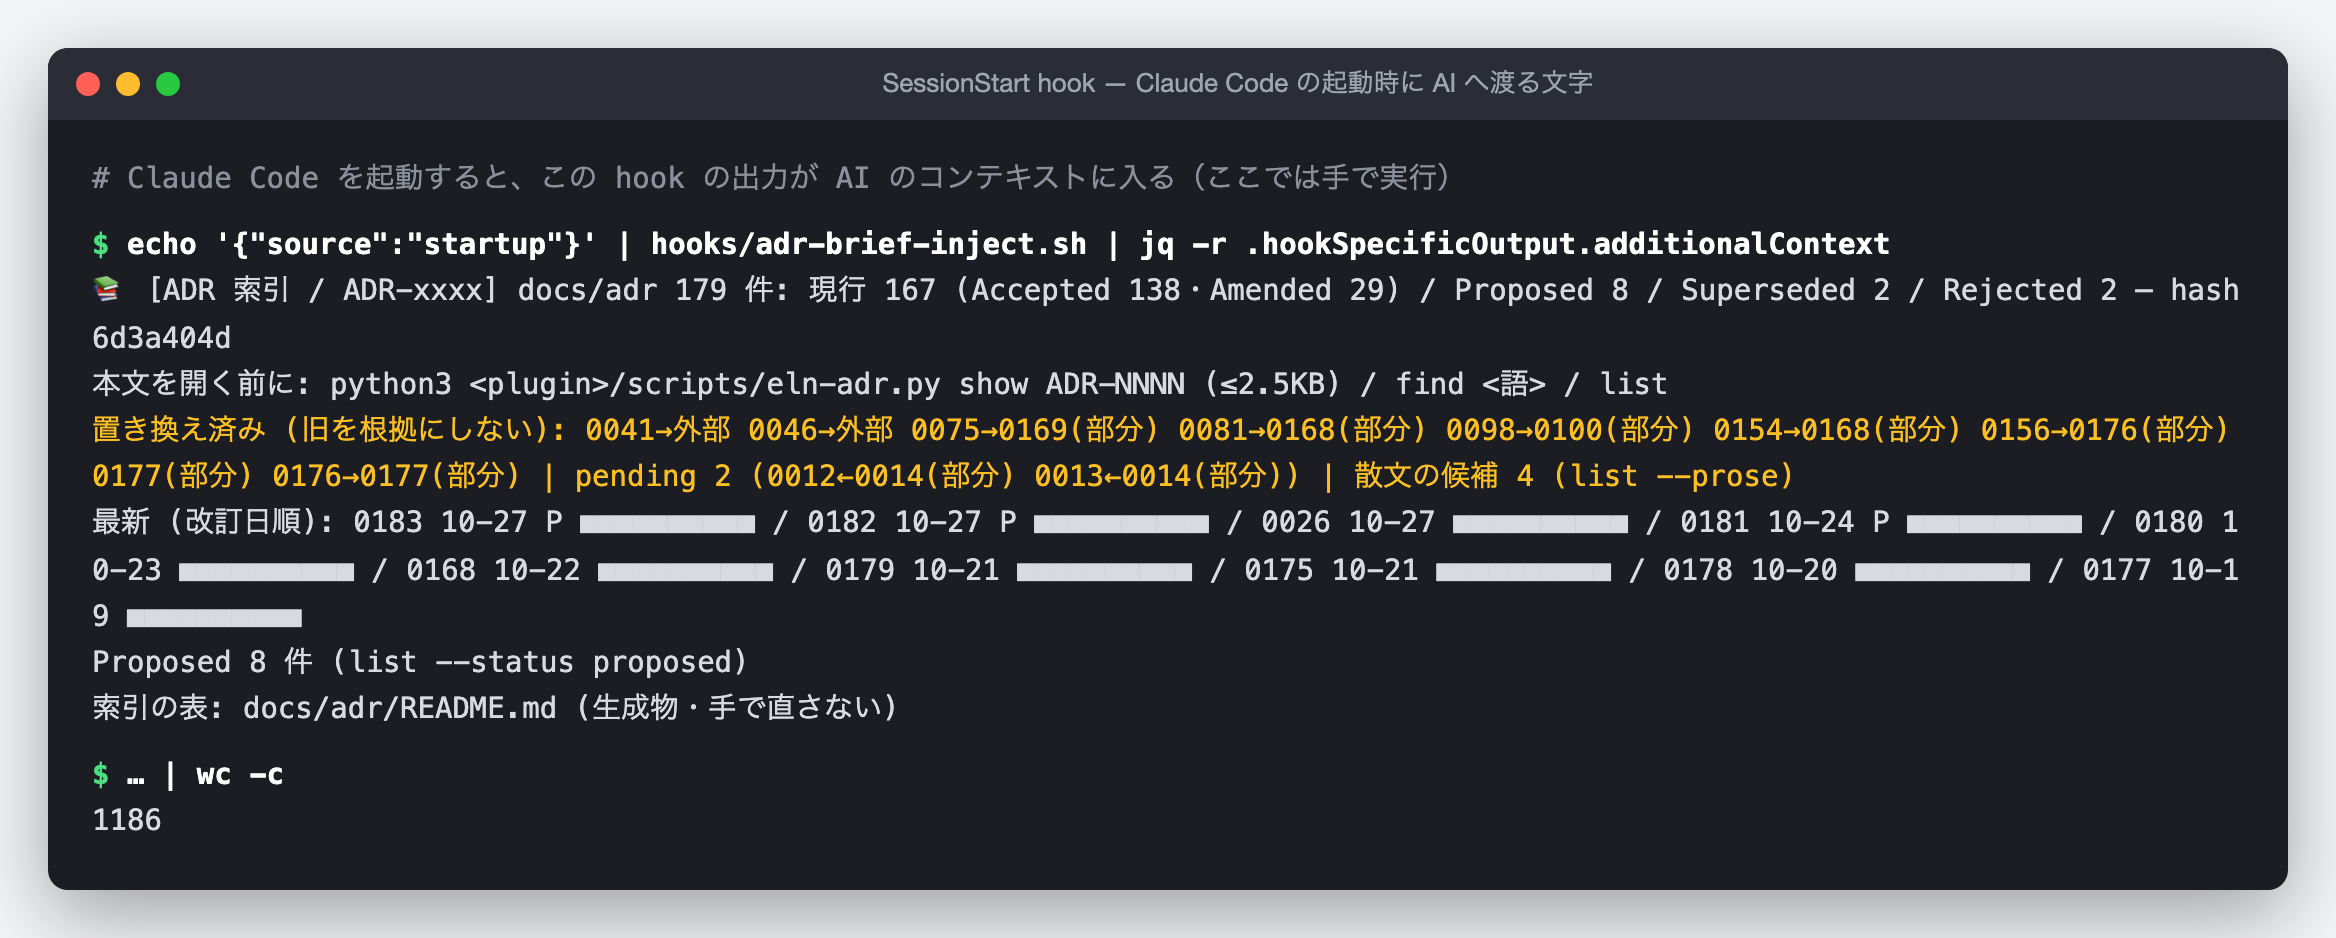
並びは決めてあります。件数、eln-adr の使い方、置き換え済みの表、改訂日の新しい順の 10 件、提案中の件数です。上限は 1,200 バイトで、超えそうな時に削る順番も決めてあります(提案中を件数だけに、題名を短く、新しい順を 8 件、6 件に、置き換え済みの表を件数だけに、題名をさらに短く、最後は新しい順も外す)。件数の行、eln-adr の使い方の行、置き換え済みの件数は必ず残ります。「残りはフォルダの一覧で確認」という案内は、もう出しません。
会話が長くなって要約し直した時(compact)や、前の会話を再開した時(resume)は、300 バイト以内の短い案内だけを入れます。会話を縮めた直後に大きな文字を入れ直すと、縮めた会話がまたすぐ膨らむからです。索引はいつでも eln-adr で引き直せるので、案内には件数とコマンドの場所だけを書きます。
読もうとした時の警告
AI が設計記録を読もうとすると、別の hook が実行前にその記録の状態を調べて、必要な時だけ AI に知らせます。
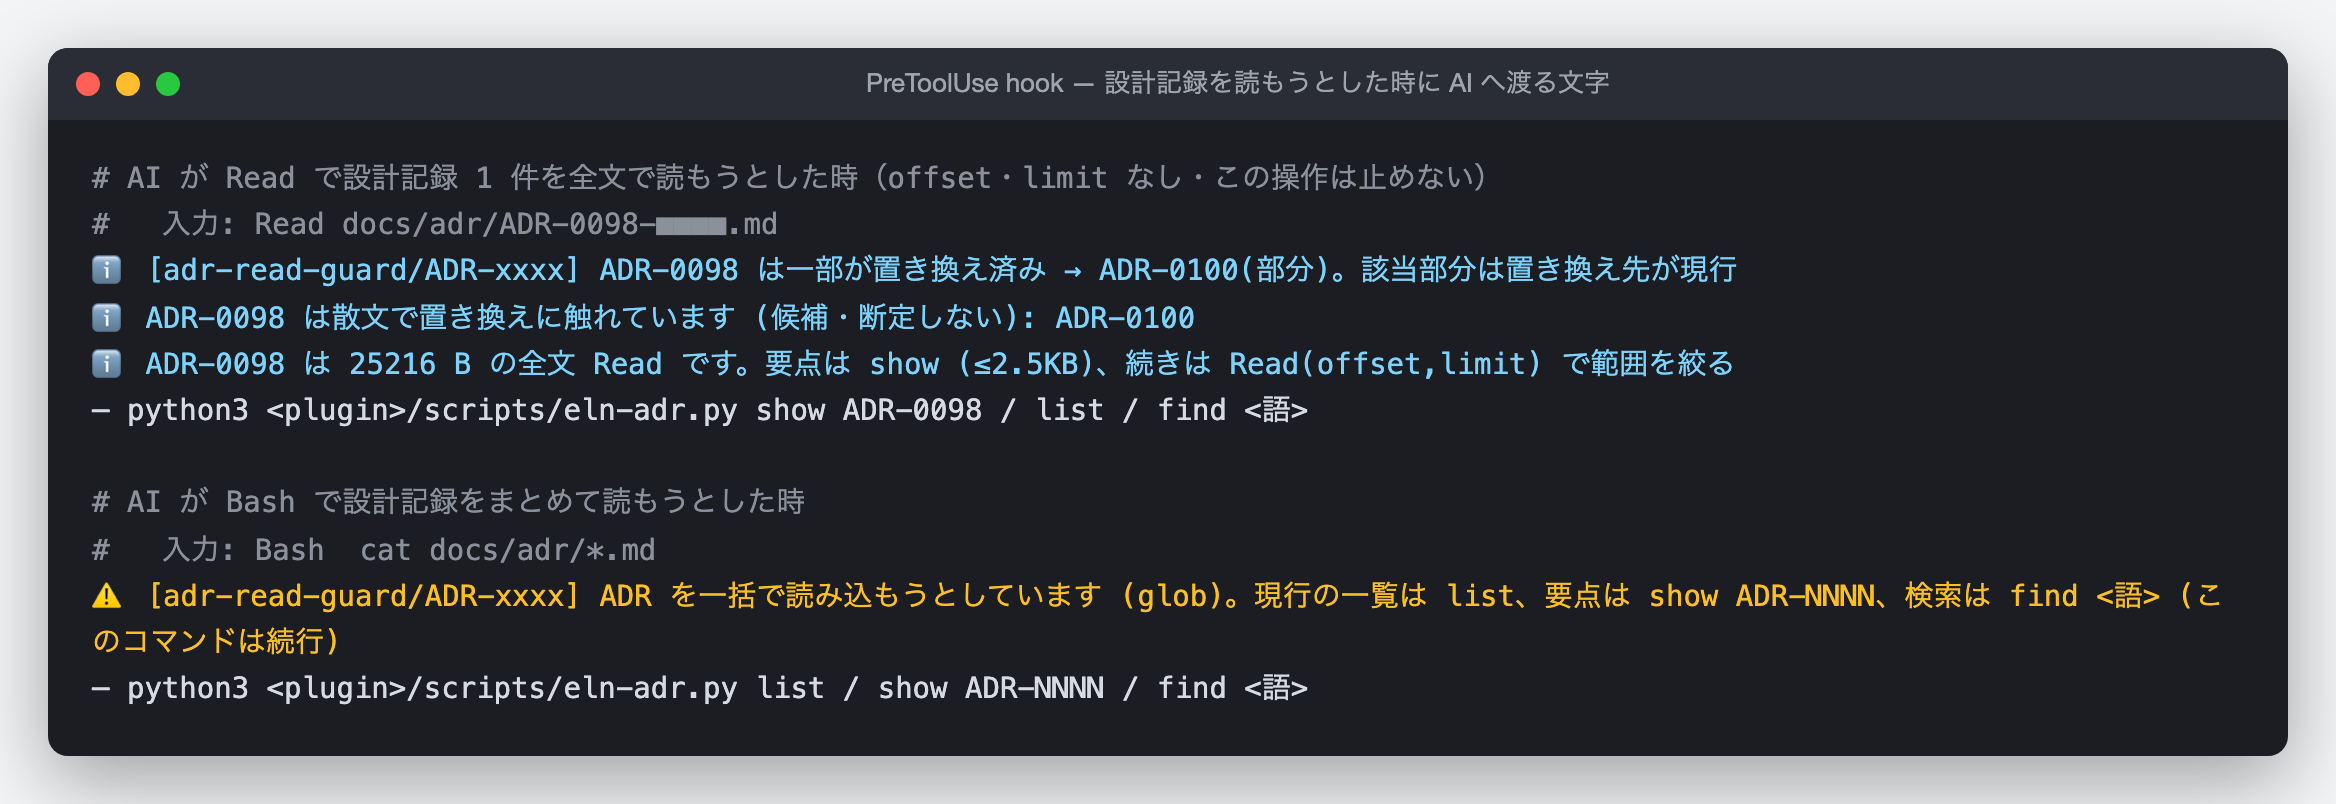
ポイントは 3 つです。
- Read でも cat でも出ます。 本文の読みの 3 分の 2 は cat などのシェルのコマンドだったので、両方を見ます。シェルの場合は cat・head・tail・sed・awk・bat・less・more の引数に設計記録のフォルダがあるかを決まった形で調べます。
- 知らせ方を分けています。 置き換え済みの記録は ⚠️ を付けて置き換え先を示します。一部が置き換え済みの記録や、約 1 万 6 千バイトを超える記録の全文読みは ℹ️ を付けて
showを案内します。3 件以上やまとめての読み込みは、一括の読み込みとして知らせます。 - 止めません。 警告が本当に必要な場面で出ているかを、記録を取りながら確かめるためです。記録した警告が 25 回以上あり、外れが 5% 以下になった時に、置き換え済みの記録を読む前だけ人の許可を求める形に上げる、と決めてあります。
警告の文には、eln-adr の場所を必ず書いています。起動時の要約は、Claude Code が内部で起こす別の AI(サブエージェント)には届かないので、そういう AI にとってはこの警告が唯一の案内になるからです。
要点だけを引く eln-adr show
警告で案内する show は、1 件の要点を 2.5 KB 以内で返します。
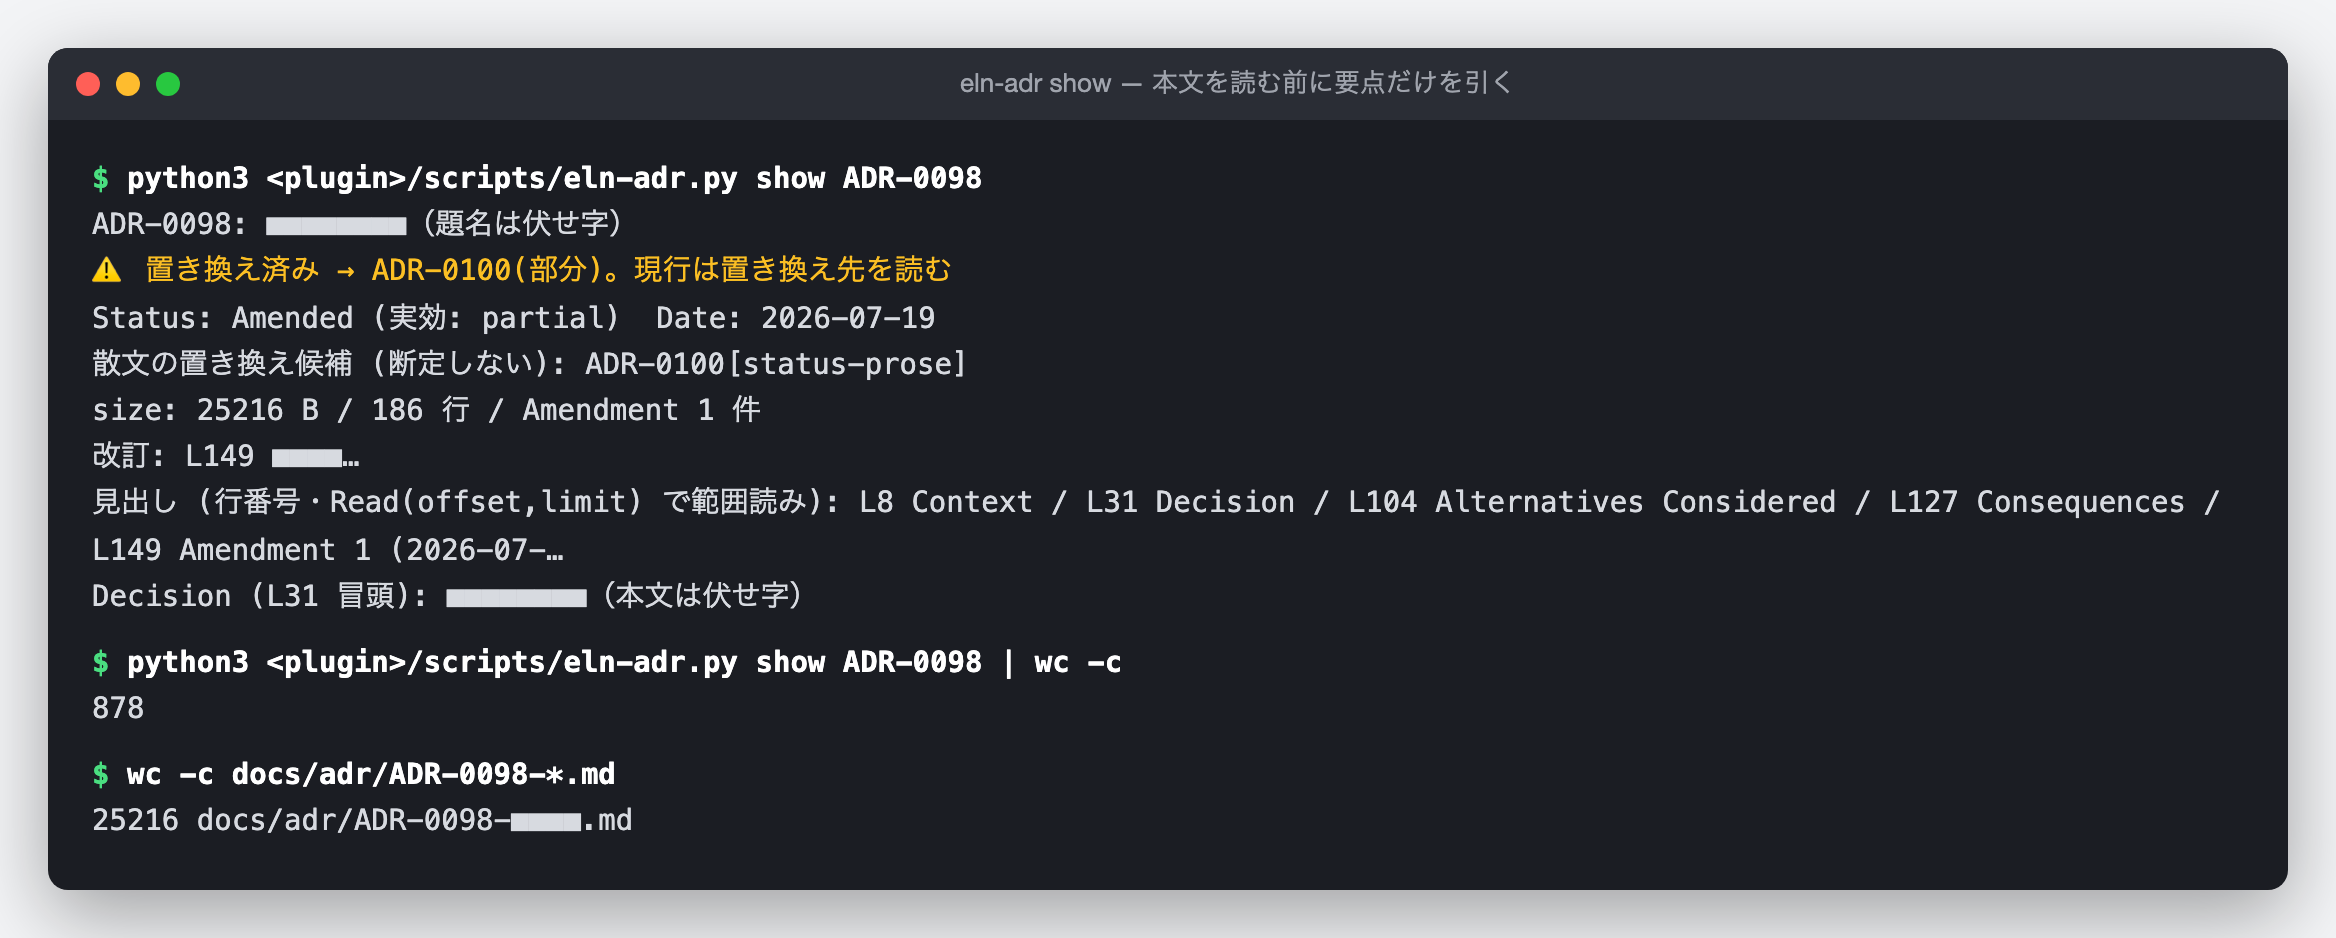
この例では、25,216 バイトの記録が 878 バイトになっています。状態、置き換え先、改訂の一覧、見出しの行番号、決定の冒頭が分かるので、続きを読む必要がある時は、見出しの行番号を使って必要な範囲だけを読めます。
show は、一部だけが置き換え済みの記録にも ⚠️ を付け、置き換え先に「(部分)」を添えて、その部分は置き換え先を読むよう促します。記録そのものは現行に数えたままで、Status の行の「実効: partial」がそれを示しています。
CI のチェックと、1 つのコマンドでの書き換え
索引が正しくても、新しく書く記録の欄が崩れていれば、また読み違えが生まれます。そこで CI(PR ごとに自動で走る検査)で、PR で追加・変更した設計記録の、変わった欄だけを厳密な書き方で検査します。状態の言葉、- Date: YYYY-MM-DD の行、置き換えの欄の書き方、置き換えが片方の記録にしか書かれていないこと、番号の重複などを、理由のコードつきで止めます。触っていない古い記録は止めません。167 件を一度に書き直さなくても、変えたところから順に厳密になります。
採択・改訂・置き換えは、手で両方の記録を書き換えるのではなく、1 つのコマンドで行います。たとえば eln-adr supersede <旧い記録> --by <新しい記録> は、旧い記録の「置き換えた先」、新しい記録の「置き換えた記録」、索引の表をまとめて書き換えます。既定は確認だけで、--write を付けた時だけ書きます。書く前に、書いた後の中身をもう一度読み取り、次のどれかに外れたら、どのファイルも書かずに止まります。
- 書き換える欄の外の行が変わっていない
- CI のチェックで止まるものが 0 件
- 同じコマンドをもう一度実行しても中身が変わらない
- 欄に元からあった宣言が消えていない
6. 結果
変更前は 167 件、変更後はこの仕組みの設計記録が 1 件増えた 168 件の時点で、同じコマンドで測りました。
| 項目 | 変更前 | 変更後 |
|---|---|---|
| 起動時に AI へ渡る文字 | 3,511 バイト(番号の古い 30 件) | 1,140 バイト(件数・置き換え済みの表・新しい順 10 件) |
| 索引に見える有効な記録 | 126 件 | 155 件 |
| 置き換え済みの表 | 0 行 | 5 行(ほかに採択待ち 2 件) |
| 「残りはフォルダの一覧で」の案内 | あり | なし |
その後、179 件になった時点で数字を取り直しました。
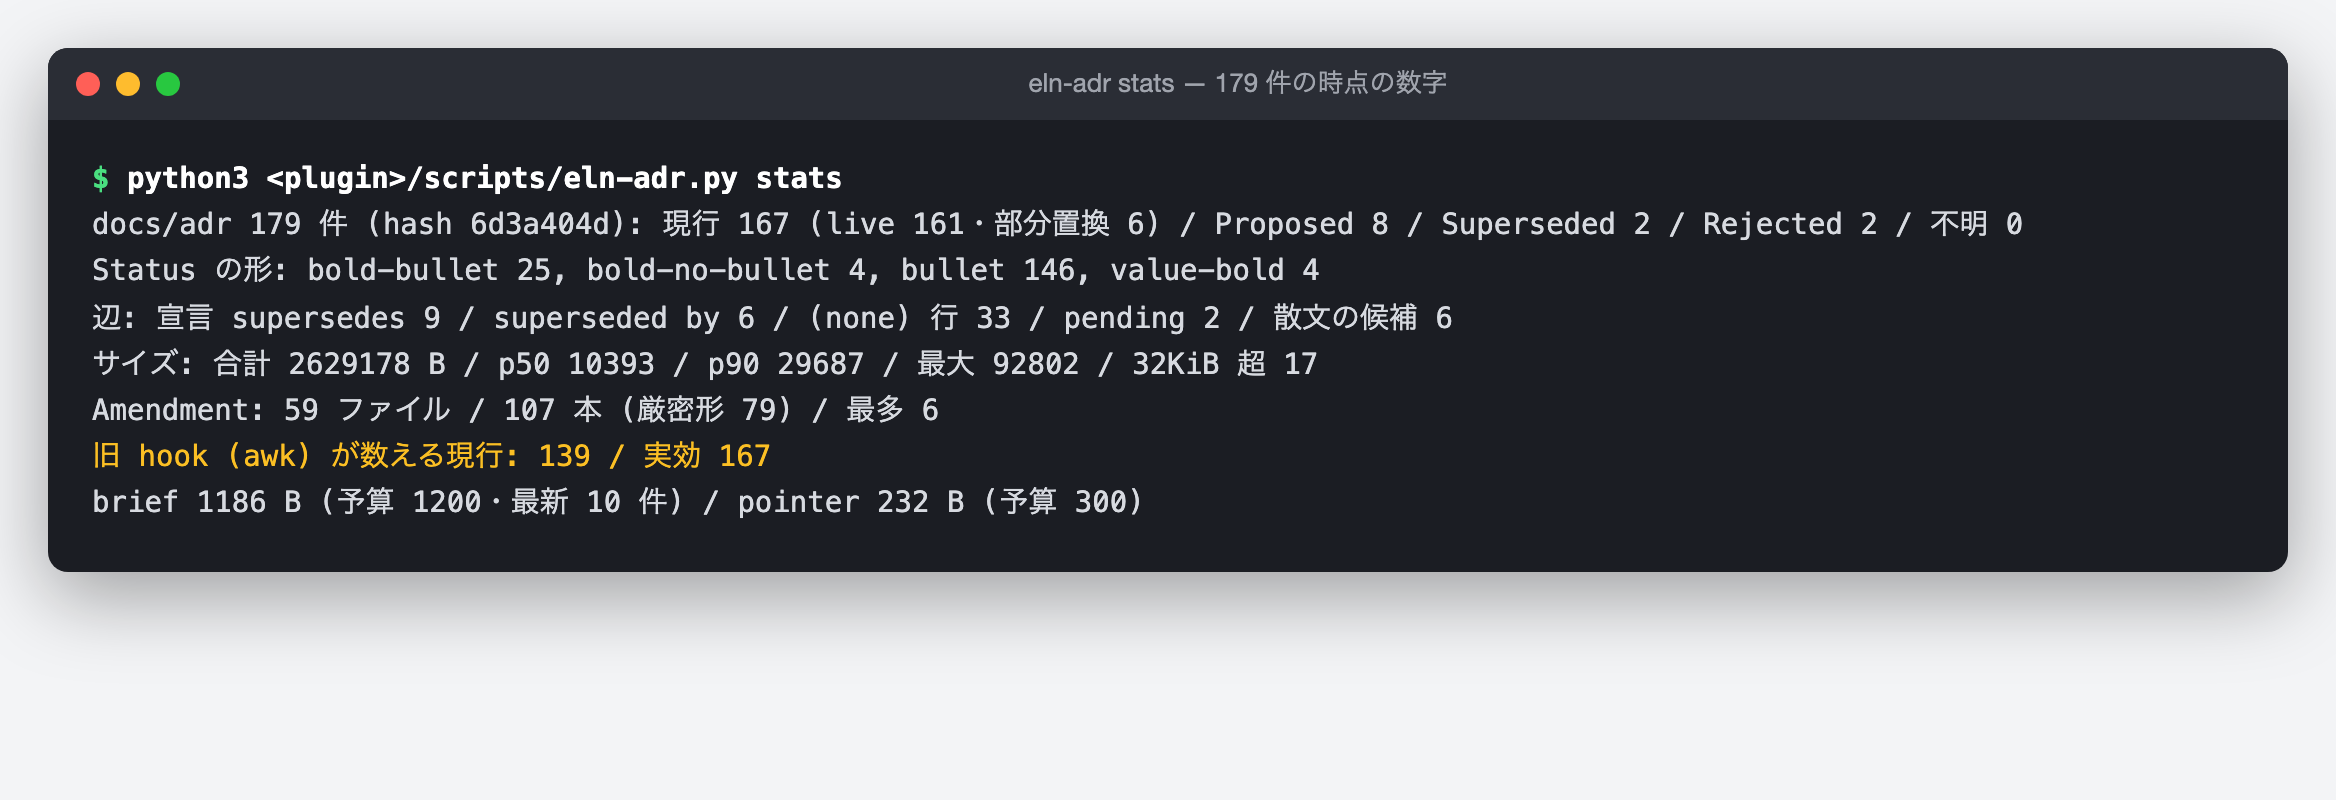
- 179 件のうち現行は 167 件です。 そのまま有効が 161 件、一部が置き換え済みが 6 件です。提案中 8 件、置き換え済み 2 件、却下 2 件、読めないものは 0 件でした。
- 以前の仕組みの数え方なら、現行は 139 件しか見えません。 28 件は以前の仕組みからは見えない計算です。今の索引は 167 件全部を数えています。
- 起動時の要約は 1,186 バイトです。 12 件増えても、決めた上限の 1,200 バイトに収まっています。会話を要約し直した時の案内は 232 バイト(上限 300 バイト)です。
締め
設計記録は、増えても消さずに残してよい。問題は残すことではなく、「どれが現行か」を AI に本文から推し量らせることでした。そのままでは、件数が増えるほど起動時の一覧は古い決定に偏り、AI は名前で選んだ本文を 1 件ずつ開くことになり、そのぶんトークンも使います。
答えは、1 つの決まった規則から毎回作る索引に持たせました。起動時の要約で今の状態を渡し、古い記録を読もうとした時に置き換え先を知らせ、新しく書く記録は CI とコマンドで厳密な書き方にそろえます。規則を作る時に一番効いたのは、何を推し量らないかを先に決めたことでした。そうしないと、読み取りの処理が有効な決定を「置き換え済み」と言ってしまいます。
補足: 前提と用語
- 設計記録(ADR)。 Architecture Decision Record の略で、設計の判断と、その理由、検討した他の案を 1 件ずつ残す文書です。番号を振って
docs/adr/というフォルダに置くのが一般的です。先頭に状態(採択 Accepted・改訂 Amended・提案中 Proposed・置き換え済み Superseded・却下 Rejected)と、置き換えた記録・置き換えた先の欄を書きます。 - hook。 Claude Code が決まったタイミング(起動した時、ツールを使う前など)に自動で実行するスクリプトです。起動した時のものを SessionStart、ツールを使う前のものを PreToolUse と呼びます。hook の出力は AI のコンテキストに入ります。
- Read と Bash。 Claude Code の AI がファイルを読む方法です。Read はファイルを読む専用の機能、Bash はシェルのコマンド(cat・sed など)を実行する機能です。
- PR と CI。 PR(プルリクエスト)は変更を本流に取り込む前の確認の単位、CI は PR ごとに自動で走る検査です。
- コンテキストとトークン。 コンテキストは、AI がその会話の中で読める文字の全体です。トークンは AI が読み書きする文字の量の単位で、多いほど料金と応答の時間が増えます。
- 画面について。 本文の 4 枚の図は、hook と
eln-adrを自社のリポジトリで実行した実際の出力を、文字はそのままに端末の形に並べ直したものです。変えたのは次の点です。コマンドの場所(自分のパソコンのフォルダ名を含む)を<plugin>/scripts/eln-adr.pyに縮めたこと、警告や要約の頭に付く札の中の、この仕組み自体の設計記録の番号をADR-xxxxにしたこと、要約の「最新」に並ぶ 10 件の題名と、図 2・図 3 で例に使った設計記録の題名・本文を ■ の伏せ字にしたことです(社内の仕組みの名前や中身を含むため)。番号は、ツールが表示する実際のものです。 - 数字の時点。 変更前後の比較は設計記録が 167 件(変更前)と 168 件(変更後)の時点、今の数字は 179 件になった時点で、同じコマンドで測っています。会話の記録の回数は、AI がツールに渡した入力を数えたものです。
この ELN workflow(AI開発の品質を仕組みで守る自社プラグイン)についての記事は、考え方・スキルの中身・実際に防いだ事故を、順次シリーズとして公開していきます。 興味のある方は、ぜひ「いいね」と記事の購読をお願いいたします。
自社プロダクトの一覧は https://www.eln.ne.jp/products にまとめています。
筆者について
上原正吉。EarthLink Network Co., Ltd. 代表。AI社員に日々の業務を任せ、開発では人が逐一指示しなくても作業が進むHOOTL(Human Out Of The Loop)の仕組みを自社で実践しています。このブログでは、業務自動化と24時間自動開発のノウハウ、具体的な設定方法、日々の運用で見つかった問題と改善を共有します。
また、AIで業務や開発を組み替えたい会社・チーム向けに、AI活用のコンサルティングも受け付けています。ご相談は www.eln.ne.jp からどうぞ。
EarthLink Network は、会社の全業務を AI で回すために、必要になったものを自社で作っています。いま作っているプロダクトの一覧と概要は、こちらにまとめています。
→ EarthLink Network が自社でつくっている18のプロダクト
会社と各プロダクトの詳細は、公式サイト www.eln.ne.jp をご覧ください。