規律は文書ではなくスキルで配る — ELN workflow の165スキルを紹介します
上原正吉(EarthLink Network Co., Ltd.)。Claude Codeを開発の主体に据え、20を超えるプロダクトを1人で同時に開発・運用しています。これは、その現場の実測記です。
規律は文書ではなくスキルで配る — ELN workflow の165スキルを紹介します
結論
- 何を作ったか: 開発の規律・品質基準・仕様プロセスを、Claude Code のスキル(AIが従う手順書と強制ゲートのセット)として実装し、全プロジェクトへ配る自社プラグイン群
ELN workflowです。スキルは2026年9月時点で165個あります。 - なぜ作ったか: 開発標準は、文書に書いただけでは守られないからです。守られるのは、手順に組み込まれたときだけです。人が忘れても、AIが忘れても、ゲートが先へ進めなければ規律は実行されます。
- 何が要点か: AIに開発を任せるほど、「AIが正しくやったか」を人が毎回確かめる作業がボトルネックになります。その確認そのものを機械化して配る、というのがこのプラグインの役割です。
本文(読了 約7分)
この連載で紹介してきた認証・通知・課金は、どれも「全製品で必ず要る機能」を基盤に寄せた話でした。今回は毛色が違います。寄せたのは機能ではなく、開発のやり方そのものです。
「守ってください」は守られない
私たちは20を超える製品を、人間の担当者1名とAIを実行主体にしたチームで開発しています。この体制で一番困るのは、コードを書く速度ではありません。品質のばらつきです。
たとえば「テストが通ってから完了と言う」「設計判断は記録に残す」「課金に影響する変更はコストを試算してから」。どれも文書には書いてありました。それでも、AIは平気で「完了しました」と言いますし、人も急いでいると手順を飛ばします。文書を増やしても、この問題は解けませんでした。
そこで発想を変えました。規律を文書ではなく、Claude Code のスキルとして実装する。スキルは該当する状況になると自動で読み込まれ、条件を満たさない操作をその場で止めます。「守ってください」ではなく、守らないと先に進めない。この形にしてから、規律は初めて全プロジェクトで同じように実行されるようになりました。
165スキルの全体像
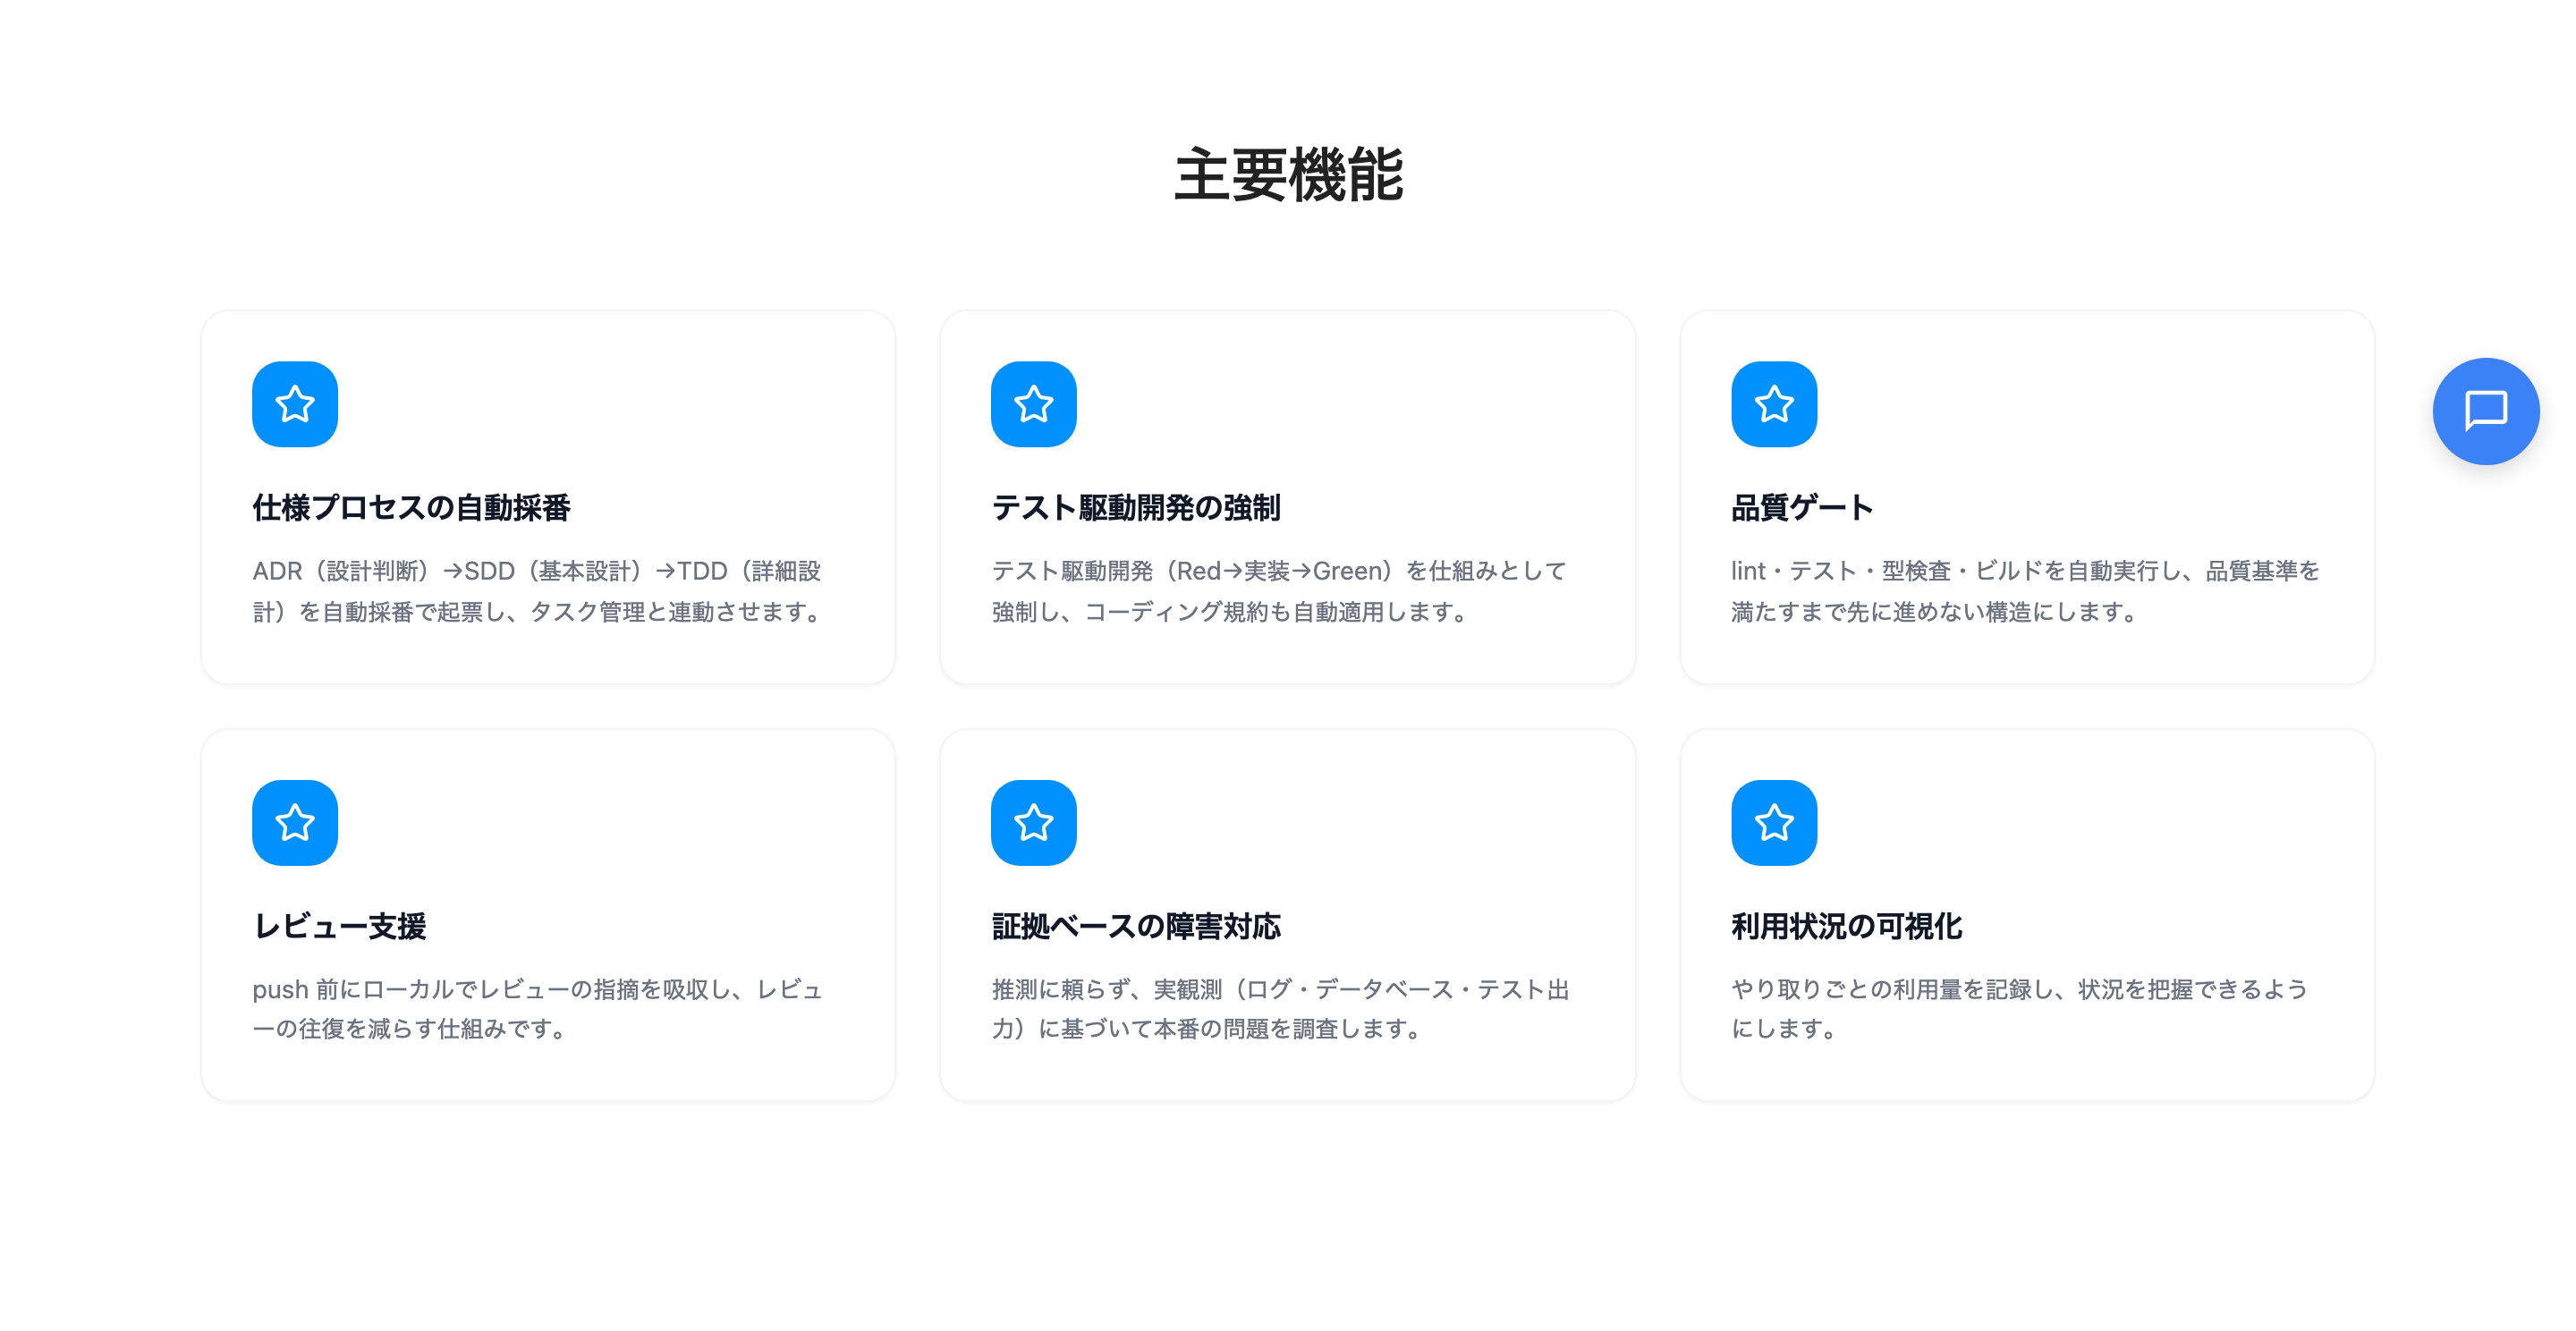
スキルは現在165個、3つのプラグインに分かれています。品質と規律の本体(139個)、進行管理(12個)、事業・コンテンツ制作(14個)です。スキルのほかに、自動チェック(hook)が50本、専門の下請けAI(agent)が14体、同じプラグインに同梱されています。全部は紹介しきれないので、カテゴリごとに代表例を案内します。
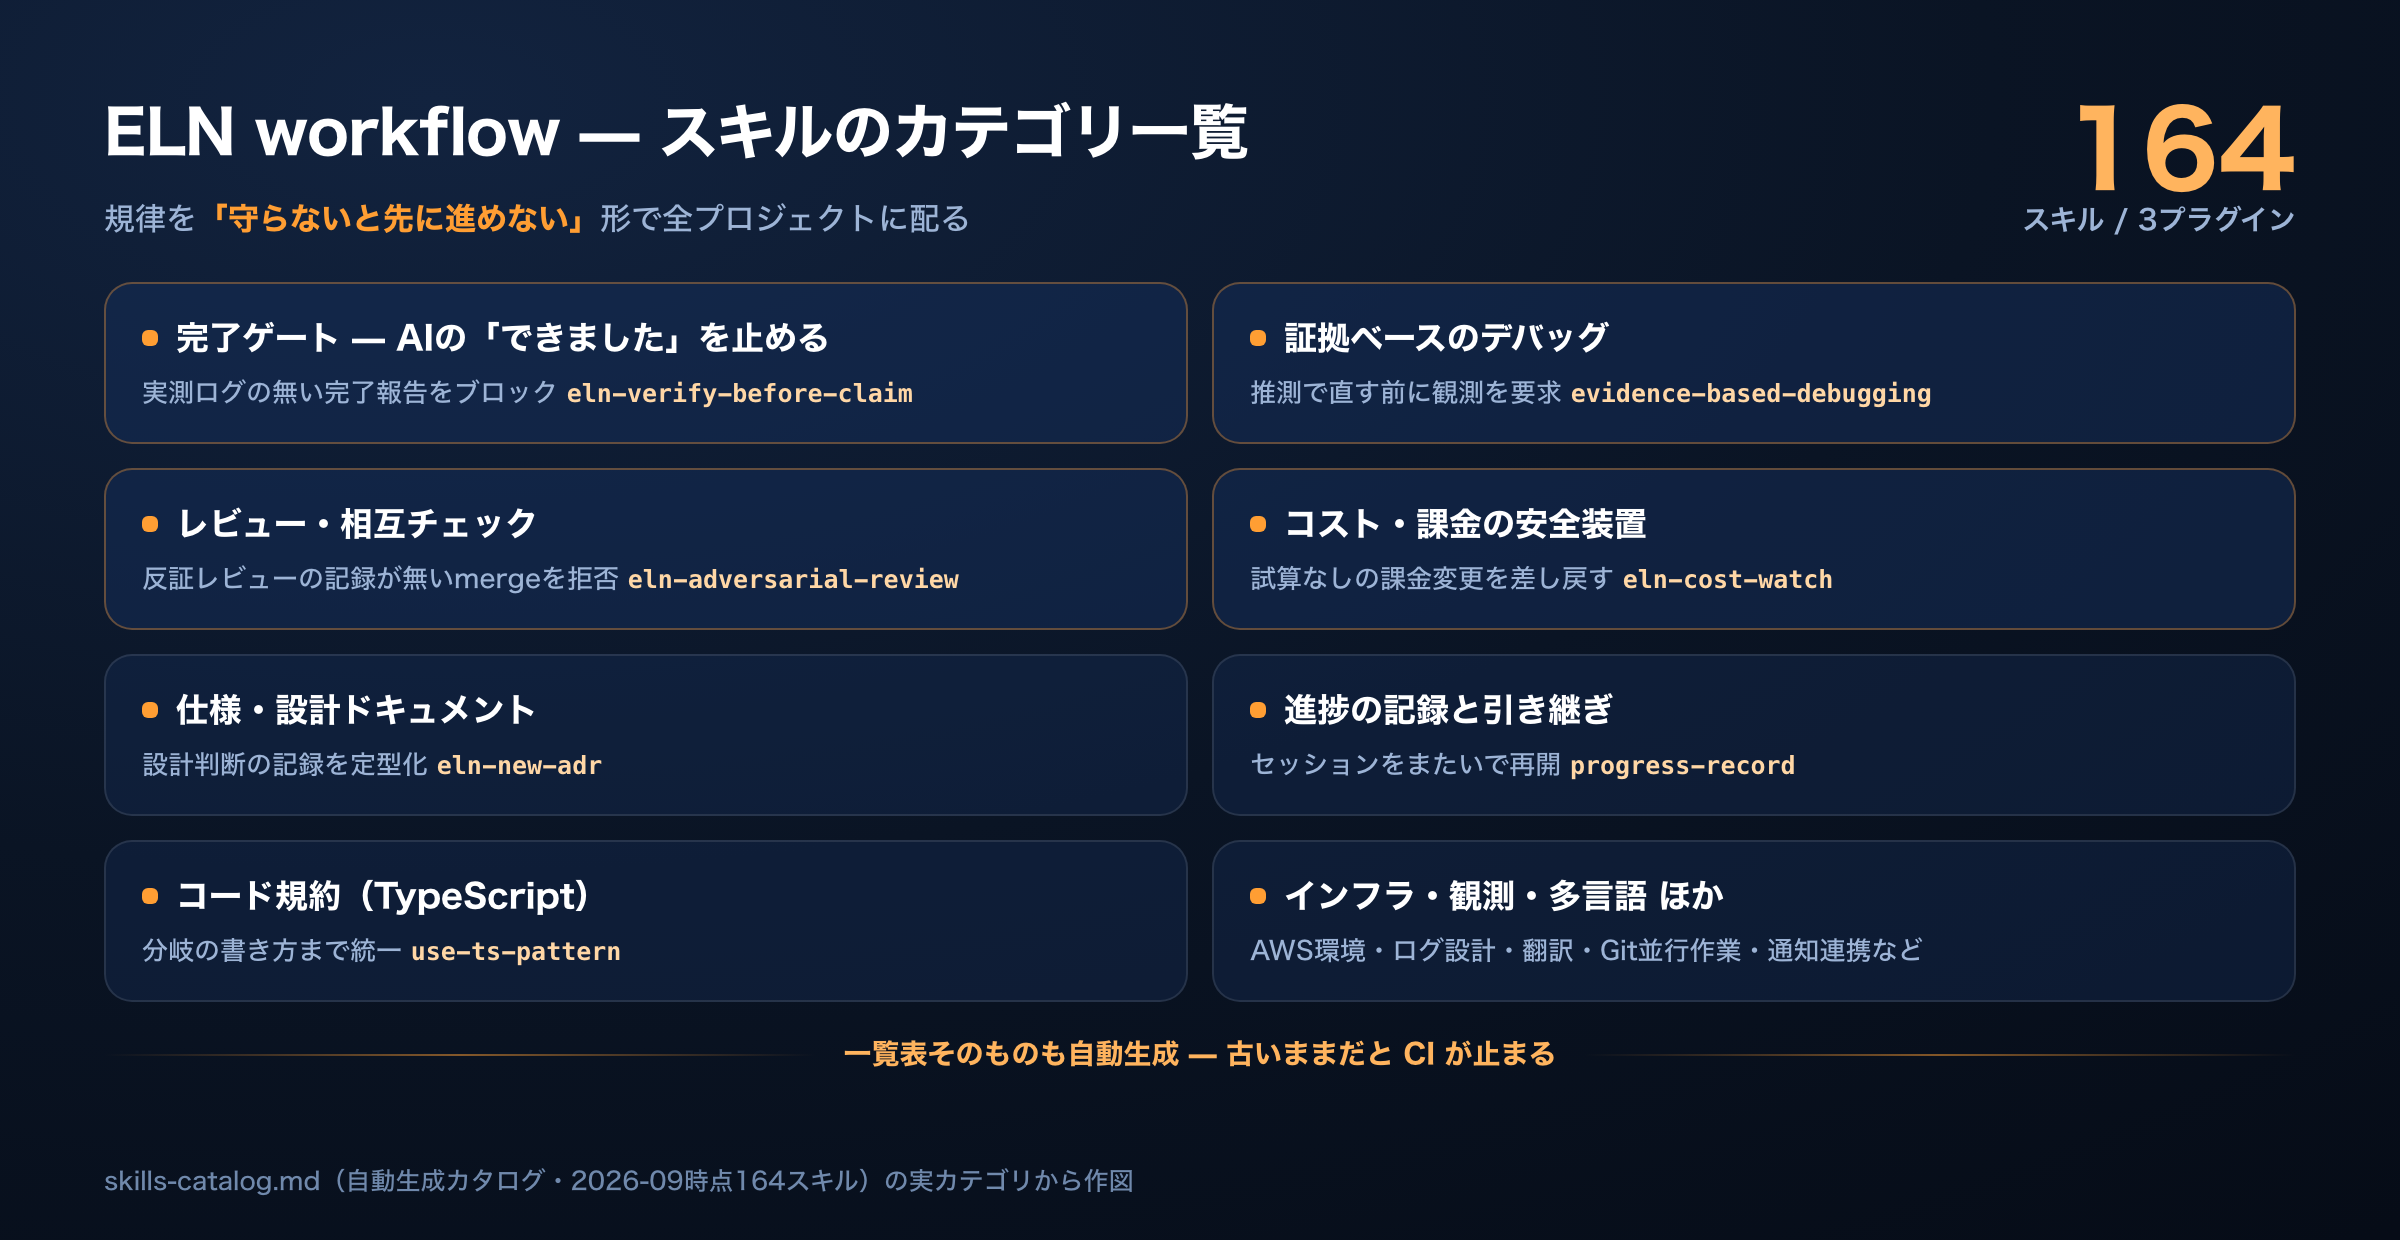
- 完了ゲート(AIの「できました」を止める) — 代表例
eln-verify-before-claim。実測ログ・テスト出力・実機確認のない完了報告をブロックします。ビルドが通っただけで「完了」と言わせません。 - 証拠ベースのデバッグ — 代表例
evidence-based-debugging。本番バグの調査で、推測でコードを直す前にログ・DB・実リクエストの観測を要求します。 - レビュー・相互チェック — 代表例
eln-adversarial-review。実質的な変更をmainへ取り込む前に、複数の観点から反証を試みる敵対的レビューを必須にします。record が無い merge は機械的に拒否されます。 - コスト・課金の安全装置 — 代表例
eln-cost-watch。課金に影響する変更の前に月額の試算を要求し、変更後は実測で収束を確認するまで「下がった」と言わせません。 - 仕様・設計ドキュメント — 代表例
eln-new-adr。設計判断を残す記録の起票・更新をテンプレートと索引つきで定型化します。 - 進捗の記録と引き継ぎ — 代表例
progress-record。調査や試行錯誤の途中経過をgit管理のログへ残し、セッションが変わっても続きから再開できるようにします。 - コード規約 — 代表例
use-ts-pattern/no-else-no-default。TypeScriptの分岐の書き方まで、レビュー指摘ではなくスキルで統一します。
このほかに、インフラ・AWS・環境、観測・ログ、セキュリティ、多言語化、Git並行作業、通知・チーム連携などのカテゴリがあります。
面白いところを、もう少し具体的に
概要だけでは伝わらないので、実際にあるスキルをいくつか紹介します。名前と役割は実物のままです。
AIの報告を信用しないためのスキル
eln-verify-before-claim— 「完了しました」と言う直前に、主張と証拠(実測ログ・テスト出力)を機械照合します。証拠が無ければ報告できません。eln-report-guard— 「ビルドが通った」「unitテストが通った」のような弱い代理証拠だけの完了報告を止め、実機観測へ昇格させます。answer-the-question-first— 「終わった?」に対して、経緯の説明から始めず最初の一文で直答させます。eln-execute-dont-defer— AIが「これは手動でやってください」と人に丸投げするのを止めます。自分で実行できる作業は実行させます。no-tracked-leftovers-at-goal— 残タスクがあるのに「完了」と宣言するのを止めます。完了の合図は残タスクゼロです。
調査・デバッグの規律
evidence-based-debugging— バグ調査で推測のままコードを直すのを禁止し、先にログ・DB・実リクエストの観測を要求します。zero-result-query-check— 検索やクエリが0件だったとき「存在しない」と即断させません。検索条件そのものの妥当性を先に検証します。classify-failure-before-rerun— CIが落ちたとき、原因を分類してから再実行します。「とりあえずもう1回」の盲目リトライを防ぎます。read-current-state-before-implementing— 実装に入る前に対象の現状を一次情報で読ませます。すでにある機能の二重実装を防ぎます。
お金と本番を守るスキル
eln-cost-watch— 課金に影響する変更の前に月額試算を要求し、変更後は実測が収束するまで「コストが下がった」と言わせません。dynamodb-best-practices— データベース設計の段階で月額コストを数字で出させます。試算なしの着手は差し戻されます。billing-safety— 決済・課金コードに触れるときの専用規律です。二重課金・誤請求につながる変更を止めます。verify-after-deploy— デプロイして終わり、を禁止します。本番での実機検証までがデプロイです。eln-deploy-target-checklist— 変更が反映されるべきデプロイ先を全列挙し、一部だけ反映した状態で「完了」と言わせません。
チームとして働くためのスキル
eln-adversarial-review— mainに取り込む前に、複数の観点から反証を試みる敵対的レビューを必須にします。記録が無いmergeは機械的に拒否されます。eln-codex-cross-check— 別のAI(Codex)に読み取り専用でクロスレビューさせ、1つのAIの思い込みを他のAIに突かせます。eln-acceptance-ledger— 会話の途中で増えた「これもやって」を台帳に捕捉し、証拠なしにチェックを付けさせません。progress-record/progress-recall— 調査や試行錯誤の途中経過をgit管理の記録に残し、セッションが変わっても続きから再開できるようにします。prioritize-users-restated-goal-over-current-thread— 人がゴールを言い直したら、進行中の作業より言い直しを優先して再計画させます。
1つずつの中身と、実際に事故を防いだ場面は、このシリーズの記事として順次書いていきます。
ゲートの現物 — 「ダメな完了報告」に名前を付ける
完了ゲートの中身をもう一段だけ具体的に書きます。AIの怪しい報告は、パターンに名前を付けると機械で検知できるようになります。実際に定義している検知クラスの一部です。
FALSE_SUCCESS— 証拠のない「完了しました」WEAK_PROXY— ビルドや単体テストの通過だけを根拠に「本番で動く」と言うMOCK_THEATER— 全部モックのテストが通ったことを「動く」証拠に使うNARROW_PROBE— 1ファイルだけ見て「その機能は存在しません」と断定するFALSE_DEFERRAL— 自分で実行できるコマンド作業を「手動でやってください」と人に返すRESIDUAL_COMPLETION— 残タスクを列挙しながら「完了です」と締める
証拠にも強さの序列を定義しています。静的検査<単体テスト<結合テスト<実機の通し検証<本番の実観測。外部との境界(決済・Webhook・デプロイ)に関わる主張は、実機以上の証拠がないと通しません。
会話の最後にも門番がいます。応答が「完了」を宣言して終わろうとした瞬間、文章ではなくgitの実状態と照合します。mainに取り込まれていない変更はないか。開いたままのPRはないか。未コミットの変更は残っていないか。1つでも残っていれば宣言は差し戻され、未完了の項目が具体名で列挙されます。
賢いゲートは作らない — 測定で決めた設計原則
ここまで読むと「ゲートをもっと賢くすればいい」と思えてきますが、逆の教訓もあります。
一度、完了ゲートに「証拠が本物かどうか」をパターン照合で判別させる案を検討しました。実際の記録191行に当てて測定したところ、本物の証拠の76%を誤って偽物と弾きました。この測定を根拠に、方針を固定しています。機械のゲートに持たせるのは構造の検査(記録があるか・残件がゼロか・書式を満たすか)だけ。内容が本物かという意味の判断は、独立したレビューアー(別のAIまたは人間)に切り離す。ゲートを賢くする誘惑は、測定で棄却されました。
新しいゲートの導入手順も決めています。いきなり操作を止めるのではなく、まず「観測モード」で警告の記録だけを貯め、誤検知の率を実測してから止める側へ昇格させます。あるガードは、直近30日・400セッションの実行履歴を解析して「止めるべき操作は月に9件程度で、ほぼ全部が本物」と確認してから遮断を有効にしました。正しそうなルールでも、誤爆率を測るまでは人を止めない。ゲートを増やす側の責任だと思っています。
もう1つの原則は、ゲートは絶対に人を閉じ込めないことです。検査ツールが壊れていたら素通しにし(止まるのではなく)、遮断の解除手段は利用者本人の明示操作だけに限定し、AIが自分で解除できる抜け道は意図的に作っていません。
ゲートが生まれる瞬間 — 失敗3連発の記録
スキルの多くには、生まれるきっかけになった実際の失敗があります。3つ挙げます。
検索0件の誤診(4月)。 データベースのログを timestamp という項目名で検索して0件になり、「ログ基盤が壊れている」と誤診しました。正しい項目名は createdAt で、実際には7,406件のログがありました。以来、0件のときは項目名・型・期間を検証し、フィルタなしの検索で「データ自体はある」ことを確かめてからでないと「存在しない」と言えないスキルが動いています。
1日43ドルの請求(9月3日)。 増え続けるテーブルへの定期読み取りを、試算なしで追加した結果です。1日あたり読み取り3.0億ユニット。事後に式へ当てはめると、請求額とほぼ一致しました。事前にこの1行を出していれば防げた——だから今は、データベースを触る設計の前に「読み取り量×単価」の式で月額を数字にしないと先へ進めません。
文面は素通りした(9月6日)。 皮肉なことに、コスト規律をスキルの文面として正典化した3日後に、課金に影響する設定変更が試算ゼロのまま実行されました。文書もスキルの文面も、実行の瞬間に読まれなければ効かない。この失敗で、コスト系の規律は「コマンドが実行される瞬間に割り込む」ゲートへ昇格しました。いまは課金構成を変えるコマンドは、試算の台帳が無いと実行そのものが拒否されます。
失敗のたびに、同じ失敗を機械的に不可能にする。スキルが165個あるのは、それだけ失敗してきたという記録でもあります。失敗を人の反省で終わらせるか、機械のゲートに変換するか。この違いが、半年後の事故率を分けます。
カタログ自体も、仕組みで守る
165個にもなると、作った本人でもすべての用途と呼び出し方は覚えられません。実際、7月2日に90個だったスキルは、7月20日に121個、8月に154個、いまは165個です。増える一覧を手書きで管理すると、必ず実体とずれます。
だからスキルの一覧表も自動生成にしました。各スキルの登録情報には、分類・目的・使いどき・呼び出し方の4項目が必須で、この情報だけからカタログが機械生成されます。カタログは16カテゴリに分かれ、呼び出し方も3分類で整理されています。状況に反応して自動で読み込まれるものが69個、名前で明示的に呼ぶものが68個、任意のタイミングで使うものが28個。使う側は「迷ったら明示呼び出しの68個だけ覚えればよい」という案内にしています。
仕組みとしても二重化してあり、必須項目が無ければ生成が止まり、保存済みのカタログが古ければCI(変更を継続的に検査する仕組み)が止まります。手書きの一覧がこっそり残っていて実体と4つの数字が食い違った失敗も経験していて、その顛末は別の記事に書いています。
規模感 — 4か月半でリリース289回
このプラグイン自体の開発も、このプラグインの規律の下で行っています(自分たちで毎日使うことが品質の源泉です)。最初のコミットは2026年4月28日。そこから4か月半でコミット547件、バージョンは289回改定されました。設計判断の記録(ADR)は139本。スキルの手順書は全部で26,000行を超えています。
もう1つの層として、セッションで得た行動の教訓を短い1行に圧縮した「本能」を134件蓄積していて、毎セッションの開始時に確信度の高い順で自動注入しています。スキルが「守るべき手順」だとすると、本能は「過去に失敗した状況の勘所」です。ルールは配るだけでなく、経験も配る。AIとの開発体制では、この2層があって初めてプロジェクトをまたいだ学習が回ります。
読者のチームでどう活きるか
このプラグイン自体は社内用ですが、考え方は転用できます。
- チームの「守られないルール」を1つ選び、文書から手順の中のゲートへ移してみてください。コミット前フック、CIの必須チェック、テンプレートの必須項目。置き場所はどこでも、「守らないと先に進めない」形になっているかが分かれ目です。
- AIに開発を任せているなら、AIの完了報告に証拠(実測ログ・テスト出力)を要求するゲートから始めるのが効果的でした。私たちの165個も、最初はそこから増えていきました。
転用できる教訓
- 開発標準は文書では守られません。手順に組み込まれ、守らないと先に進めない形になったときだけ守られます。
- AIとの開発では「AIの申告を検証するゲート」が品質の中心になります。完了報告・デバッグ・レビュー・コストの4か所から始めると効きます。
- ルールが増えるなら、ルールの一覧も自動生成にします。手書きの一覧は必ず実体とずれます。
- 規律の置き場所を1か所(プラグイン)に集めると、新しいプロジェクトの立ち上げ日から同じ品質基準が適用されます。
この ELN workflow(AI開発の品質を仕組みで守る自社プラグイン)についての記事は、考え方・スキルの中身・実際に防いだ事故を、順次シリーズとして公開していきます。 興味のある方は、ぜひ「いいね」と記事の購読をお願いいたします。
自社プロダクトの一覧は https://www.eln.ne.jp/products にまとめています。
筆者について
上原正吉。EarthLink Network Co., Ltd. でAI開発をしています。2025年からClaude Codeを開発の主体に据え、今は20を超えるプロダクトを1人で同時に開発・運用しています。この連載では、その現場で実際に起きたこと(うまくいったことも、失敗も)を、数字と一緒に書いていきます。
また、AIで業務や開発を組み替えたい会社・チーム向けに、AI活用のコンサルティングも受け付けています。ご相談は www.eln.ne.jp からどうぞ。
EarthLink Network は、会社の全業務を AI で回すために、必要になったものを自社で作っています。いま作っているプロダクトの一覧と概要は、こちらにまとめています。
→ EarthLink Network が自社でつくっている18のプロダクト
会社と各プロダクトの詳細は、公式サイト www.eln.ne.jp をご覧ください。