promptflow の Compare で、複数の AI の答えと画像を並べて比べる
上原正吉(EarthLink Network Co., Ltd.)。AI会社・AI社員による業務自動化と、人の逐次介入なしに24時間自動開発を回す仕組みを自社で実践しています。開発ノウハウと具体的な設定方法、運用して分かった改善点を公開しています。
promptflow の Compare で、複数の AI の答えと画像を並べて比べる
promptflow には Chat・Compare・Debate・Co-Draft(日本語の画面では「通常チャット」「比較検討」「AI 会議」「AI 推敲」)の 4 つのモードがあります。この記事は、その中の Compare の説明です。
先に要点をまとめます。読了時間は約10分です。
- Compare は、同じ問いを複数の AI モデルへ同時に送り、答えを横に並べるモードです。文章だけでなく、画像も同じ画面で比べられます。
- 文章用のモデルは、最初の一覧に「おすすめ」の欄と、9 の開発元の 15 件が並ぶ「開発元から選ぶ」の欄が出ます。上級者向けの絞り込みを開くと、303 件から選べます。画像用も同じ 2 つの欄が出て、全部で 147 件です。
- 答えの列ごとに、使った PFC(promptflow の利用量の単位)が出ます。中身と費用を同じ画面で見比べられます。
Compare の画面でできること
promptflow で Compare を開くと、「比較検討モード」の画面になります。上の「テキスト」と「画像」で、文章を比べるか、画像を比べるかを切り替えます。
その下に「比較スロット(モデル × Persona)」が並びます。スロットは、比べたい AI の候補を 1 つずつ入れる行です。各行でモデルと Persona を選び、「スロットを追加」で候補を増やします。Persona は、AI に役割や視点を持たせる設定です。何も選ばなければ「Persona なし(標準)」で、モデル本来の答えが出ます。同じモデルを別のスロットに入れ、Persona だけ変えて比べることもできます。
問いを入力欄に書いて「送信」を押すと、「コスト確認」の画面が出ます。「推定コスト合計」を見て「送信する」を押した時だけ、全部のスロットへ同時に送られます。残高が足りない時は送る前に「PFC残高が不足しています」と出て止まり、「残高・プランを見る」から残高を確かめられます。
文章のモードには「🌐 Web検索」の切り替えもあります。オンにすると、対応しているモデルは Web を検索して答えられるようになります。検索するかどうかは、モデルが問いを見て決めます。対応していないモデルのスロットには「🌐 非対応」と出ます。
答えの列には、検索したかどうかも出ます。検索した列は「🌐 Web検索使用(2 回)」のように回数が出て、参照したページへのリンクが並びます。対応していないモデルの列は「🌐 Web検索非対応 — モデル内部知識のみ」、検索しなかった列は「🌐 検索は実行されませんでした」です。最近の出来事を聞く時は、どのモデルが Web の情報で答え、どのモデルが学習した知識だけで答えたかを、列ごとに見分けられます。
同じモデルで Persona を変えて比べる
スロットには同じモデルを何度でも入れられます。たとえば GPT-5.6 Terra を 2 つのスロットに入れ、片方は「Persona なし(標準)」、もう片方に別の役割の Persona を付けて送ると、モデルの違いではなく、役割の違いで答えがどう変わるかを比べられます。
結果の列はスロットごとに分かれるので、同じモデル名の列が 2 つ並んでも混ざりません。列の見出しの下には「Persona: {名前}」と使った PFC が出ます。モデルを比べる時と、役割を比べる時で、Compare の同じ画面を使い分けられます。
文章を比べる
次の画面は、3 つのモデルに同じ問いを送った結果です。問いは「新入社員向けの、メールの書き方の注意点を3つ挙げてください。」で、モデルは GPT-5.6 Terra(OpenAI)、Claude Sonnet 5.5(Anthropic)、Gemini 3.8 Flash(Google)です。
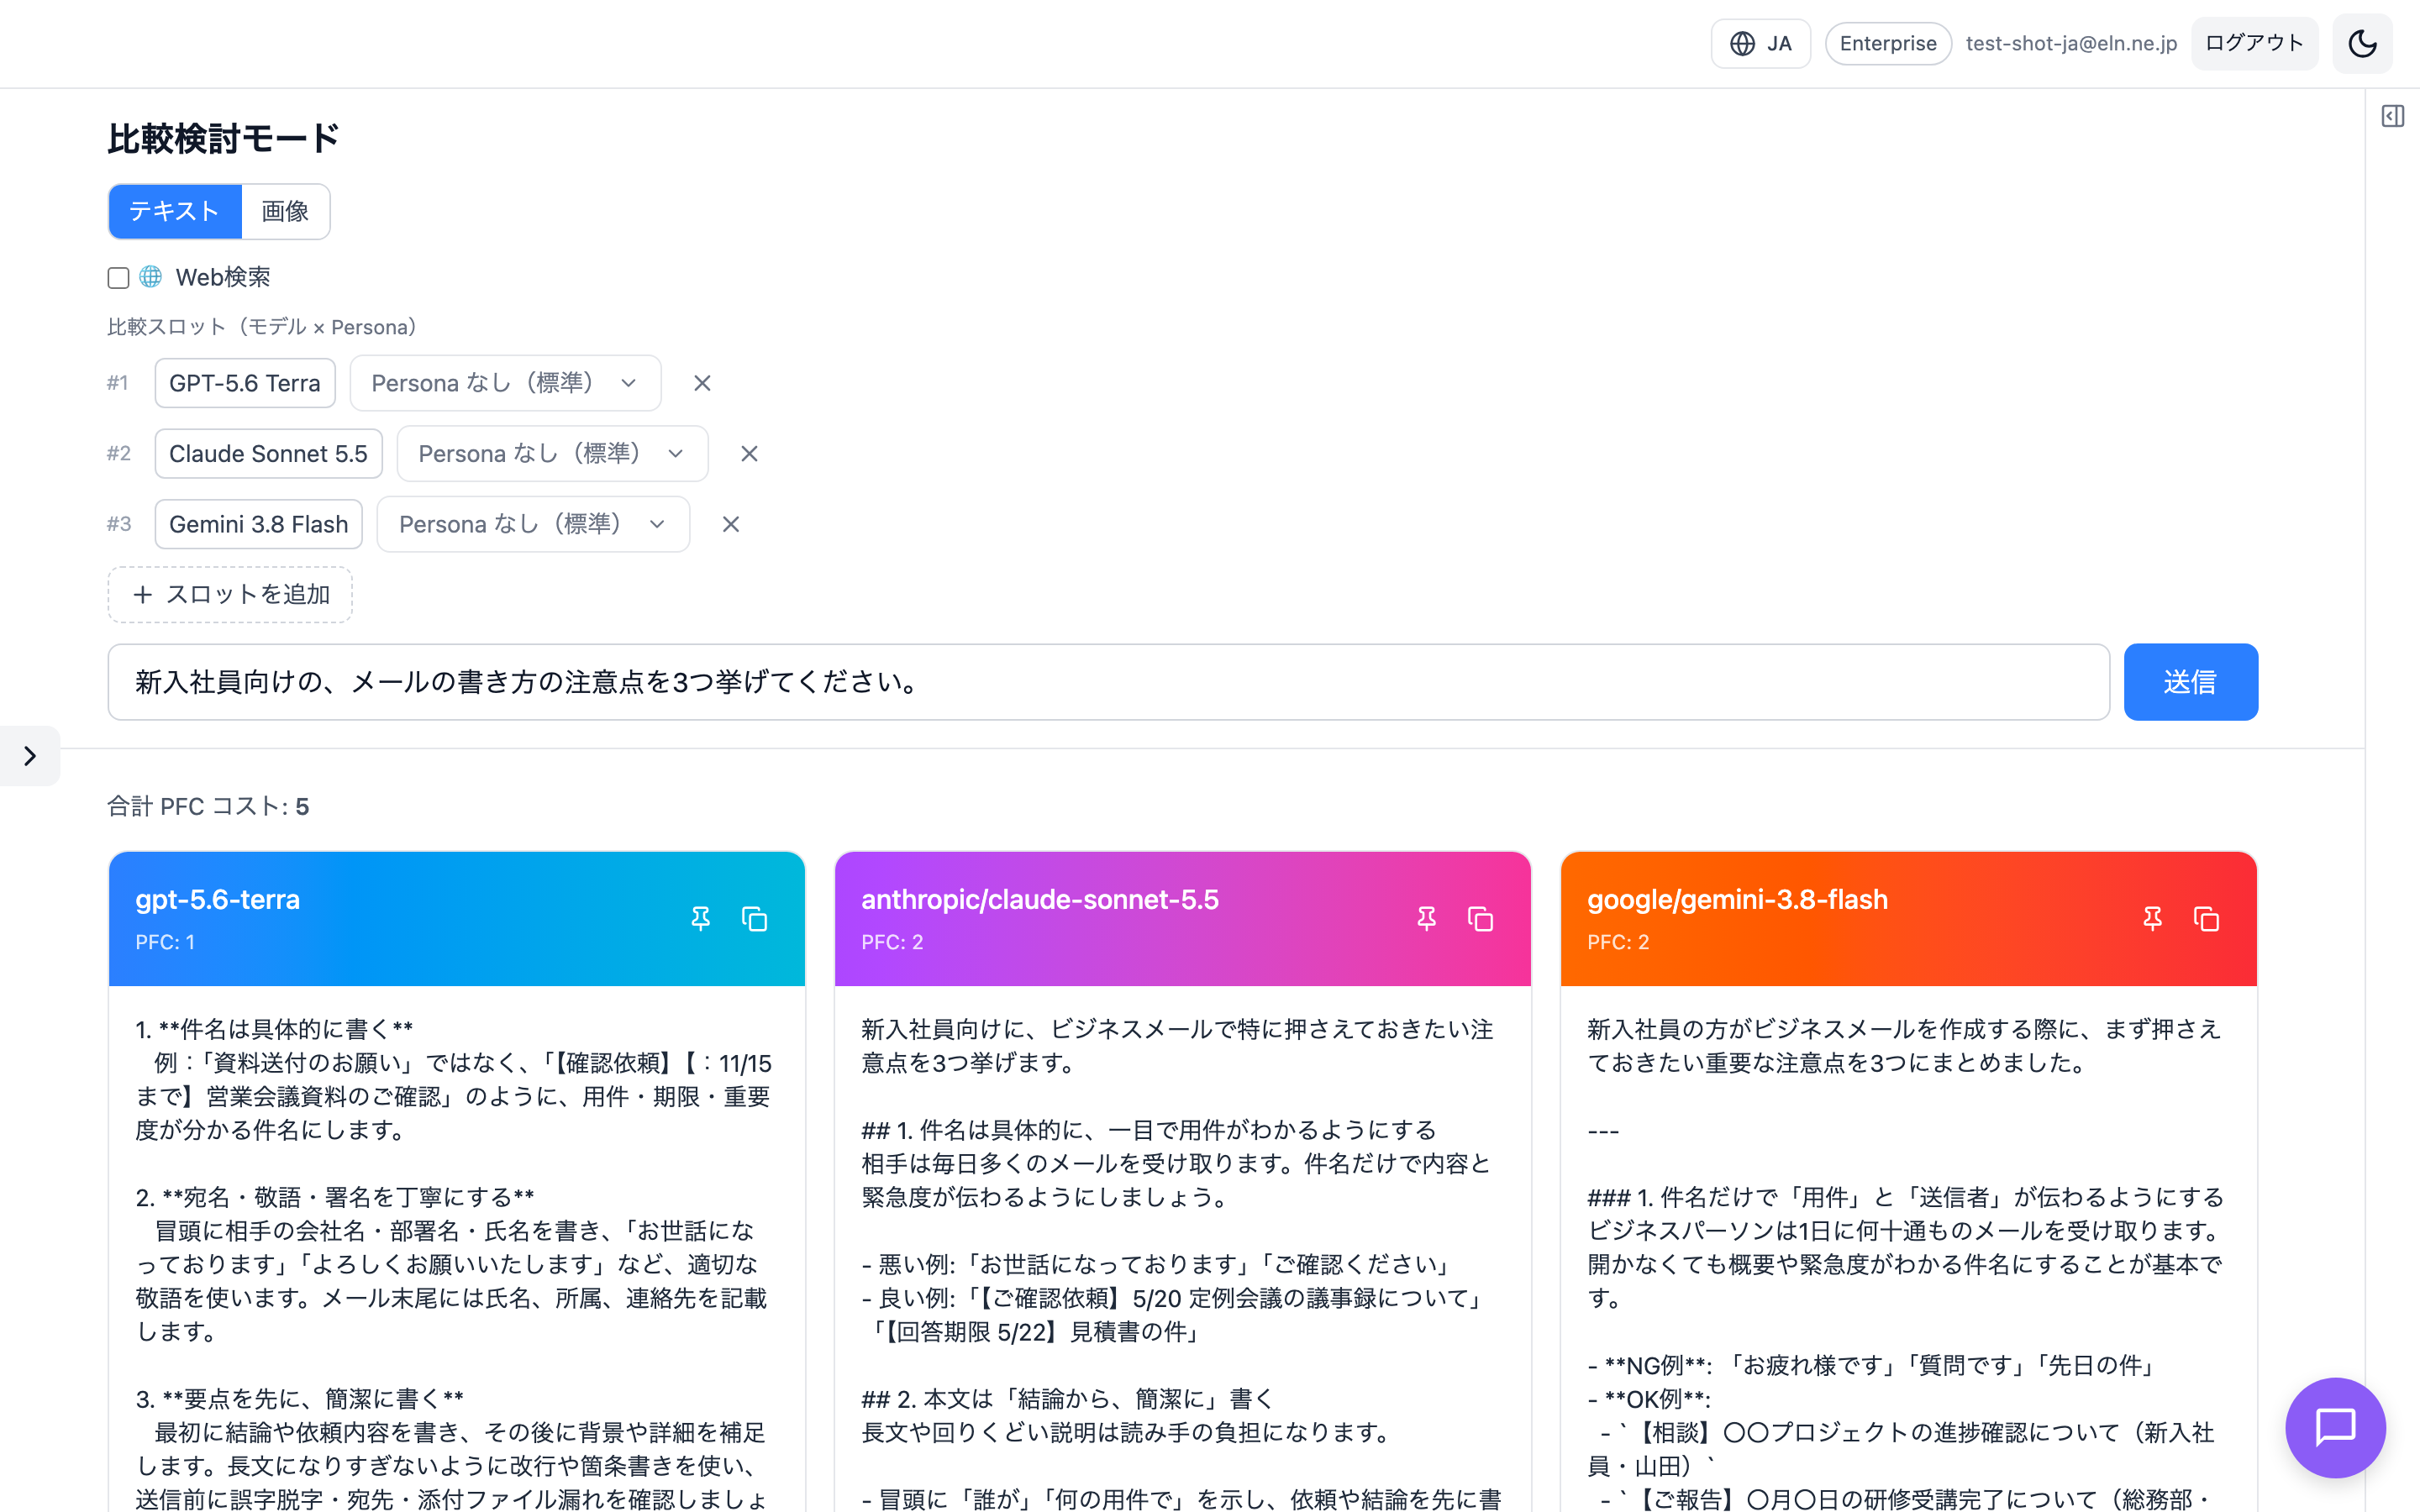
3 つとも、最初に件名の書き方を挙げています。そこから先は分かれます。GPT-5.6 Terra は、2 つ目に宛名・敬語・署名、3 つ目に要点を先に書くことを挙げました。Claude Sonnet 5.5 は、2 つ目に「結論から、簡潔に」を置いています。結論を先に書くという点は、順番は違っても 2 つのモデルが挙げています。
例の出し方も違います。Claude Sonnet 5.5 は「悪い例」と「良い例」、Gemini 3.8 Flash は「NG例」と「OK例」を並べました。GPT-5.6 Terra は「〜ではなく、〜のように」と 1 文で示しています。新入社員向けの資料に使うなら、どの書き方が読み手に合うかも、並べると選びやすくなります。
並べると、全部が挙げた点、意見が割れた点、1 つのモデルだけが挙げた点がすぐ分かります。各列の上には「ピン留め」と「コピー」のボタンがあり、使いたい答えを残したり、そのまま貼り付けたりできます。
費用も列ごとに出ます。この例では、送信前の「推定コスト合計」は 8 PFC でした。答えが返った後の値は列ごとに 1・2・2 で、「合計 PFC コスト」は 5 です。推定は送る前の見積もりで、引かれるのは使った分です。
答えの下には「次のアクション」が並びます。「{モデル名} で Chat 継続」を押すと、気に入った答えのモデルと、そのまま会話を続けられます。
答えを AI 同士でレビューさせる
答えの下の「AI同士のクロスレビュー実行」を押すと、並べた答えを AI 同士でレビューさせられます。レビューするのは、答えを返したモデル自身です。各 AI が、他の AI の答えを読んで、足りない点や誤りを指摘します。答えを返したモデルが 2 つ以上ある時に押せます。
実行中は「クロスレビューを実行中...」と出て、「レビュー対象 {件数} 件」と「経過時間」が表示されます。答えが長いと時間がかかるので、進んでいることが画面で分かるようにしています。
終わると「クロスレビュー結果」に、モデルごとのレビューが「完了」か「失敗」かと一緒に並びます。何モデルが終わったか(例「3/3 モデル完了」)と、レビューに使った「合計 PFC コスト」も出ます。失敗した時は「もう一度実行」で、同じ答えと同じモデルのまま、やり直せます。
レビューの結果からも、「{モデル名} で続ける」で会話を続けたり、「Artifact 保存」で文書として残したりできます。自分で 3 つの答えを読み比べる前に、AI 同士に弱い点を挙げさせておくと、読む時にどこを見ればよいかが分かります。
選べるモデル
スロットのモデル名を押すと、「モデルを選ぶ」の画面が開きます。上に「モデル名・開発元で探す」の欄と「並び替え」があり、その下に「⭐ お気に入り」「おすすめ」「開発元から選ぶ」の順でモデルのカードが並びます。カードの ☆ を押すとお気に入りに入り、次からはこの一覧の一番上に出ます。「並び替え」は「おすすめ順」「料金の安い順」「料金の高い順」「名前順」から選べます。
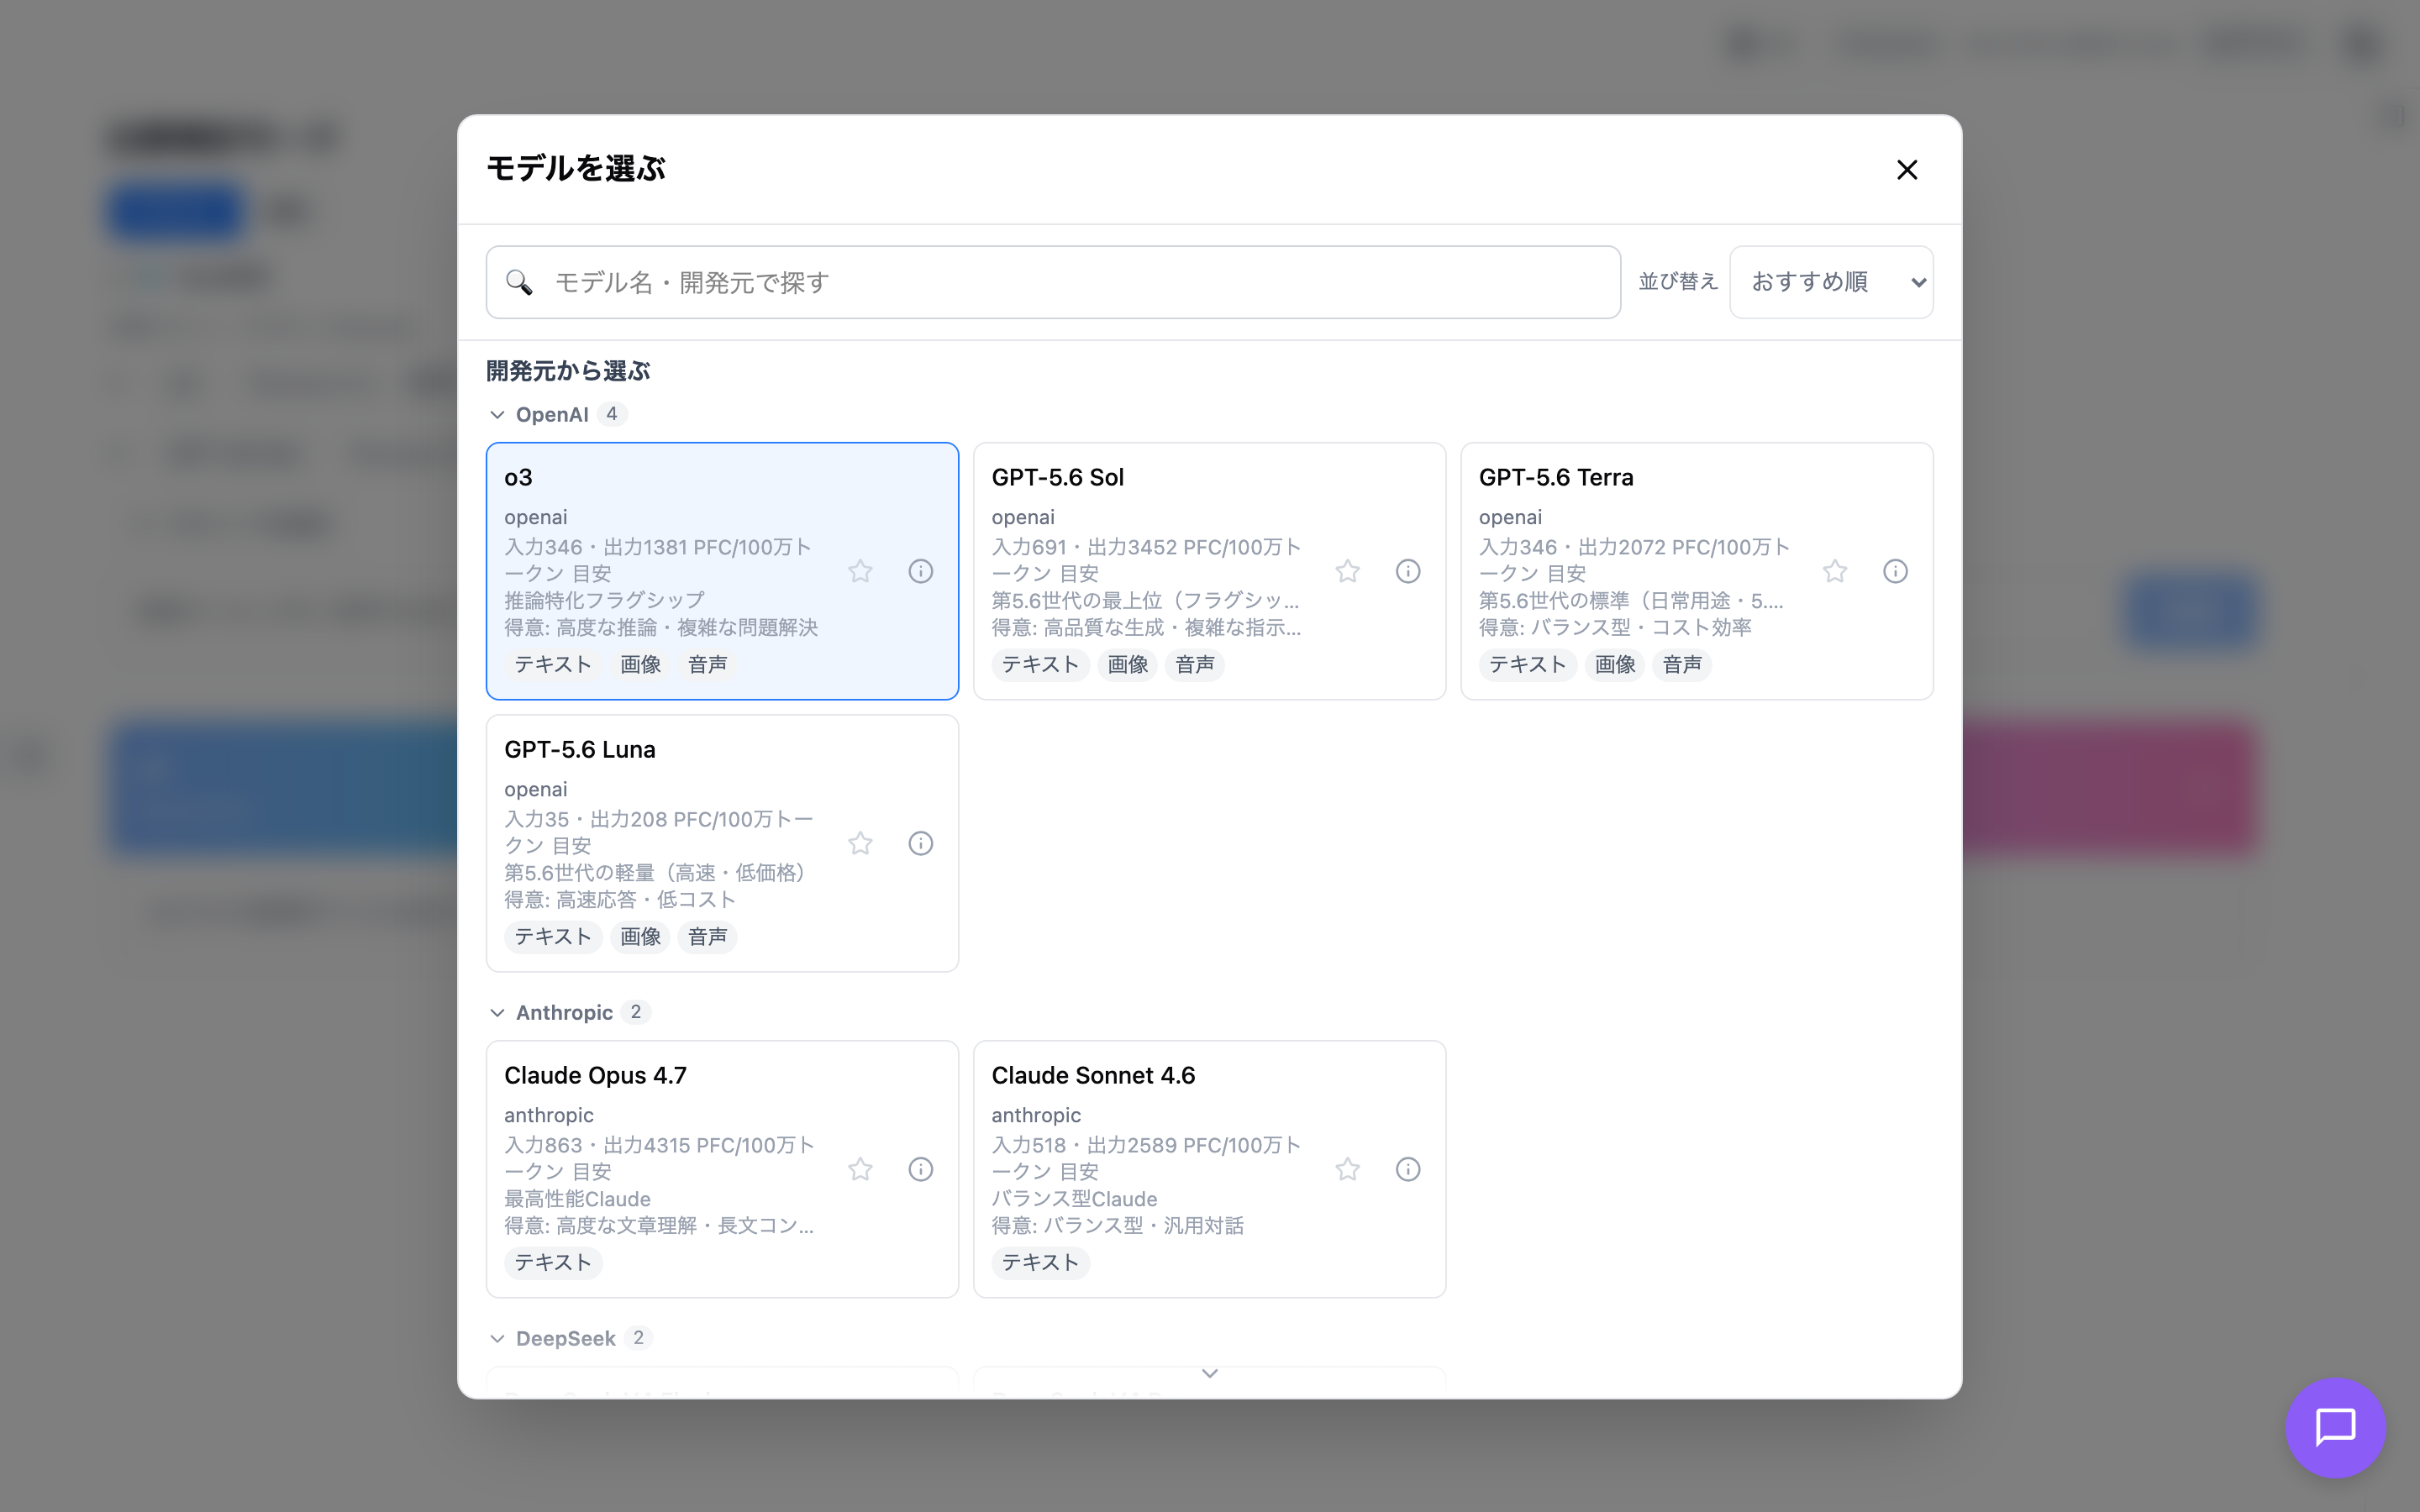
最初の一覧の件数の行は「15 件・9 の見出し(開発元)・おすすめ順」です。この件数は「開発元から選ぶ」の欄の数で、「おすすめ」の欄のモデルは入っていません。「開発元から選ぶ」の 15 件は次の通りです。
| 開発元 | モデル |
|---|---|
| OpenAI | o3、GPT-5.6 Sol、GPT-5.6 Terra、GPT-5.6 Luna |
| Anthropic | Claude Opus 4.7、Claude Sonnet 4.6 |
| DeepSeek | DeepSeek V4 Flash、DeepSeek V4 Pro |
| Google Gemini | Gemini 2.5 Flash、Gemini 2.5 Pro |
| Meta | Llama 4 Maverick |
| MiniMax (Hailuo) | MiniMax M3 |
| Moonshot AI | Kimi K3 |
| xAI (Grok) | Grok 4.6 |
| Zhipu (Z.ai) | GLM 5.3 |
「おすすめ」の欄には、各開発元の主なシリーズの新しいモデルが出ます。上の例で使った Claude Sonnet 5.5 と Gemini 3.8 Flash も、ここから選びました。ほかに GPT-6.1 Sol、Claude Opus 5.5、Gemini 4 Argon、Grok 4.7、Qwen3.8 Max (0902)、Mistral Medium 3.5、Command A などがあります。
全部から探したい時は、「▸ すべてのモデルから絞り込む(上級者向け)」を開き、「主要モデル」を「すべて」にします。件数の行は「303 件・50 の見出し(開発元)」に変わります。モデルは追加や入れ替えがあるので、件数は画面の表示を見てください。
各カードには、入力と出力の PFC の目安(100 万トークンあたり)、説明、得意なこと、扱える入力(テキスト・画像・音声)が出ます。
この目安は、モデルによって大きく違います。画面の表示では、GPT-5.6 Luna が入力 35・出力 208、o3 が入力 346・出力 1381、Claude Opus 4.7 が入力 863・出力 4315、GPT-6.1 Sol が入力 4391・出力 16465 です。出力の目安で比べると、GPT-5.6 Luna と GPT-6.1 Sol では約 80 倍の差があります。高いモデルだけを並べると、1 回の比較の費用も大きくなります。まず安いモデルを含めて比べ、差が出た問いだけ高いモデルを足す、という使い方もできます。
選べるモデルはプランで変わります。料金ページでは、Free プランでも Compare は使えますが、選べるのは軽量モデルだけと案内しています。すべてのモデルを選べるのは Personal Pro 以上です。この記事の画面は、すべてのモデルを選べるアカウントで撮っています。
画像を比べる
上の「画像」に切り替えると、モデルの一覧が画像を作るモデルだけになります。「モデルごとの生成枚数」で、1 つのモデルに何枚ずつ作らせるかを 1〜4 枚から選べます。
次の画面は、「朝の光の中の公園と高層ビルのコンセプトアート」という同じ題材で、3 つのモデルに 2 枚ずつ作らせた結果です。
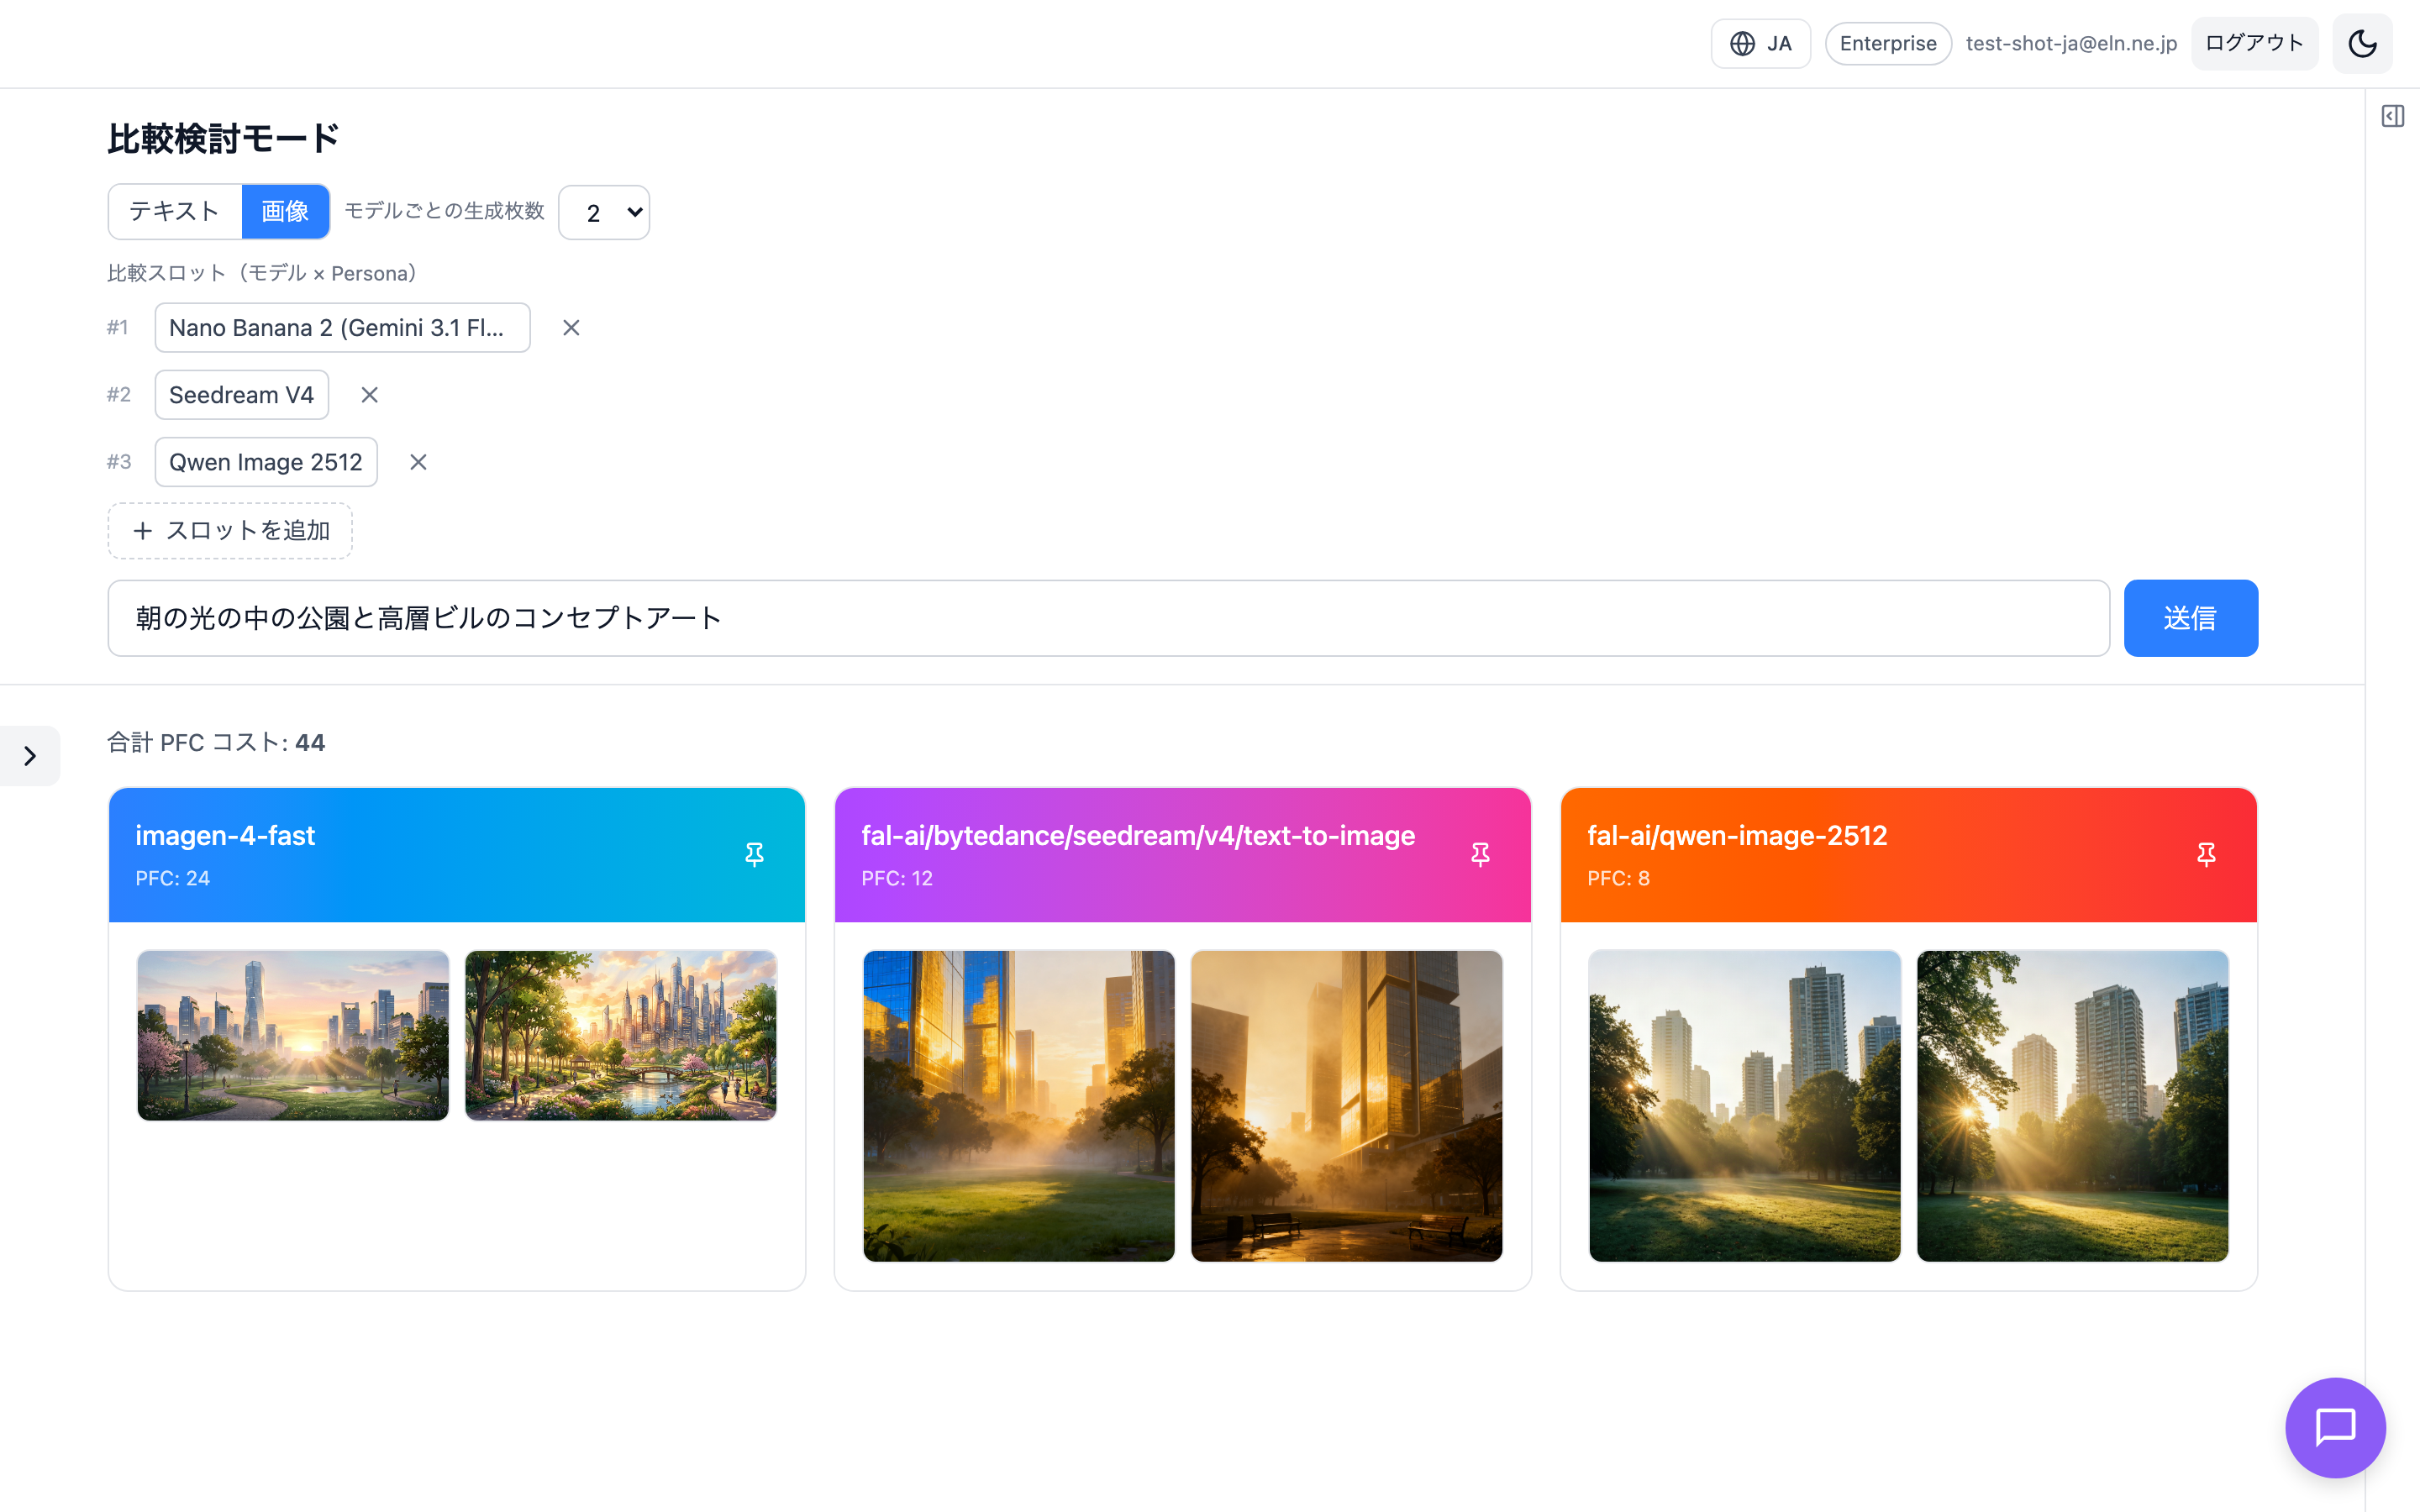
モデルは Nano Banana 2 (Gemini 3.1 Flash Image)(Google)、Seedream V4(ByteDance)、Qwen Image 2512(Alibaba)です。列の見出しにはモデルの識別名が出ます。Nano Banana 2 の列の「imagen-4-fast」は、promptflow の中での識別名です。
同じ題材でも、絵はモデルごとにはっきり違います。
- Nano Banana 2: 横長の絵です。手前の公園と奥の高層ビル群を広く入れ、色の多いイラストの調子で描きました。2 枚目には花と池のある公園が入っています。
- Seedream V4: 縦長の絵です。ガラスの高層ビルを近くから描き、朝日の金色の光と霧を強く出しています。
- Qwen Image 2512: 縦長で、写真に近い調子です。木の間から光の筋が差し込み、高層ビルは奥に立っています。
絵の縦横の比率もモデルによって違うので、使う場所(横長の見出しの画像か、縦長の投稿か)が決まっているなら、それも比べる材料になります。うまく作れなかったモデルがあっても、失敗はその列にだけ出て、ほかの列の画像は残ります。
費用も違い、この例では 2 枚で 24・12・8 PFC、合計 44 PFC でした。送る前の「推定コスト合計」は、モデルごとの 1 枚の単価に枚数を掛けた値です。作れなかった枚数の分は引かれません。
画像用の最初の一覧も、「おすすめ」の欄と「開発元から選ぶ」の欄に分かれます。件数の行は「9 件・7 の見出し(開発元)」で、「開発元から選ぶ」の 9 件は次の通りです。
| 開発元 | モデル |
|---|---|
| Black Forest Labs | FLUX Schnell、FLUX Dev |
| Google Gemini | Nano Banana 2 (Gemini 3.1 Flash Image)、Nano Banana Pro (Gemini 3 Pro Image) |
| Alibaba (Wan) | Wan 2.5 Image |
| ByteDance | Seedream V4 |
| OpenAI | GPT Image 2 |
| Alibaba (Qwen) | Qwen Image 2512 |
| Recraft | Recraft V3 |
上級者向けの絞り込みで「すべて」にすると、「147 件・34 の見出し(開発元)」になります。「おすすめ」の欄には Recraft V4 Pro、Ideogram V2、FLUX 2 Flex、Krea 2 Large なども出ます。
比べた答えの読み方
並べた答えは、全部が挙げた点、割れた点、1 つのモデルだけが挙げた点に分けて読みます。調べる場所が絞れるからです。
ただし、3 つのモデルが同じことを書いても、正しいとは限りません。同じ資料に頼って、同じ誤りを返すこともあります。全部が挙げた点も、元の資料で確かめてから使います。
答えが割れた点は、Compare の中で掘り下げられます。「AI同士のクロスレビュー実行」で、それぞれの答えの弱い点を挙げさせます。理由を詳しく聞きたいモデルがあれば、「{モデル名} で Chat 継続」で、そのモデルに前提や根拠を聞きます。割れた理由が、問いの書き方のあいまいさにあると分かることもあります。その時は問いを直して、もう一度同じスロットで送ります。
比べる時は、問いだけでなく、前提や条件もそろえます。条件が違う答えを並べると、モデルの違いなのか、入力の違いなのかが分からなくなります。Compare は 1 回の入力を全部のスロットへ送るので、問いの条件はそろいます。
画像は、同じ題材で枚数もそろえて比べます。使う場面に合う絵を出すモデルと、その 1 枚の費用を並べて見られます。
結論
- Compare は、同じ問いを複数の AI モデルへ同時に送り、文章や画像を横に並べて比べるモードです。
- 文章は 303 件、画像は 147 件のモデルから選べます。最初の一覧には「おすすめ」の欄と「開発元から選ぶ」の欄が出ます。
- 列ごとに使った PFC が出るので、答えの中身と費用を同じ画面で見比べられます。
- 一致は正しさの証明ではありません。並べた答えは、調べる場所を絞るために使います。
用語
- PFC: promptflow で利用量を表すクレジット。提供元ごとに違う費用を、共通の単位にそろえます。
- スロット: Compare で、比べたい AI の候補を 1 つずつ入れる行。モデルと Persona を選びます。
- Persona: AI に役割や視点を持たせる設定。同じモデルでも、Persona を変えると答えの観点が変わります。
- クロスレビュー: 並べた答えを、各 AI が他の AI の答えとしてレビューする操作。
- Artifact: promptflow で、答えを文書として保存したもの。保存したものは「成果物」の一覧に並び、会話の外でも見返したり、ダウンロードしたりできます。
このシリーズでは、旗艦SaaSの Prompt Flow Studio ほか、AI開発・運用の現場で得た知見を順次公開していきます。 興味のある方は、ぜひ「いいね」と記事の購読をお願いいたします。
Prompt Flow Studio は、複数のAIを1画面で使い、比べ、議論させるマルチAIワークスペースです。詳しくは https://prompt-flow.studio をご覧ください。 そのほかの自社プロダクトは https://www.eln.ne.jp/products にまとめています。
筆者について
上原正吉。EarthLink Network Co., Ltd. 代表。AI社員に日々の業務を任せ、開発では人が逐一指示しなくても作業が進むHOOTL(Human Out Of The Loop)の仕組みを自社で実践しています。このブログでは、業務自動化と24時間自動開発のノウハウ、具体的な設定方法、日々の運用で見つかった問題と改善を共有します。
また、AIで業務や開発を組み替えたい会社・チーム向けに、AI活用のコンサルティングも受け付けています。ご相談は www.eln.ne.jp からどうぞ。
EarthLink Network は、会社の全業務を AI で回すために、必要になったものを自社で作っています。いま作っているプロダクトの一覧と概要は、こちらにまとめています。
→ EarthLink Network が自社でつくっている18のプロダクト
会社と各プロダクトの詳細は、公式サイト www.eln.ne.jp をご覧ください。