Claude CodeとCodexを同じ成果物で相互レビューさせる
上原正吉(EarthLink Network Co., Ltd.)。Claude Codeを開発の主体に据え、20を超えるプロダクトを1人で同時に開発・運用しています。これは、その現場の実測記です。
Claude CodeとCodexを同じ成果物で相互レビューさせる
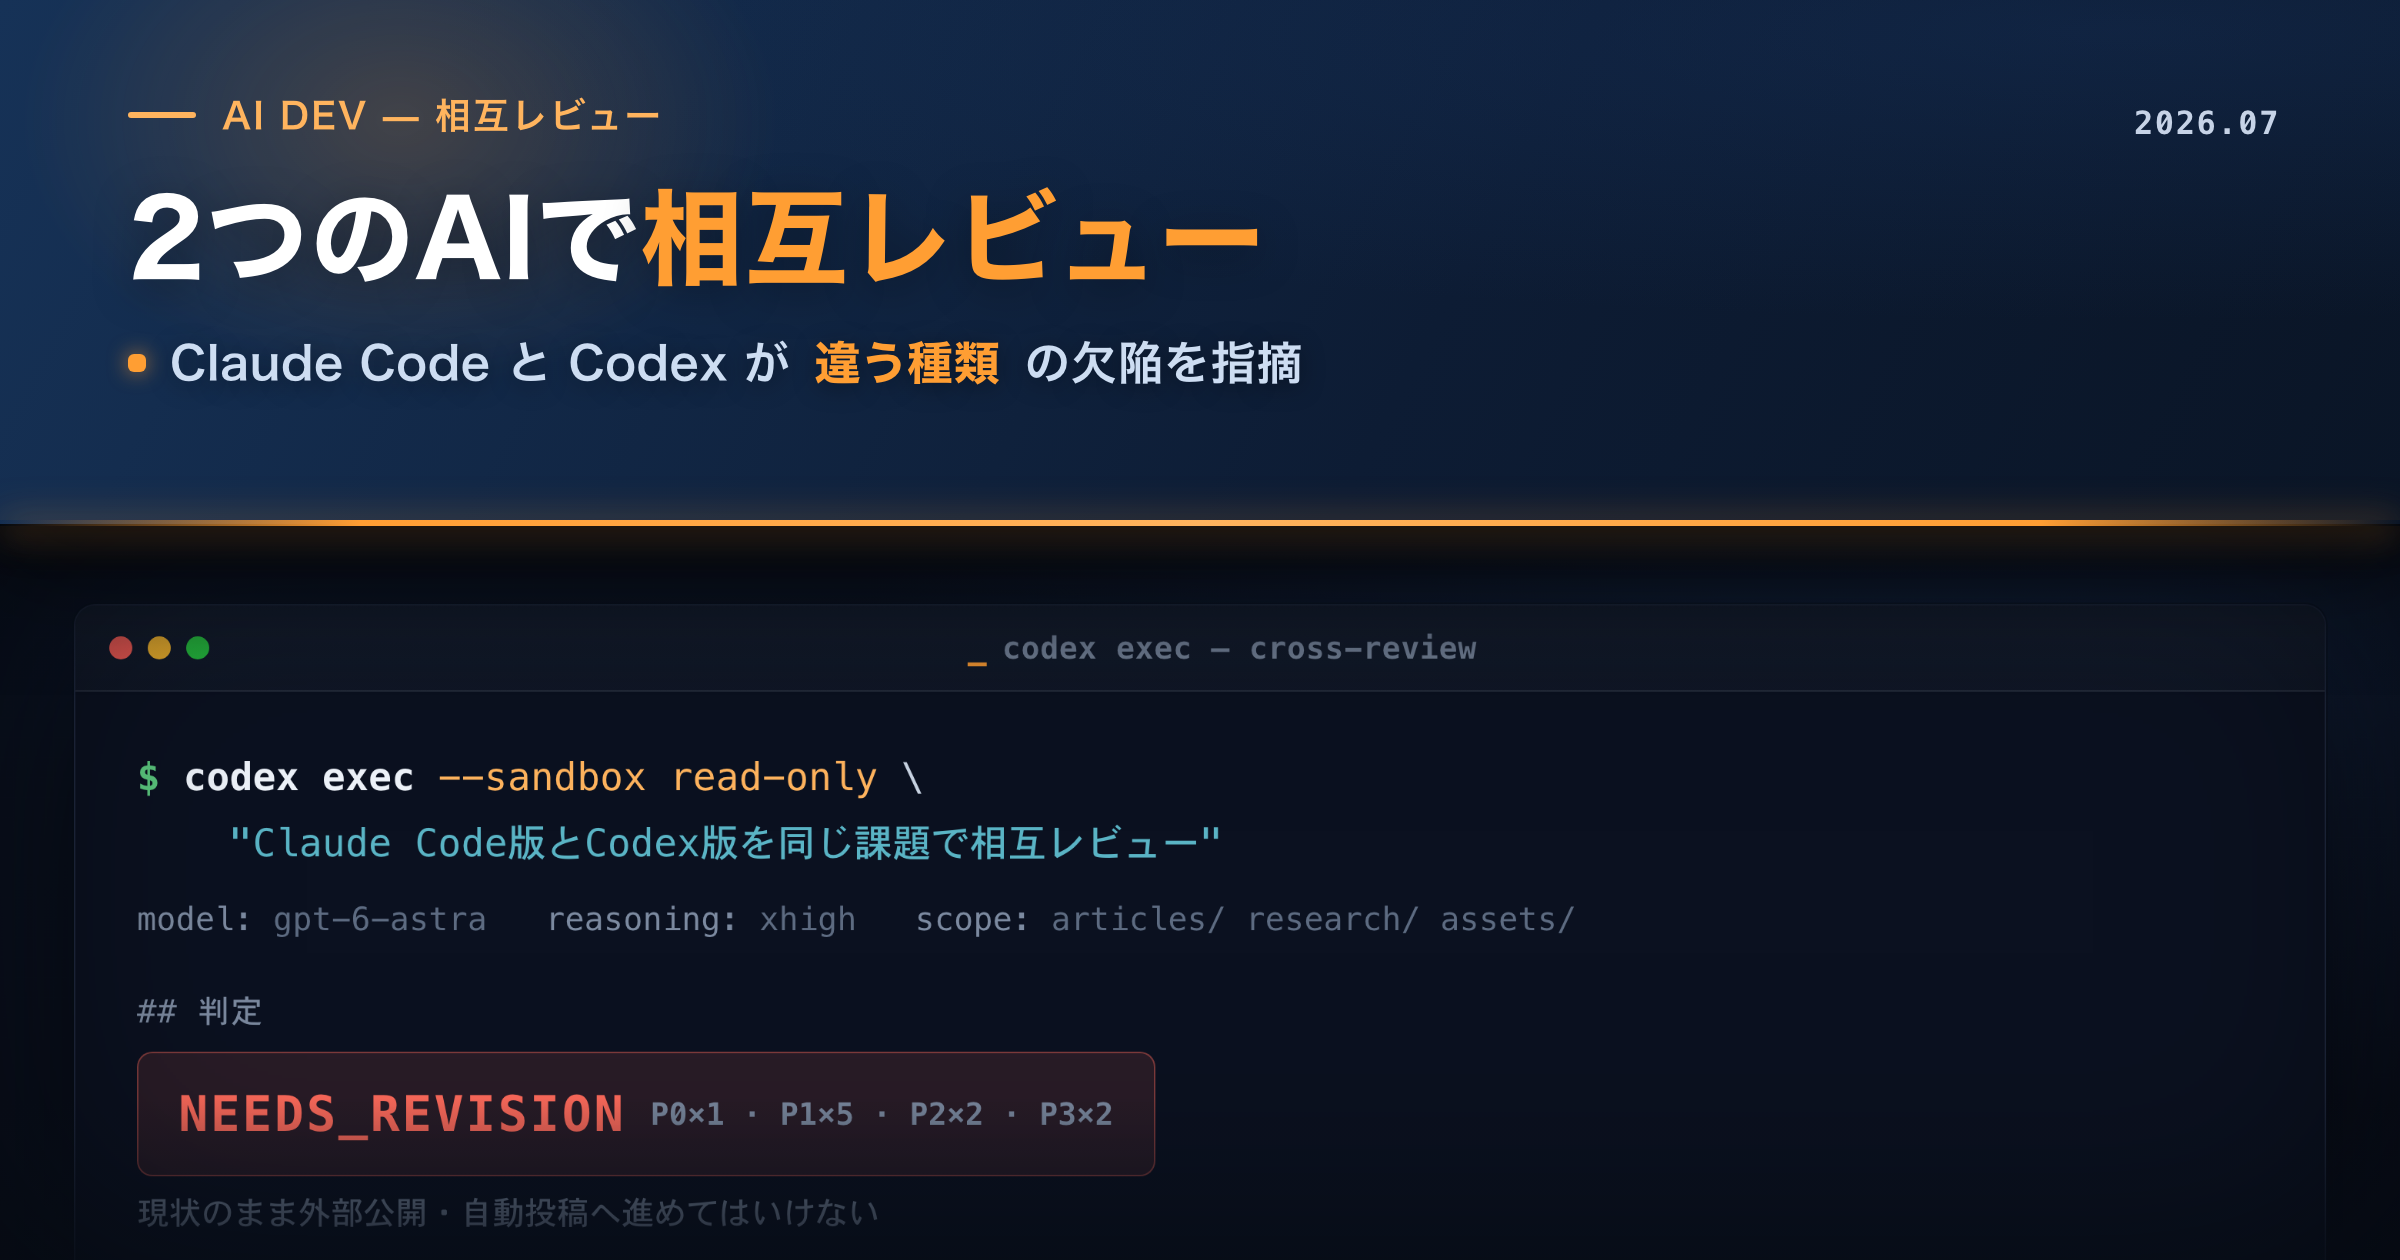
結論
- 同じ課題を Claude Code と Codex に別々に作らせ、互いにレビューさせました。 目次案・一次資料の整理・サンプル記事という同じ成果物を、2つのAIに独立で作らせます。そのうえで、事実誤り・追加証拠・機密・文章・媒体適合の5分類で相互にレビューさせました。最後に公開してよいかは人間が決めます。
- 2つのAIは、違う種類の欠陥を見つけました。 Codexは「$15.76は実請求と断定できない」「一致率100%はAI単体の正しさではない」という、数値の意味の取り違えを指摘しました。Claude Codeは、モデル本体の大きさ「90GB」が実は約47GBだった誤りと、HTMLのコメントに残ったSlackのワークスペース名や絶対パスを見つけました。
- それでも人間のレビューは省けません。 2つのAIが同じ誤りを共有していれば、相互レビューでは捕まりません。公開してよいかという事業の判断も残ります。
本文(読了 約8分)
どちらか一方のAIを信じない
このブログの記事は、Claude CodeとCodexという2つのAIに書かせています。作るときに、最初から置いた前提が1つあります。どちらか一方のAIの成果物を、そのまま信じないことです。
理由は単純です。AIは自分が書いたものを「正しい」「そのまま使える」と、高く見積もりがちです。同じモデルに見直させても、書いたときと同じ考え方で読み直しやすい。同じ見落としが残りかねません。
そこで、生成とレビューを別のモデルに分けることにしました。同じ課題と同じ一次資料を2つのAIに渡し、相手の出力を見ないまま独立に作らせます。そのあと出力を交換して、互いにレビューさせる。人間は最後に、外部へ出してよいかどうかを判断します。この3段構えにしました。
以前、別の記事で「AIに、別のAIを疑わせている」と一行だけ触れたことがあります。今回はその一行の中身です。どう分類し、誰に何を見させ、実際にどんな指摘が出たのか。ここを開きます。
役割と分類を先に決める
対象は同じ成果物です。今回かけたサンプル記事は、クラウドのコスト集計と、GPUで動かすローカルのAIの運用を扱った実録でした。あとで出てくる金額($15.76)やモデルの大きさ(72B・90GB)は、すべてそのサンプル記事の中身です。
好き勝手にレビューさせても、指摘は噛み合いません。そこで制作方針(PLAN.md)に、誰が何を見るかと、指摘をどう分類するかを先に書きました。
# 相互レビューの役割分担(PLAN.md より)
Codex      : 記事構成と読みやすさ / 主張と証拠の対応 / 数値の意味の取り違え / 媒体への派生案
Claude Code: リポジトリの最新状態との整合 / ADR・作業記録・観測の取りこぼし /
             技術説明の誤り / プロジェクト固有の公開リスク
人間        : 外部公開してよい範囲 / 顧客・価格・障害の開示可否 / 有料・無料の切り分け / 最終タイトルと投稿先

# レビュー結果は5種類に分ける
事実誤り / 追加証拠 / 機密 / 文章 / 媒体適合
ADRは、設計上の判断を残す文書です。この5分類が効きました。指摘を「事実が間違っている」「証拠が足りない」「機密が漏れている」「文章が悪い」「媒体に合っていない」に分ける。そうすると、2つのAIの指摘を同じ軸で並べて突き合わせられます。
Codexが見つけたもの(判定はNEEDS_REVISION)
レビューは口頭ではなく、機械で処理できる構造化文書として残しました。文書は、レビュアー名と判定を持ちます。指摘は対応表(ID・重要度・担当・対応・状態)で追跡します。
判定は要修正でした。対応表は10件。Claude Code版に対する主な指摘はこうです。
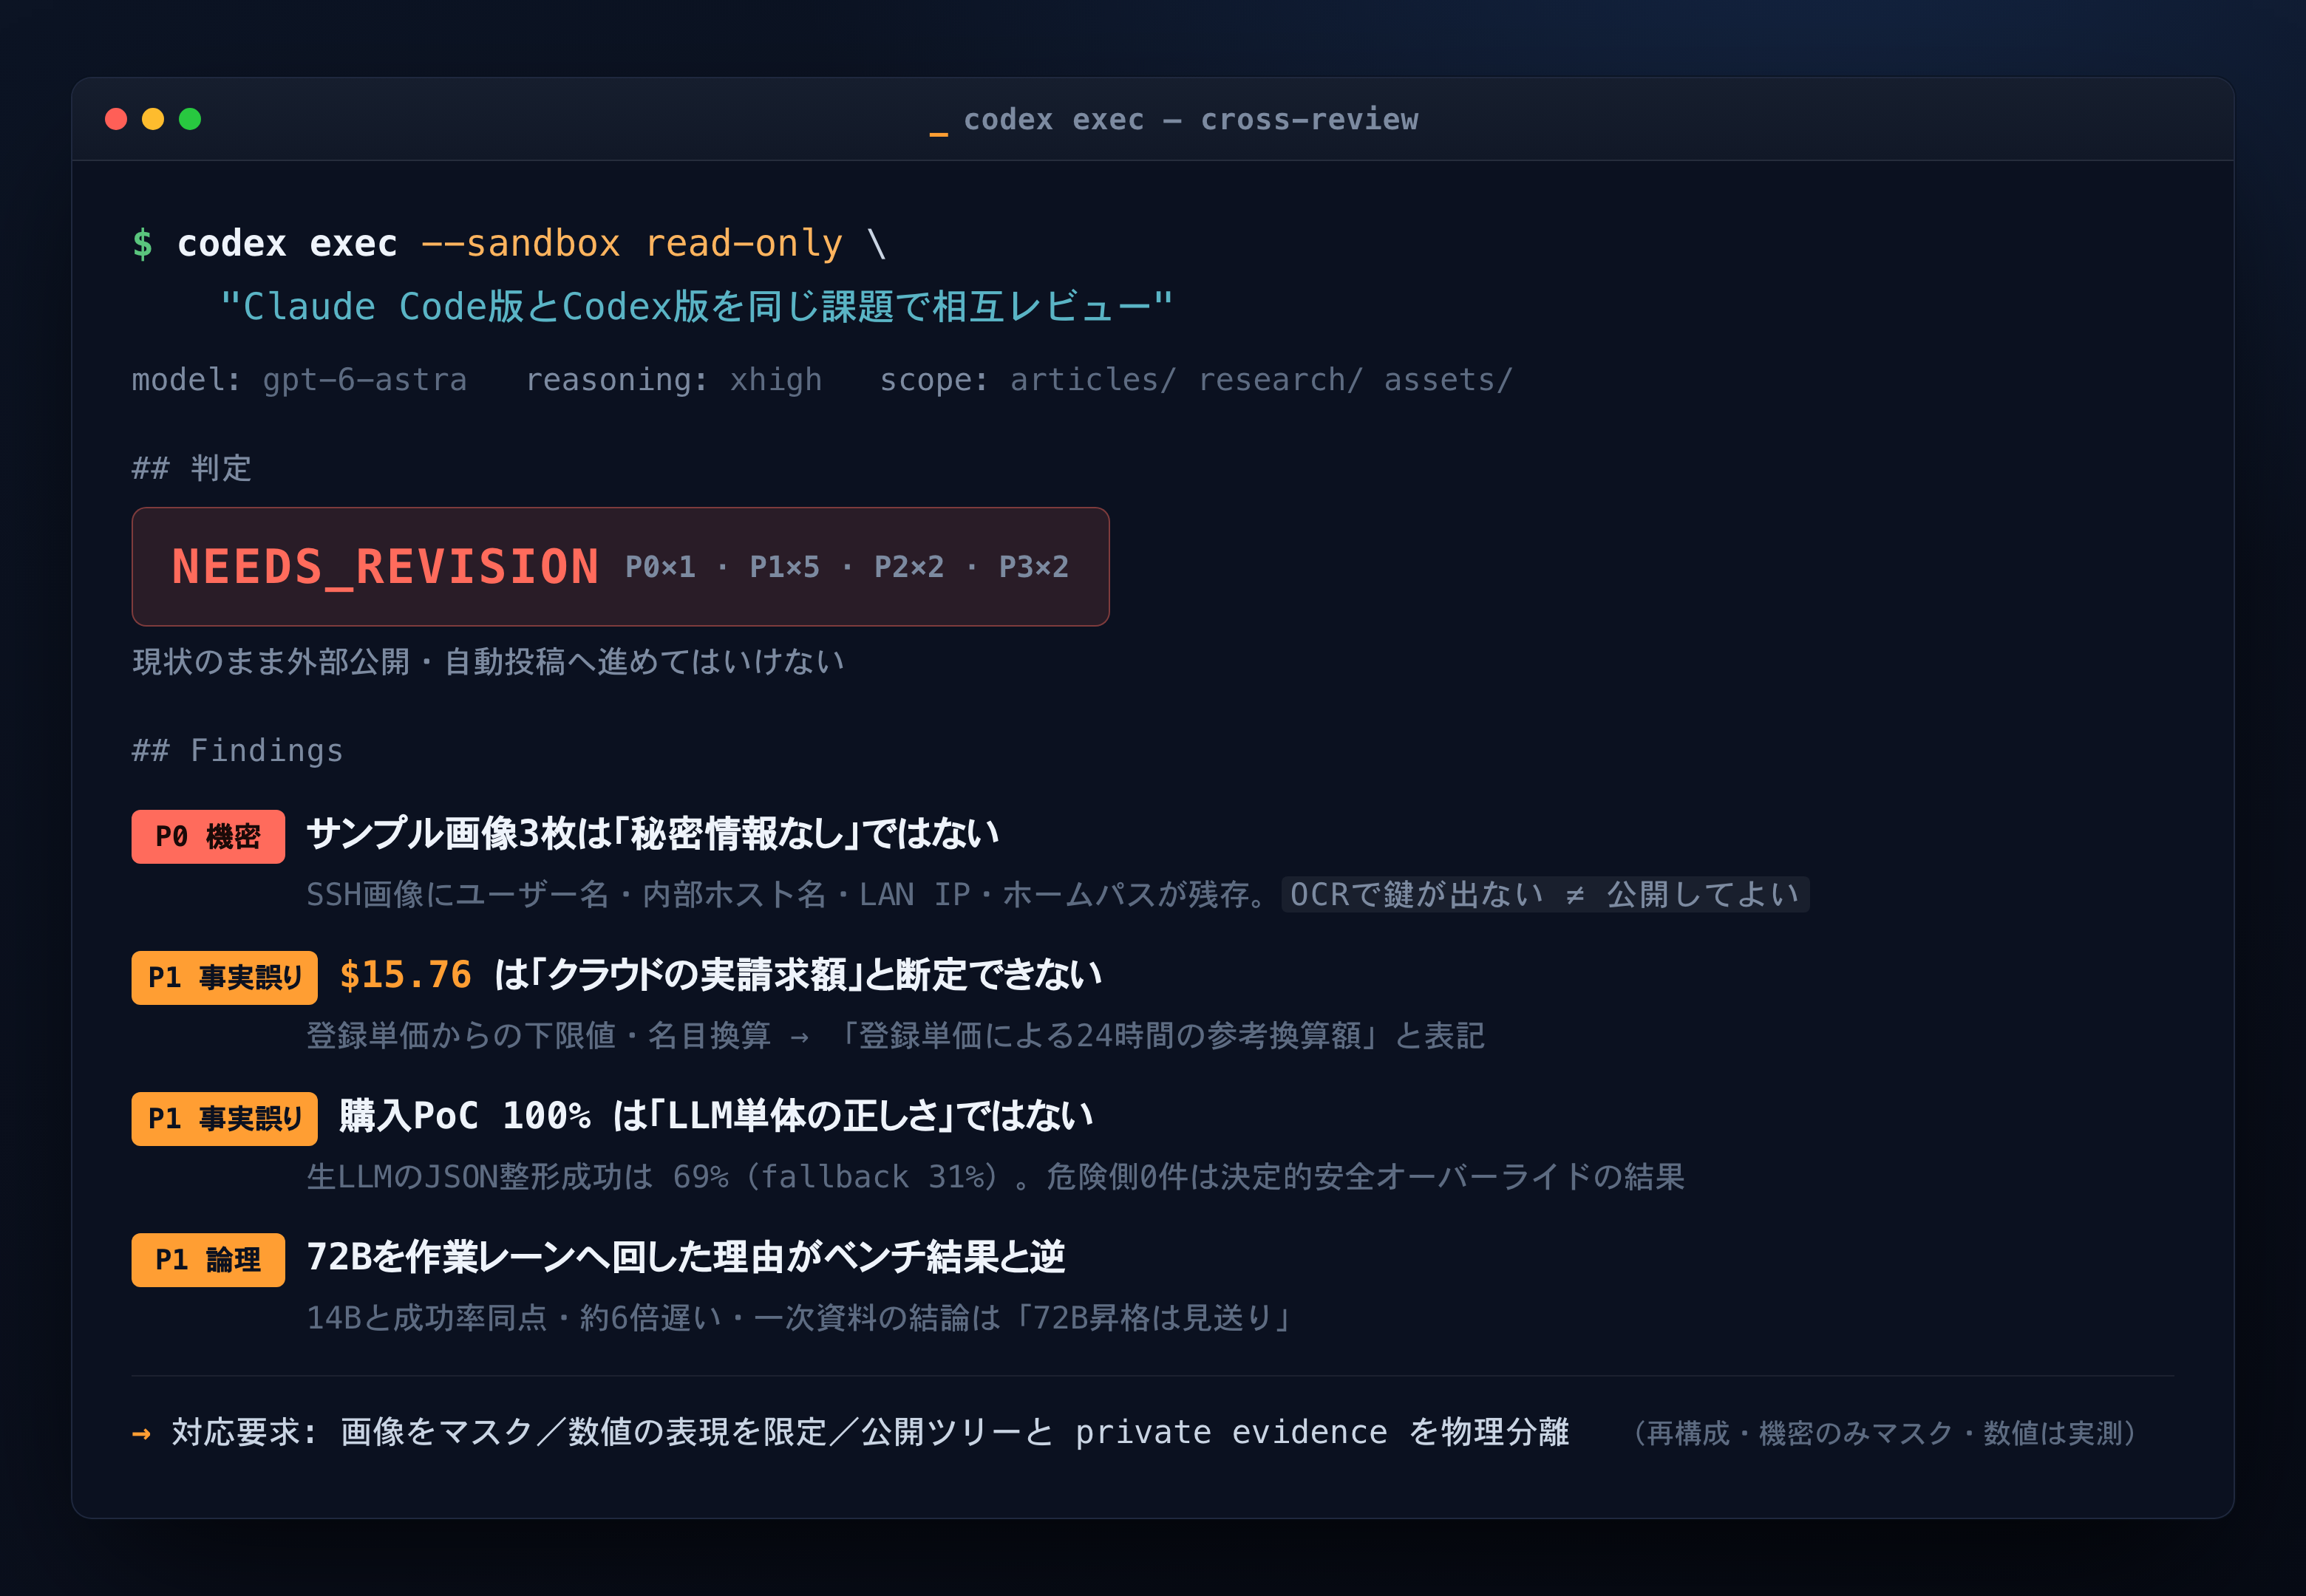
- [P0 機密] サンプル記事の実スクリーンショット3枚に、内部ネットワーク・運用規模・プロジェクト別の稼働状況が写っています。APIキーが画像の文字認識で見つからないことと、公開してよいことは同じではない。そういう指摘です。
- [P1 事実誤り] 記事は「$15.76」を「クラウドの実請求額」と断定していますが、実装は登録した単価からの算出で、単価の分からないモデルが混じると既知分だけの下限値を返します。名目の換算額と、実際の請求は一致しません。
- [P1 事実誤り] 購入判定のPoC(実際に動かして確かめる検証)で一致率100%だったことを「AI単体の正しさ」とまとめています。でも一次資料では、AIが出したJSON(構造化データの形式)の整形成功は69%で、残り31%は失敗して代替処理に落ちていました。危険側の誤りが0件だったのは、壊れた出力を最終段の固定ルールが吸収した結果であって、AIが完璧だったからではありません。
- [P1 論理] 72B(720億パラメータ)のモデルを作業用に回した理由を「品質が優れているから」と書いています。でも生成のベンチマークでは、14Bと72Bの成功率が同点で、72Bは約6倍遅く、結論は「昇格は見送り」でした。本当の採用理由は、既存の資産を無料の低リスク枠として使うためです。
Claude Codeが見つけたもの(32件)
次に、Claude CodeがCodex版をレビューしました。生成した側とレビューする側を入れ替えた、逆方向のレビューです。6つの観点(ベンチ数値・メモリとルーティング・処理量50.3%の実測・目次の網羅性・機密・文章と媒体)を並列に確認し、指摘ごとに一次資料で裏を取るため、計18のエージェントを使いました。指摘は32件。内訳は、事実誤り3件・機密4件・追加証拠10件・文章11件・媒体適合4件です。影響が中から高の12件は、再確認で根拠が取れました。問題なしと確認できた項目は77件です。
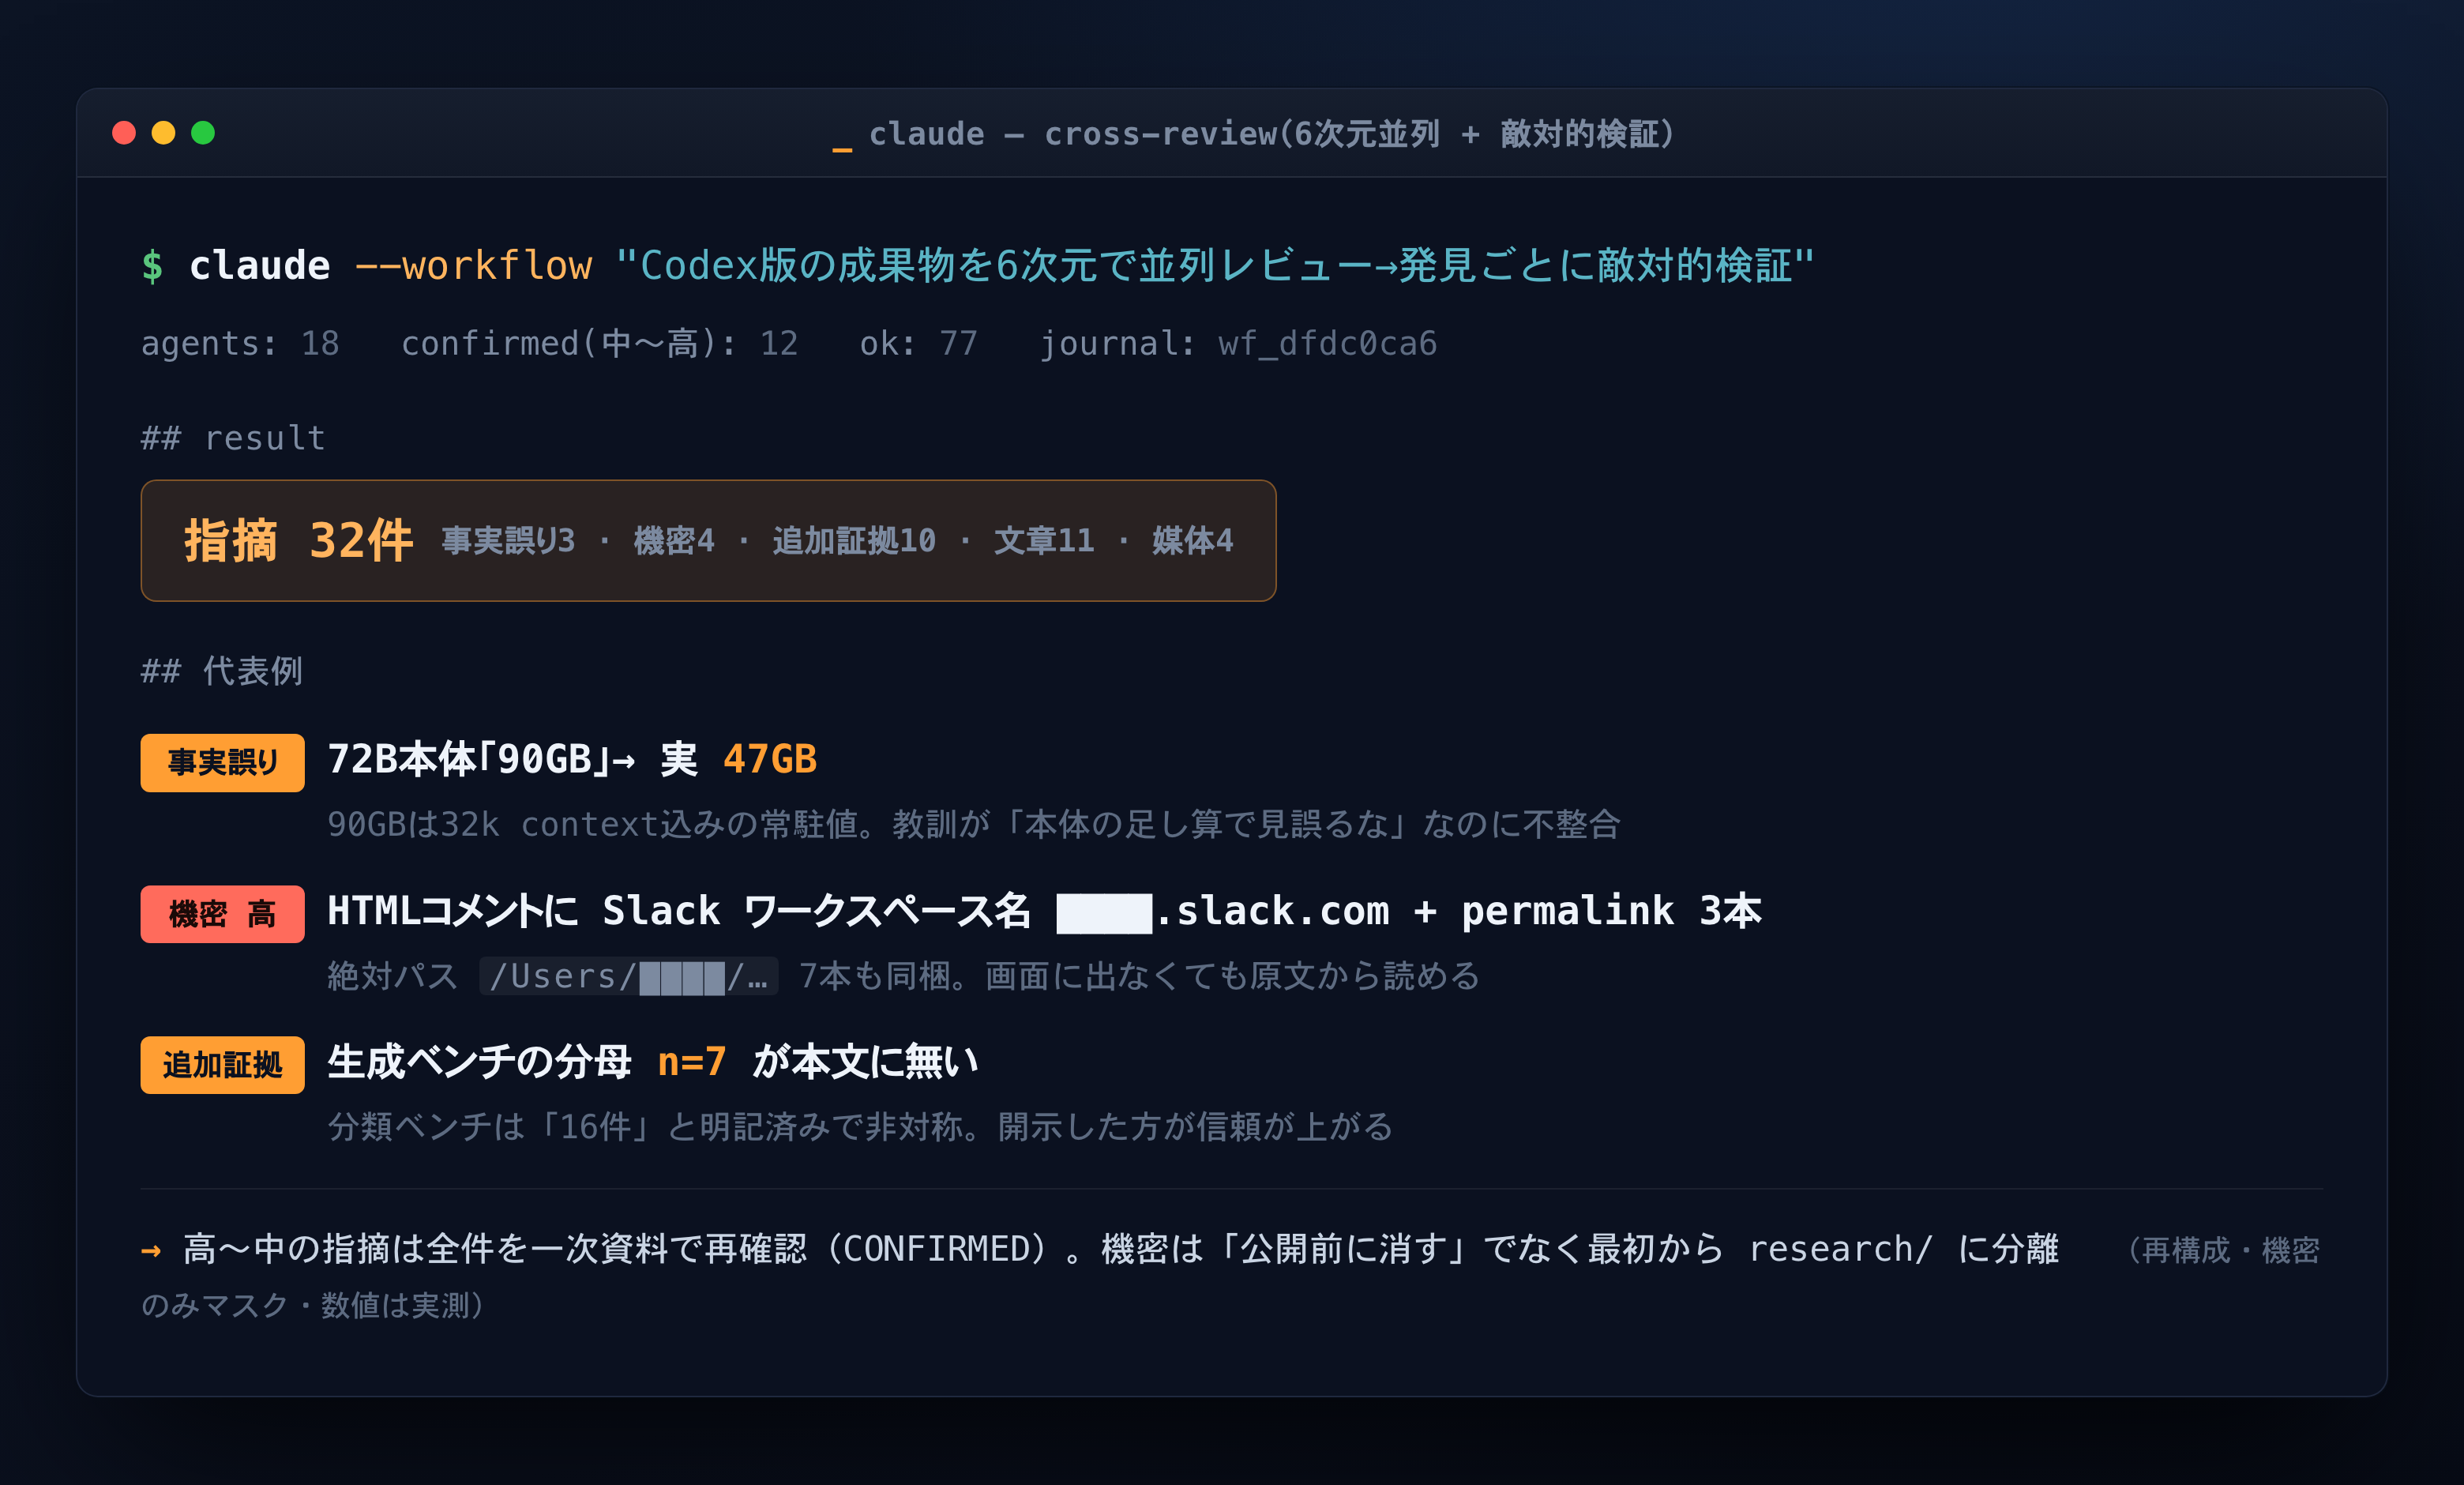
- [事実誤り] 「72Bのモデル本体は約90GB」は誤りです。90GBは、32kトークンの文脈まで載せて常駐させたときの値で、本体は約47GBでした。記事の中でも、本体の欄と文脈込みの欄が同じ90GBになっていて、食い違っています。
- [機密] 本文中のHTMLコメント(Markdownの原文には残りますが、画面には表示されない注記)に、Slackのワークスペース名とチャンネルの固定リンク、ローカルの絶対パスが複数残っていました。画面で見えなくても、公開したGitリポジトリやMarkdownの原文からは読めます。
- [追加証拠] 生成ベンチマークの分母 n=7(サンプル数7)が本文に無い、ローカル50.3%とクラウド48.2%の合計が98.5%で残り1.5%(unknown、分類できなかった分)の説明が無い、観測件数が上位のプロジェクトが目次から抜けている——こうした証拠の取りこぼしを10件挙げました。
- [文章] 高性能なGPUマシン「DGX Spark」が説明なしに初出で、専門でない読者には唐突でした。初出の位置で一言補うべき、という指摘です。
- [媒体適合] 説明が技術者向けのZennに寄っていて、一般読者のnoteへ出すには前提用語の補足が足りない、という指摘です。
同じ観点名でも、2つのAIが見つけたものは違いました。両者とも「機密」を指摘しましたが、Codexは公開画像に写り込んだ内部情報を見つけました。Claude Codeは、HTMLコメントに埋まった絶対パスとSlack名を見つけました。両者とも72Bの扱いを指摘しましたが、Codexは「採用理由がベンチマークと逆」という論理を、Claude Codeは「90GBか47GBか」という数値の誤りを指摘しました。
今回、2つのモデルが指摘した違い
単独のレビューでは、レビュアー自身の見落としが残ります。Claude Code版のサンプル記事は物語性があり、実スクリーンショットも豊富でした。一方で、「実額を審査せず載せる」「観測できた範囲を超えて一般化する」という問題がありました。Codex版は数値の意味と公開リスクを厳密に扱いました。一方で、その後の経過が抜け、証拠をHTMLコメントに埋めて本文と混ぜていました。
2つのモデルが異なる種類の欠陥を指摘した、というのが今回の記録から言える範囲です。
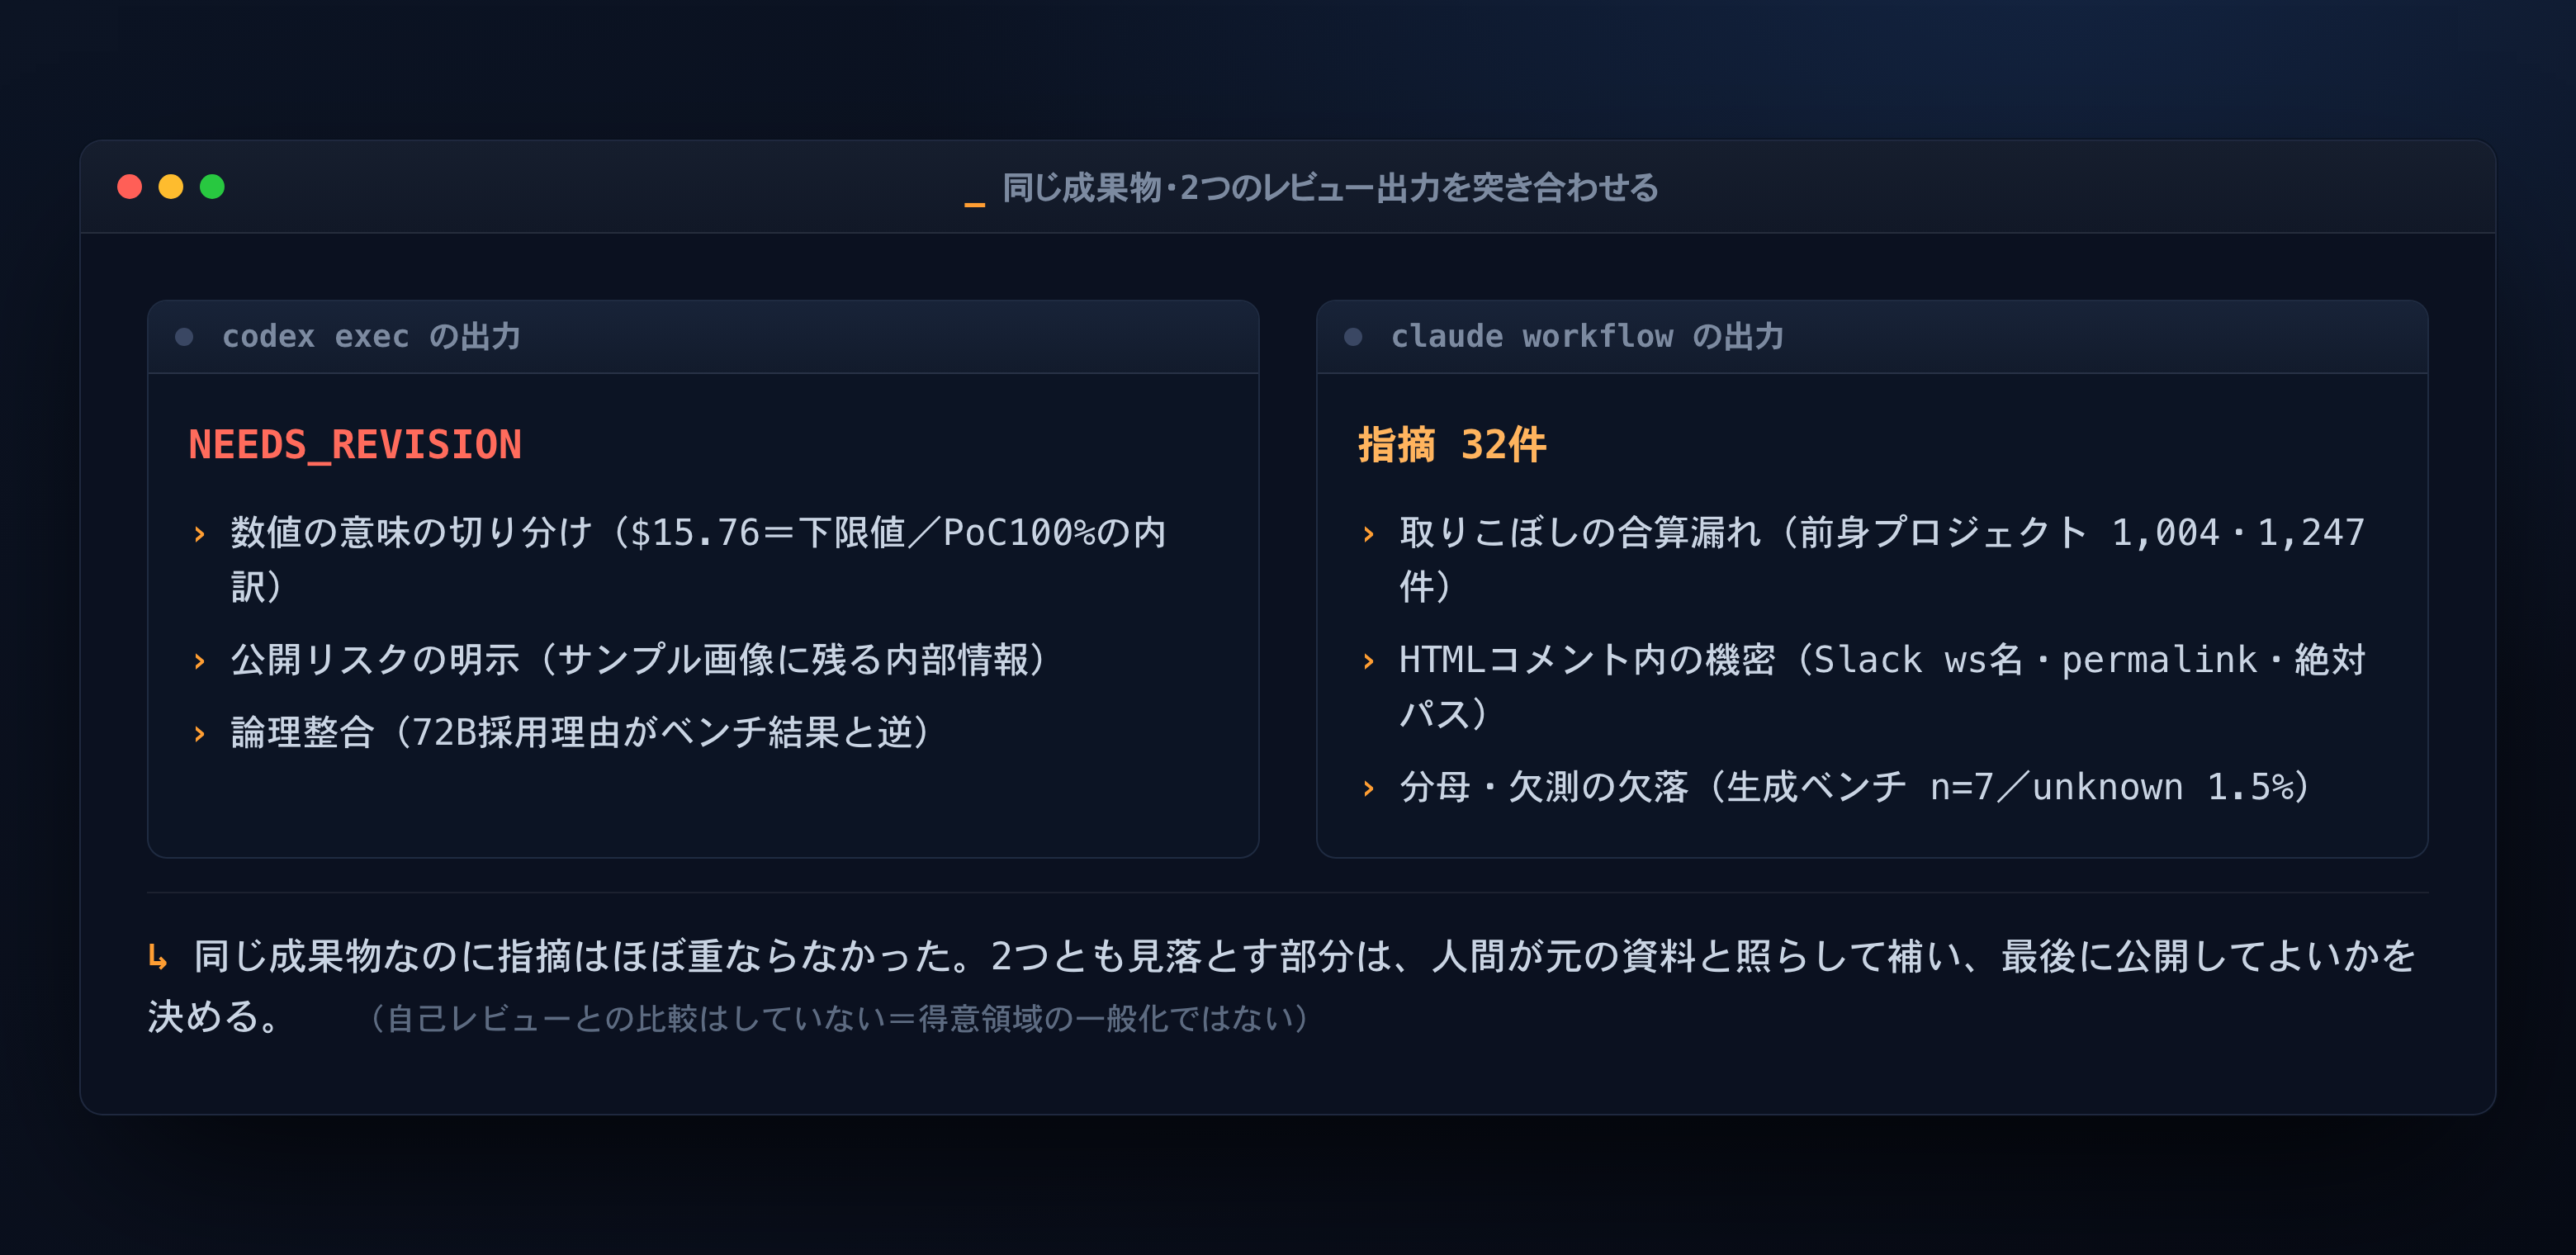
自己レビューとの比較実験はしていないので、違うモデルの方が多く欠陥を見つける、とまでは言えません。ただ今回、Codexが「文字認識で鍵が出てこないことと、公開してよいことは同じではない」と指摘し、生成した側とは別の観点を出したことは確認できます。
相互レビューの限界
限界は三つあります。
第一に、相互レビューは網羅ではありません。Codex側のレビュー自身も、96本の記事候補すべての数値を元の資料まで当たり直したわけではなく、サンプル記事と公開工程を優先した、と範囲の限界を書いています。
第二に、2つのAIが同じ誤りを共有していたら、相互レビューでは捕まりません。だから最後の人間レビュー——重要な主張を元の資料と突き合わせ、外部公開してよい範囲や顧客・価格・障害の開示可否を判断する——を、必須の第3段として残しました。
第三に、記事を仕分けるテーマ体系そのものが両者で食い違いました。これはレビュー結果の5分類(事実誤り・追加証拠・機密・文章・媒体適合)ではなく、記事カタログを何のテーマで束ねるかという別の分類です。両版がこのテーマ分類を別々に組んだため、Codexのレビューは、Claude Code版の英語6分類とCodex版の日本語7分類が一致しないと記録しています。統合には、どちらのテーマ分類に寄せるかを人間が決める必要がありました。
この相互レビューの産物として、いくつかの是正につなげています。指摘は対応表(ID・重要度・担当・状態)に落とし込みます。公開用ディレクトリと、非公開の証拠を物理的に分けます。上位の記事には主張ごとの証拠台帳を作ります。今読んでいるこの記事も、同じ工程を通しています。
この運用から、次の3点が分かりました。
- 生成とレビューには別のモデルも使います。 今回は異なるモデルが異なる種類の欠陥を指摘しました。
- 共通の分類で、各AIの指摘を突き合わせます。 「機密」という同じ観点名でも、今回は一方が公開画像を、もう一方がHTMLコメントの絶対パスを見つけました。5分類のような共通の軸で並べると、その違いが見えます。
- 人間が最後に公開可否を判断します。 2つのAIが共有する誤りと、公開してよいかという事業の判断は、AIのレビューだけでは埋まりません。
筆者について
上原正吉。EarthLink Network Co., Ltd. でAI開発をしています。2025年からClaude Codeを開発の主体に据え、今は20を超えるプロダクトを1人で同時に開発・運用しています。この連載では、その現場で実際に起きたこと(うまくいったことも、失敗も)を、数字と一緒に書いていきます。
また、AIで業務や開発を組み替えたい会社・チーム向けに、AI活用のコンサルティングも受け付けています。ご相談は www.eln.ne.jp からどうぞ。
EarthLink Network は、会社の全業務を AI で回すために、必要になったものを自社で作っています。いま作っているプロダクトの一覧と概要は、こちらにまとめています。
→ EarthLink Network が自社でつくっている18のプロダクト
会社と各プロダクトの詳細は、公式サイト www.eln.ne.jp をご覧ください。